
MedFlow: framework de IA gera séries temporais médicas sintéticas com ganho de 5,8% em AUPRC
Novo framework de flow matching com consciência de classe promete melhorar modelos de predição clínica em datasets desbalanceados
O que aconteceu
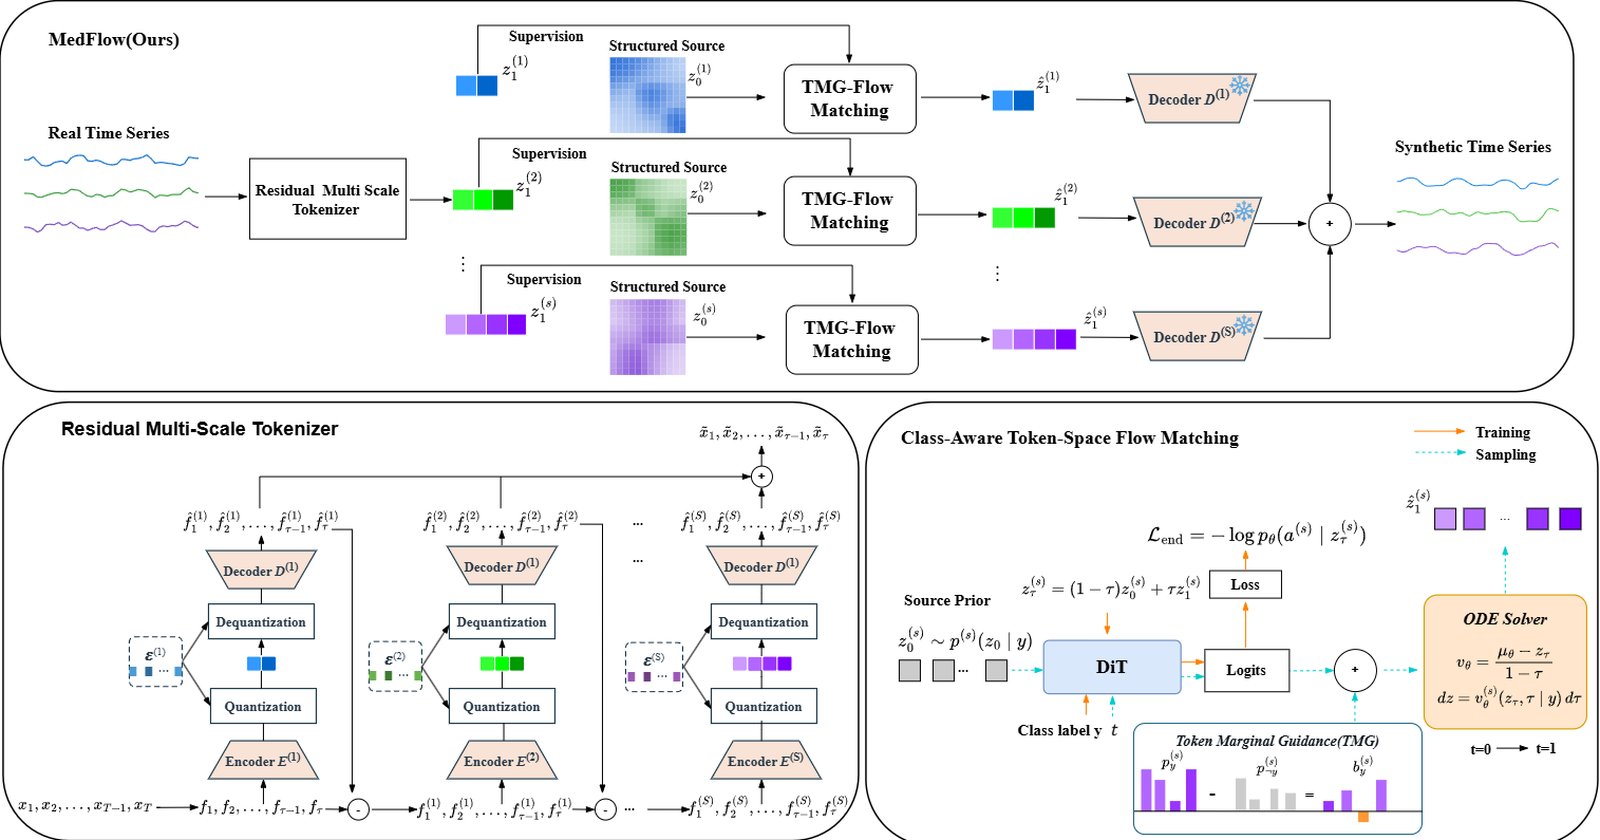
O MedFlow, framework de geração sintética de séries temporais médicas, foi submetido ao arXiv em 4 de setembro de 2026, sob o identificador 2609.04804v1, na categoria de Inteligência Artificial (cs.AI). O MedFlow é descrito por seus autores como um framework de flow matching com consciência de classe (class-aware) e múltiplas escalas para síntese de dados médicos.
Os números do artigo são específicos. Em experimentos com quatro datasets públicos, cobrindo prontuários eletrônicos de saúde (electronic health records), sinais de EEG e sinais de ECG, o MedFlow superou consistentemente baselines recentes de última geração baseados em difusão em tarefas de predição downstream. Na média, o framework melhora o AUPRC (Average Precision) em 5,8%, reduz o Context-FID em 88,6% e alcança throughput de amostragem 3,8 vezes maior que os métodos comparados.
Contexto
A geração de séries temporais médicas sintéticas existe para resolver um problema real: a escassez de dados clínicos dificulta o desenvolvimento de modelos de predição confiáveis. O problema é que os métodos existentes, segundo o artigo, focam principalmente em igualar a distribuição geral e a dinâmica temporal dos dados reais. Isso não garante boa utilidade downstream em datasets médicos desbalanceados.
Há dois desafios técnicos que o MedFlow ataca diretamente. Primeiro, padrões clinicamente informativos ocorrem em escalas temporais heterogêneas, o que exige representações em múltiplas resoluções. Segundo, características de classes minoritárias raras podem ser obscurecidas pelos padrões dominantes da população. Em dados médicos, essa segunda questão é crítica: justamente os casos raros, como doenças pouco frequentes, são os que mais interessam para predição.
Por que importa
O diferencial técnico do MedFlow está em duas inovações declaradas no artigo. A primeira é um tokenizer multi-escala com quantização vetorial (vector-quantized multi-scale tokenizer), que representa sequências médicas em resoluções temporais complementares, capturando tanto tendências clínicas gerais quanto dinâmicas de granularidade fina.
A segunda é o Token Marginal Guidance, mecanismo que incorpora estatísticas de tokens condicionadas por classe diretamente no processo de flow matching. Esse mecanismo direciona a geração para regiões específicas de classe nos tokens aprendidos. Na prática, o Token Marginal Guidance fortalece os padrões de classes minoritárias enquanto preserva as distribuições global e de cauda dos dados reais.
Para quem desenvolve modelos de predição clínica, isso significa dados sintéticos que não apenas parecem reais, mas que melhoram o desempenho do modelo final em classes raras. A métrica AUPRC, que subiu 5,8% na média dos experimentos, é justamente a referência padrão para avaliar desempenho em dados desbalanceados.
Impacto
Os ganhos medidos apontam para dois efeitos práticos. O primeiro é de qualidade: a redução de 88,6% no Context-FID indica que as séries geradas pelo MedFlow ficam muito mais próximas da distribuição dos dados reais do que as produzidas pelos baselines de difusão. O segundo é de eficiência: o throughput de amostragem 3,8 vezes maior reduz o custo computacional para produzir volumes grandes de dados sintéticos, o que importa quando o objetivo é aumentar datasets de treinamento inteiros.
A cobertura dos testes também pesa. Os quatro datasets públicos incluem prontuários eletrônicos, EEG e ECG, ou seja, o método foi validado em tipos de dados com estruturas temporais bastante diferentes entre si, e não em um único domínio.
O que muda
Para o campo de síntese de dados médicos, o resultado sugere uma mudança de foco. Em vez de medir apenas o quão bem os dados sintéticos imitam a distribuição global dos dados reais, a avaliação passa a considerar a utilidade downstream em cenários desbalanceados, onde classes minoritárias definem o valor clínico do modelo. O flow matching com guidance condicionado por classe, como proposto no MedFlow, aparece como alternativa aos métodos de difusão dominantes na área.
O que vem agora
O artigo está disponível no arXiv como preprint (2609.04804v1), com PDF e versão HTML experimentais abertos para leitura. Como o material não informa submissão a conferência ou journal, nem disponibilidade de código, o próximo passo natural é acompanhar a recepção da comunidade, citações e possíveis reprodutões independentes dos resultados nos quatro datasets públicos. O arXiv também lista ferramentas associadas, como alphaXiv e Connected Papers, para quem quiser rastrear a influência do trabalho.