
ε-MemEvo: memória entre tarefas acelera evolução de programas com LLMs
Framework transfere estratégias entre tarefas de otimização e melhora convergência sem custo relevante
O que aconteceu
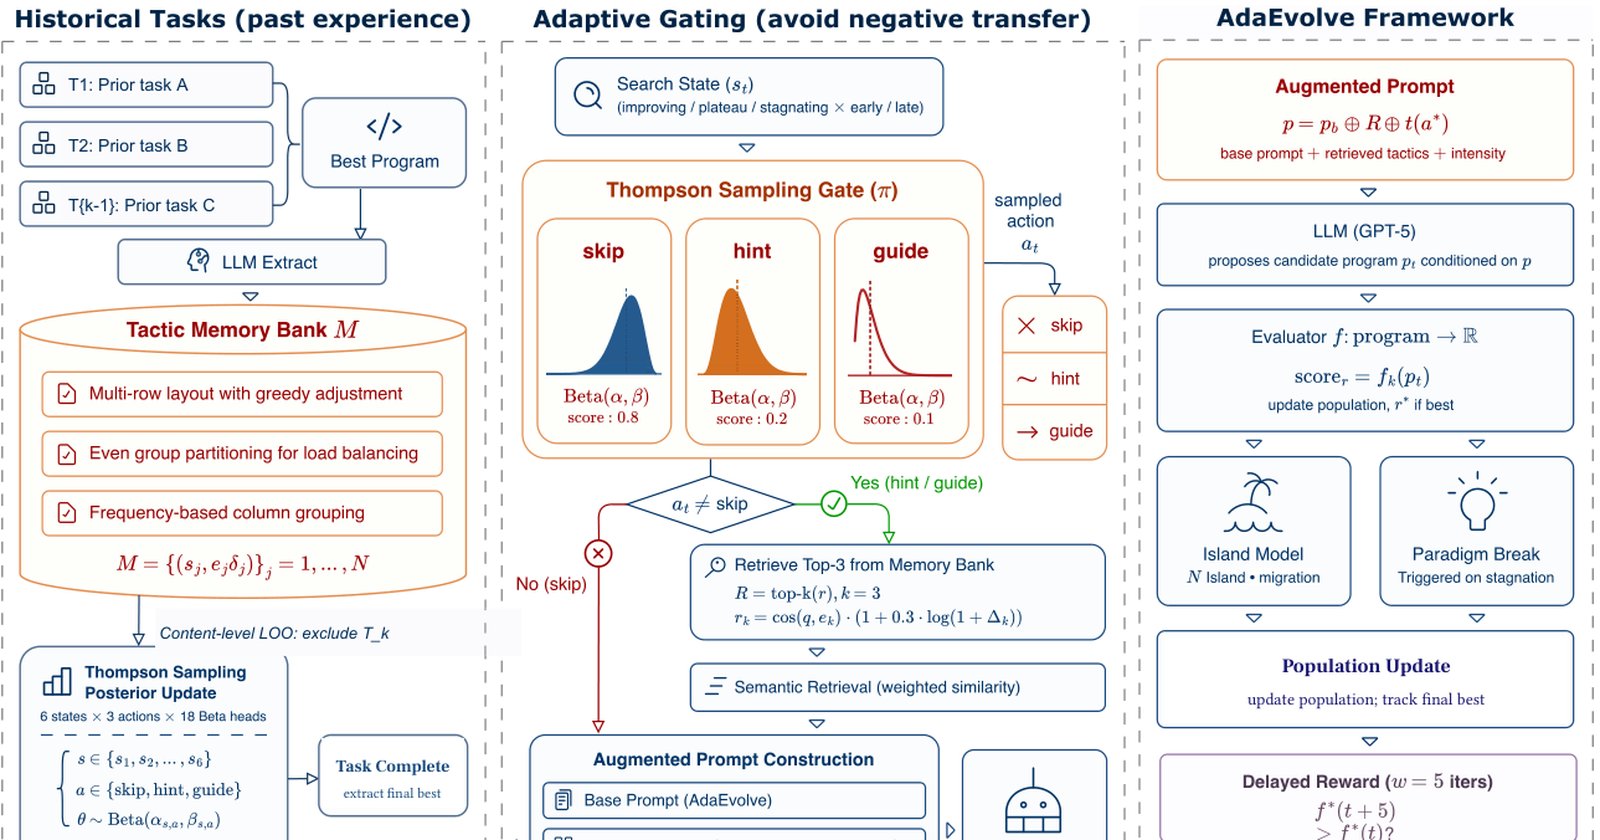
Um artigo científico submetido ao arXiv em 12 de agosto de 2026 (arXiv:2608.12522) descreve o ε-MemEvo, um framework para transferência de conhecimento entre tarefas em sistemas de evolução de programas baseados em LLMs. O método armazena experiências anteriores como "memórias de táticas" — resumos em linguagem natural de estratégias algorítmicas bem-sucedidas, em vez de código bruto — permitindo transferência entre tarefas com APIs e avaliadores diferentes.
Na avaliação com o backbone GPT-5, o ε-MemEvo melhorou a AUCC em todas as 8 tarefas de otimização testadas, com ganho médio relativo de +8,7% sobre o AdaEvolve. A convergência em estágio inicial também subiu, com +9,4% em média. Os resultados foram obtidos usando um protocolo Leave-One-Out em nível de conteúdo, que exclui entradas de memória da tarefa alvo.
Contexto
Sistemas como FunSearch e AlphaEvolve já demonstraram capacidade de descobrir algoritmos novos, mas tradicionalmente otimizam cada tarefa isoladamente, descartando a experiência de busca após a conclusão. O ε-MemEvo ataca exatamente essa limitação, propondo uma forma de reutilizar conhecimento entre tarefas.
O desafio central é evitar a transferência negativa — quando memórias semanticamente incompatíveis prejudicam o desempenho. Para isso, o framework usa um "portão de injeção adaptativo" que decide se as memórias recuperadas devem ser injetadas e com qual intensidade.
Por que importa
A abordagem reduz o desperdício de conhecimento em sistemas de evolução de programas. Em vez de cada nova tarefa começar do zero, o modelo pode aproveitar táticas que já funcionaram em problemas similares. Isso é relevante para áreas como otimização matemática e engenharia de sistemas, onde a busca por soluções é custosa.
Os experimentos mostram que a injeção ingênua de memórias pode falhar de forma catastrófica, enquanto o portão adaptativo permanece seguro em todas as cinco tarefas de ablação. O overhead de menos de 1% torna a técnica praticamente gratuita em termos computacionais.
Impacto
No curto prazo, o ε-MemEvo pode acelerar o desenvolvimento de algoritmos em domínios onde já existem bancos de experiências de tarefas anteriores. A interpretabilidade do portão — que favorece pular durante buscas em melhoria e muda de pular para dica em platôs — oferece insights sobre quando o conhecimento prévio ajuda ou atrapalha.
No médio prazo, a técnica pode ser combinada com outros avanços em LLMs para criar sistemas de evolução contínua, que acumulam conhecimento ao longo do tempo. Isso aproxima a IA de um comportamento mais próximo do aprendizado cumulativo humano.
O que muda
Para pesquisadores e empresas que usam LLMs para otimização, o ε-MemEvo oferece uma forma prática de reutilizar experiências sem reescrever código. A representação em linguagem natural das memórias facilita a transferência entre domínios diferentes, algo que abordagens baseadas em código bruto não conseguem.
A segurança do portão adaptativo é um ponto crítico: ele evita que memórias ruins atrapalhem o processo, algo que ablações mostraram ser um risco real.
O que vem agora
O artigo não detalha próximos passos, mas a tendência é que o framework seja testado em mais benchmarks e com outros backbones além do GPT-5. A integração com sistemas existentes como FunSearch e AlphaEvolve é um caminho natural. Também é provável que surjam variações que explorem diferentes estratégias de armazenamento e recuperação de memórias.
O código e os dados do estudo não foram liberados publicamente até o momento, mas a comunidade de IA deve acompanhar os desdobramentos.