
Mentalização em LLMs: estudo compara GPT-5, DeepSeek e Gemini
Comparação entre DeepSeek, GPT-4.1, GPT-5 e Gemini 2.0 Flash revela sinais de mentalização que variam por provedor e tamanho
O que aconteceu
Um estudo submetido ao arXiv em 26 de agosto de 2026, na área de inteligência artificial, investigou se modelos de linguagem de grande porte, os LLMs, conseguem usar a mentalização para orientar decisões adaptativas. A mentalização é a capacidade de inferir as crenças e intenções de outras pessoas para guiar as próprias escolhas, função central nas interações sociais humanas.
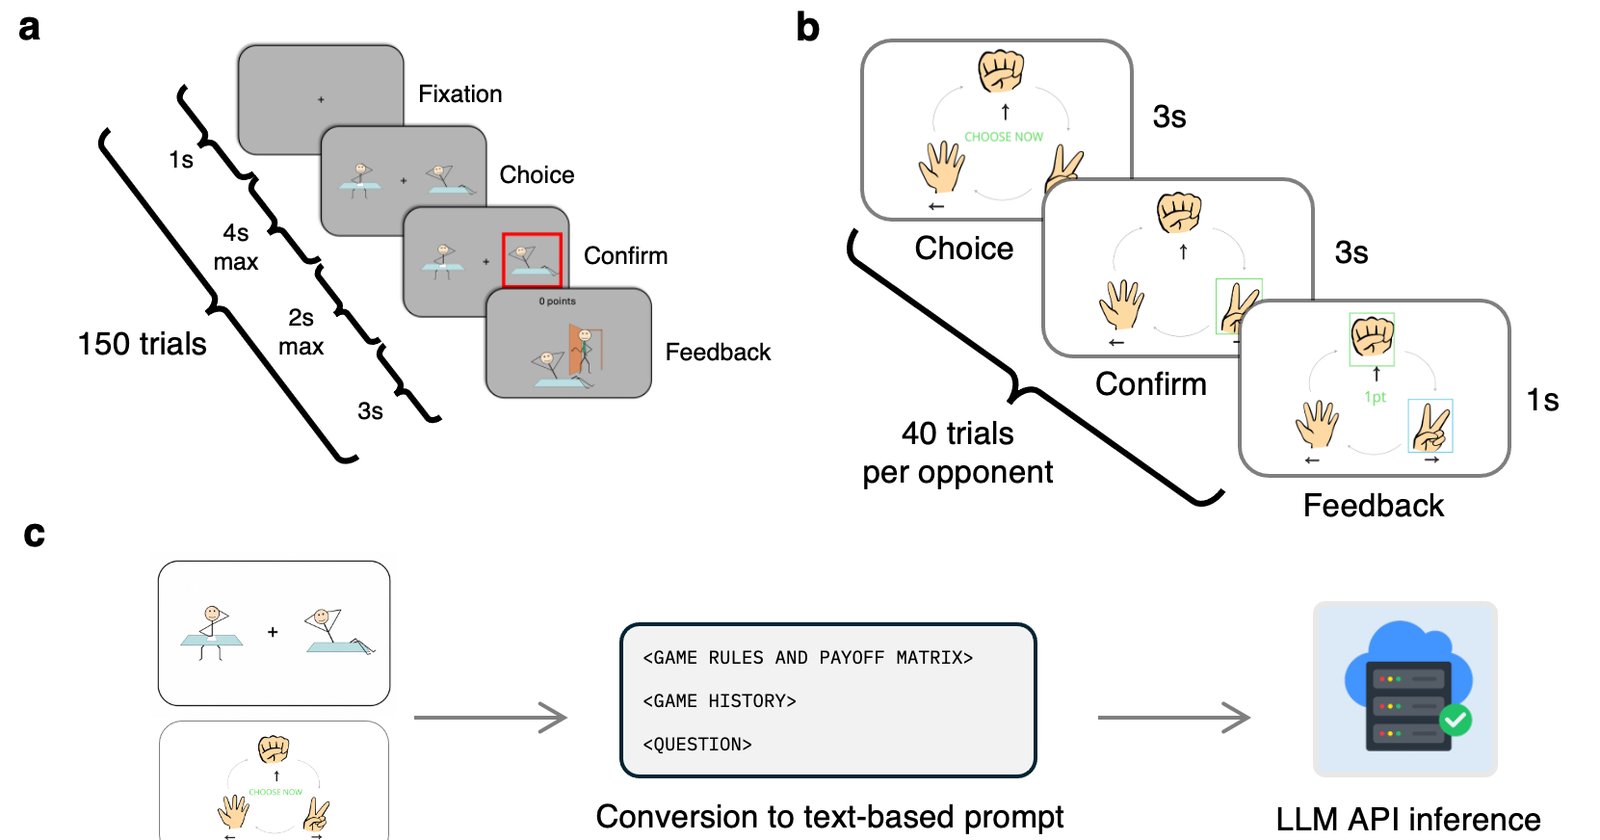
Os pesquisadores testaram agentes individuais de quatro famílias de modelos, DeepSeek, GPT-4.1, GPT-5 e Gemini 2.0 Flash, num total de 2.099 agentes. Cada agente disputou dois jogos econômicos contra oponentes de sofisticação variada, e a equipe usou modelagem computacional cognitiva para revelar as estratégias latentes por trás do comportamento. O desempenho foi comparado ao de 251 participantes humanos como medida de referência.
Nos dois jogos, os LLMs mostraram assinaturas comportamentais e computacionais claras de mentalização, com diferenças marcantes entre provedores e tamanhos de modelo. A pesquisa registrou que esses sinais variaram de forma acentuada por provedor e porte, colocando DeepSeek, GPT-4.1, GPT-5 e Gemini 2.0 Flash em posições distintas entre si. Um prompting estratégico, desenhado para estimular raciocínio estratégico, melhorou o desempenho na média ao induzir raciocínio mais sofisticado, mas o ganho variou entre as duas tarefas.
O GPT-5 se destacou entre as famílias. Os agentes GPT-5 adaptaram de forma flexível a profundidade recursiva do raciocínio conforme enfrentavam oponentes mais sofisticados, e demonstraram desempenho superior aos participantes humanos. O estudo, hospedado no arXiv sob o número 2608.26291, conclui que há capacidades distintas de mentalização entre os LLMs analisados.
Contexto
A teoria da mente, parente próxima da mentalização, já era alvo de testes em LLMs. Estudos anteriores mostraram que os modelos se comportam de forma consistente com humanos em tarefas de teoria da mente, mas permanecia em aberto se esse comportamento se traduzia em decisões adaptativas reais. O novo trabalho avança ao combinar jogos econômicos com modelagem computacional, método tradicionalmente usado em psicologia cognitiva para inferir processos internos a partir de escolhas observadas.
Por que importa
A diferença entre saber e usar a teoria da mente tem peso prático. Um modelo capaz de mentalizar pode antecipar o comportamento de um usuário, de um concorrente ou de outro sistema, e ajustar a própria estratégia em negociações, atendimento e automação de decisões. A pesquisa mostra que essa capacidade não é uniforme: ela varia por provedor e por tamanho, e pode ser ampliada com a instrução certa no prompt.
O resultado também aproxima a avaliação de IA dos métodos usados para medir inteligência humana. Em vez de depender apenas da acurácia de respostas, a modelagem computacional cognitiva permite comparar, formalmente, humanos e máquinas na mesma escala.
Impacto
No curto prazo, o estudo oferece um parâmetro para quem escolhe modelos em tarefas que exigem negociação ou previsão de comportamento. O GPT-5 mostrou capacidade de ajustar a profundidade do raciocínio ao nível do oponente, traço associado a desempenho superior nos jogos. Já o prompting estratégico apareceu como alavanca barata de melhoria, ainda que com efeito desigual entre tarefas.
No médio prazo, a abordagem pode virar referência para benchmarks de raciocínio social. A comparação com 251 humanos cria uma base mensurável, algo raro em avaliações de LLMs centradas apenas em respostas corretas.
O que vem agora
Os autores indicam a modelagem computacional cognitiva como método formal para avaliar inteligência comparativa entre humanos e máquinas, o que sugere novos estudos com outras famílias de modelos e jogos mais complexos. Cabe acompanhar se os próximos lançamentos, tanto das famílias testadas quanto de novos modelos, reproduzem a flexibilidade de raciocínio vista no GPT-5.
Fontes
arXiv cs.AI. "Assessing mentalization in humans and large language models" (arXiv:2608.26291). Disponível em: https://arxiv.org/abs/2608.26291