
Monitor de IA fica mais rejeitivo, não mais preciso, ao revisar mais ações
Pesquisa mede pela primeira vez o efeito da unidade de verificação em monitores de LLM e aponta janela ideal
O que aconteceu
O artigo arXiv:2608.23941, intitulado "More Rejective, Not More Discriminative: The Unit of Verification in Pre-Execution LLM Oversight", foi submetido ao repositório em 25 de agosto de 2026. A pesquisa, da área de Inteligência Artificial, ataca um problema central no controle de agentes de IA: a supervisão pré-execução, em que um monitor baseado em LLM avalia ações planejadas antes de elas serem executadas de forma irreversível.
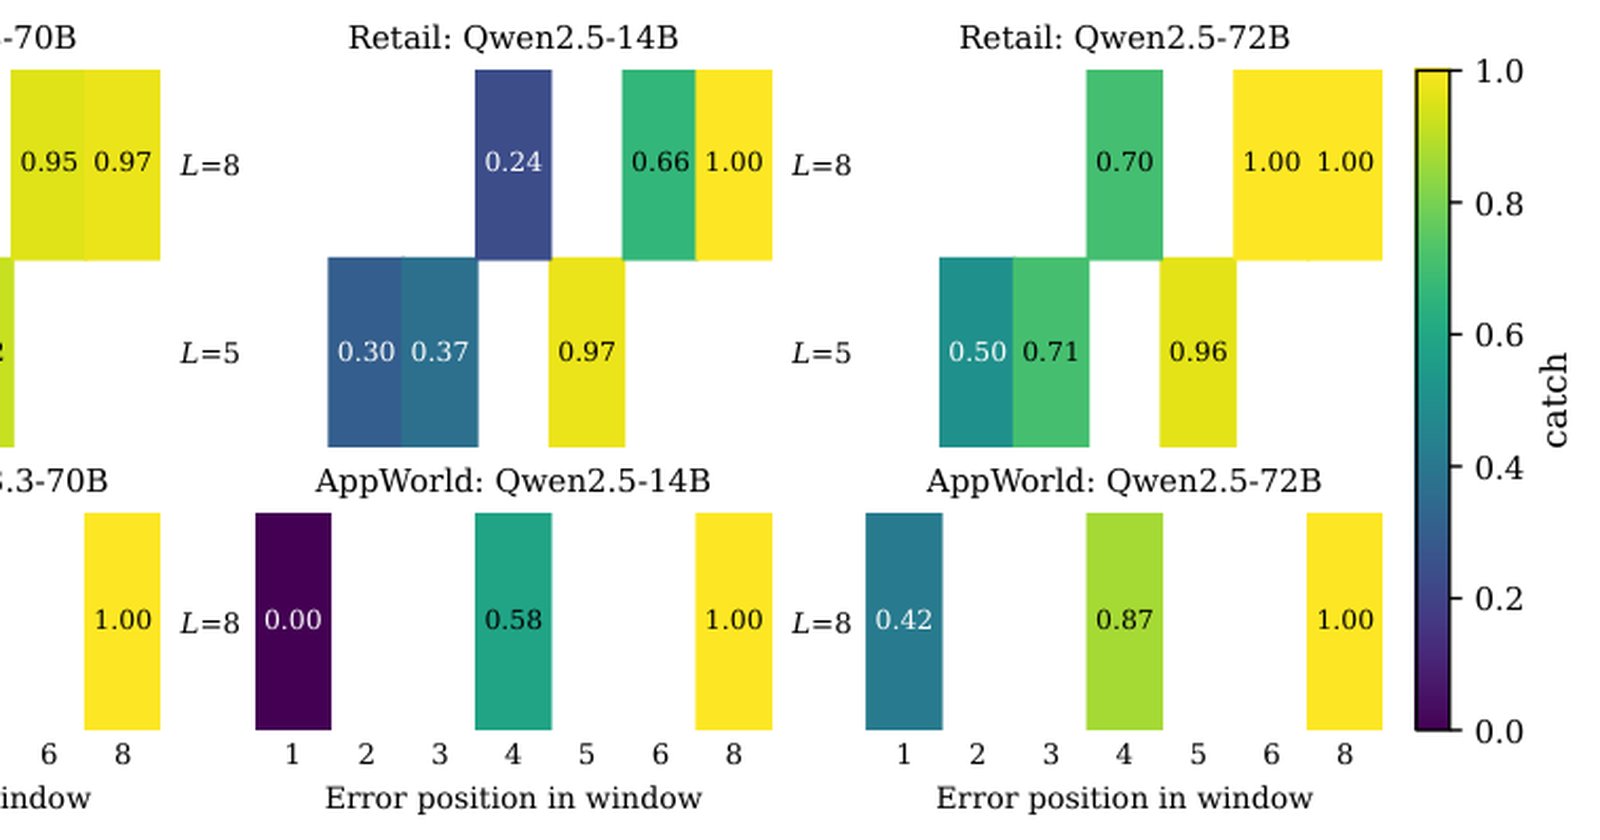
O estudo introduz o conceito de unidade de verificação, ou seja, quantas ações uma única chamada de revisão analisa. Os autores criaram o framework twin-prefix para isolar o efeito dessa unidade. Cada plano de referência gera um prefixo com um erro injetado e aceito pelo ambiente, além de um gêmeo limpo que difere em apenas um registro. Os pares são julgados em cinco comprimentos aninhados, o que liga as mudanças de veredito à unidade de verificação.
A discriminação foi medida por informedness pré-registrada, definida como a taxa de captura menos a taxa de falsa rejeição. O resultado: em seis juízes e dois domínios, o informedness atingiu o pico em uma ou duas ações. Janelas mais longas aumentaram a captura de erros, mas a falsa rejeição cresceu no mesmo ritmo. O framework twin-prefix, apresentado no estudo arXiv:2608.23941, mostrou que janelas de revisão mais longas tornam monitores zero-shot mais rejeitivos, não mais discriminativos.
Contexto
A supervisão pré-execução é considerada essencial para o monitoramento confiável de agentes de IA. Um monitor falível, porém, bloqueia demais e perde utilidade, o que pressiona os implantadores a desativá-lo. A unidade de verificação é uma escolha que todo protocolo precisa fazer, mas o material mostra que os designs existentes tratam essa unidade como dada, sem medir seu efeito em monitores falíveis.
Trilhas naturais não conseguem isolar o fator, porque o comprimento da revisão varia junto com o tipo de erro e a posição. Além disso, a métrica de captura sozinha engana, já que rejeitar tudo captura tudo. O estudo preenche essa lacuna ao variar apenas a fronteira da revisão e incluir um controle limpo pareado.
Por que importa
A pesquisa tem implicações diretas para quem projeta sistemas de controle de IA em produção. Se um desenvolvedor aumenta a janela de revisão esperando melhorar a precisão do monitor, o efeito real é o oposto: o sistema fica mais propenso a bloquear ações legítimas, sem ganho proporcional de discriminação.
A constatação de que o informedness pico ocorre em uma ou duas ações sugere que janelas curtas são mais equilibradas. O estudo relata que a unidade curta calibrada recupera até 0,95 de informedness em comparação com uma revisão de oito ações. Nenhuma política testada que ignore rótulos superou essa abordagem de forma consistente.
Impacto
No curto prazo, o framework twin-prefix oferece um instrumento controlado e pré-registrado para escolher a unidade de verificação, algo inédito no campo. Os autores afirmam que o instrumento nunca lê a captura sozinha, o que evita conclusões enganosas.
A análise de observações retidas mostrou que a falha em janelas longas se deve em grande parte à privação de observação, ou seja, o monitor perde informações relevantes ao processar muitas ações de uma vez. Isso aponta para um trade-off prático: revisões mais longas podem ser mais baratas computacionalmente, mas custam precisão de discriminação.
O que muda
Os safety cases, documentos que justificam a segurança de um sistema, devem declarar explicitamente a unidade de verificação usada e co-relatar a série limpa de resultados. O estudo indica que relatar apenas a captura de erros é insuficiente e pode esconder uma taxa alta de falsa rejeição.
Para a comunidade de IA, a mensagem é clara: escolher o número de ações por chamada de monitor não é um detalhe de implementação. É uma decisão de design com impacto mensurável na qualidade da supervisão.
O que vem agora
Os autores não especificam prazos para próximas etapas, mas o framework está descrito como o primeiro instrumento controlado e pré-registrado para essa escolha. A expectativa é que outros grupos repliquem os experimentos em mais domínios e com outros modelos de LLM.
Também fica aberta a questão de como janelas dinâmicas, que se ajustam ao contexto da ação, se comparam às unidades fixas testadas. O estudo atual testou seis juízes em dois domínios, e a generalização para modelos maiores e tarefas mais complexas ainda precisa de verificação.
FONTES:
- arXiv cs.AI, "More Rejective, Not More Discriminative: The Unit of Verification in Pre-Execution LLM Oversight" (arXiv:2608.23941v1) - https://arxiv.org/abs/2608.23941