
Mr.LHDR: benchmark testa agentes de deep research de longo prazo
Mr.LHDR mede pesquisa profunda multimodal e mostra que acerto na resposta final não prova raciocínio correto
O que aconteceu
Pesquisadores publicaram no arXiv em 10 de setembro de 2026 o Mr.LHDR, um benchmark para avaliar agentes de deep research em cadeias longas e irredutíveis de evidências interdependentes. O Mr.LHDR, sigla de Multimodal real-world Long-Horizon Deep Research, está registrado no arXiv sob o identificador 2609.11318v1, na área de Computer Science, com classificação em Artificial Intelligence (arXiv cs.AI).
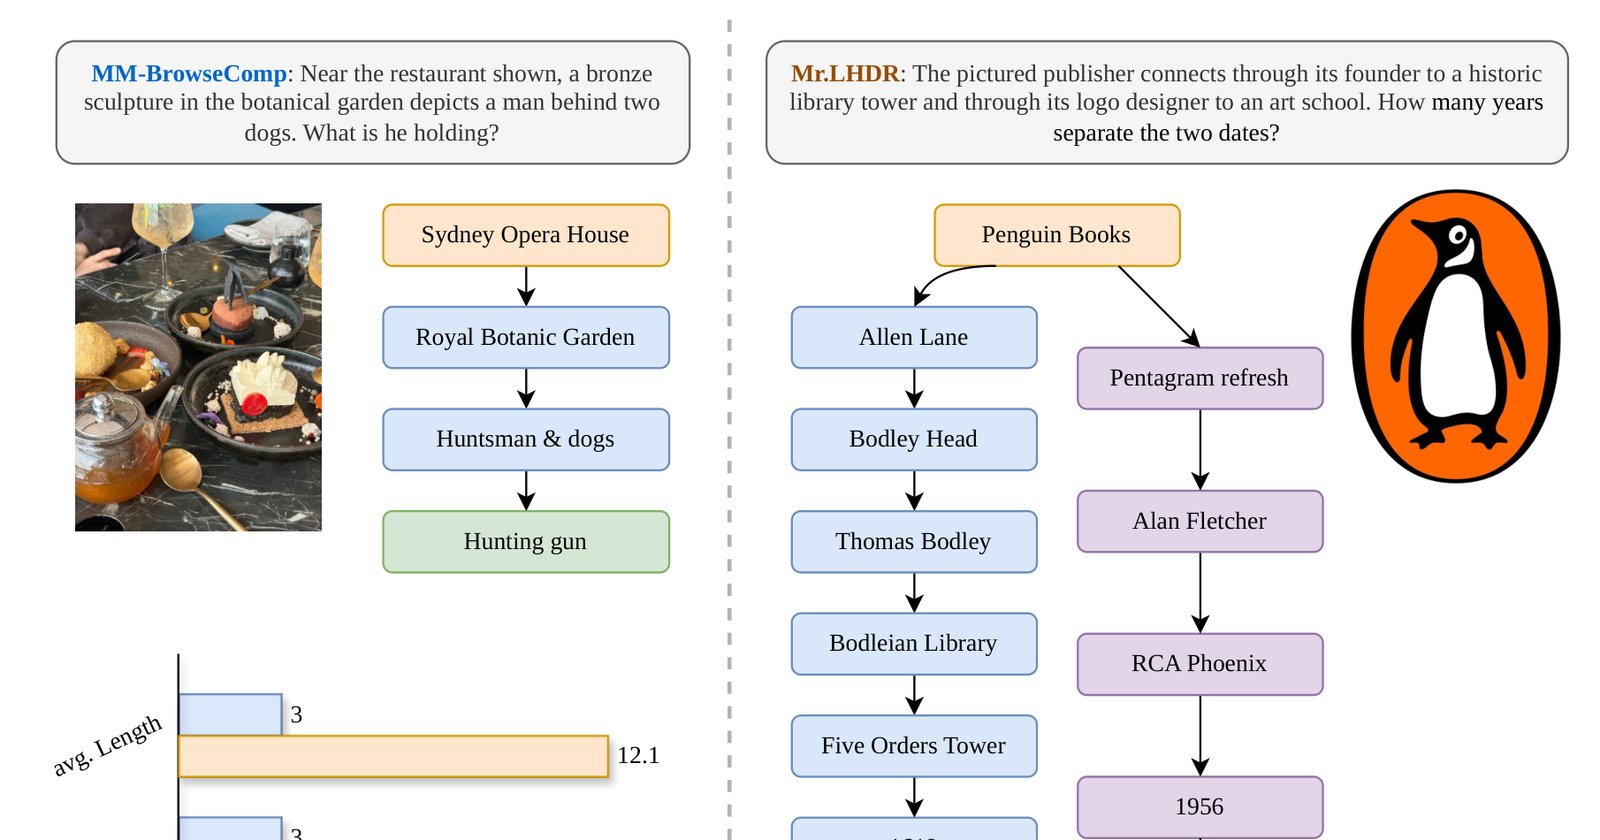
A construção das perguntas é o ponto central do benchmark. Cada questão do Mr.LHDR nasce de um grafo oculto de nós e relações, o Node-Relation graph, e exige em média 12,1 conclusões intermediárias necessárias antes de se chegar a uma resposta curta, única e verificável. A profundidade média de dependência é de 10,4. Isso significa que o benchmark não mede uma busca isolada por um fato, e sim uma corrente em que cada elo depende do anterior. As questões estão distribuídas em oito categorias.
As perguntas do Mr.LHDR incorporam evidência multimodal: imagens, mapas, PDFs, logos, gráficos, tabelas e quadros de vídeo. Cada questão traz pelo menos um elemento não textual que muda o estado de raciocínio. Na prática, ignorar a imagem, o mapa ou a tabela empurra o agente para um caminho errado, mesmo que ele saiba buscar texto bem.
O benchmark avalia tanto a resposta final quanto a correção das conclusões intermediárias, sob dependências anotadas. Foram testados modelos de uso geral, sistemas de deep research e frameworks de agentes, com quatro métricas: Overall Accuracy (OA), Strict Accuracy (SA), Checklist Score (CS) e Dependency-Aware Checklist Score (DACS).
O resultado é duro para a indústria. O sistema mais forte alcançou apenas 43,1% de OA e 34,3% de SA. Remover as imagens derruba o DACS em 12,6 pontos. A acurácia estrita (SA) cai de forma consistente conforme as cadeias de raciocínio ficam mais longas.
Contexto
Os benchmarks existentes avaliam principalmente exploração de horizonte médio. Raramente testam se um agente consegue sustentar processos de pesquisa longos e carregados de dependências. O Mr.LHDR foi desenhado exatamente para cobrir essa lacuna: um benchmark de pesquisa profunda de mundo real, com cadeias irreduzíveis de evidência interdependente.
A escolha metodológica acompanha esse objetivo. Em vez de premiar só a resposta final, o Mr.LHDR verifica a correção das conclusões intermediárias usando dependências anotadas. É uma mudança de régua. O benchmark deixa de perguntar apenas se o agente chegou à resposta certa e passa a perguntar se ele chegou lá pelo caminho certo.
Por que importa
A distância entre 43,1% de OA e 34,3% de SA é o dado mais revelador do artigo. Segundo os autores, a acurácia da resposta final superestima substancialmente o sucesso completo da pesquisa. Um agente pode acertar o número final e ainda assim ter errado várias conclusões pelo caminho, o que quebra a confiabilidade do resultado em qualquer uso real.
O achado sobre multimodalidade reforça o mesmo ponto. Quando as imagens são removidas do Mr.LHDR, o DACS cai 12,6 pontos, o que demonstra o peso da evidência visual na cadeia de raciocínio. Para quem constrói produtos de pesquisa com IA, isso quer dizer que pipelines puramente textuais perdem desempenho justamente nos casos mais difíceis.
Impacto
O Mr.LHDR aponta o gargalo atual dos agentes de deep research: integração sustentada e consistente de evidências ao longo de dependências, e não recuperação isolada de fatos. O diagnóstico vale para assistentes jurídicos, análise financeira, revisão técnica de documentos e qualquer fluxo que exija juntar dezenas de peças antes de concluir algo.
A queda contínua do SA conforme as cadeias crescem também indica um limite prático de escala. Sistemas que funcionam bem em tarefas de poucos passos tendem a degradar quando a profundidade de dependência se aproxima da média de 10,4 medida pelo Mr.LHDR. O erro se acumula a cada elo.
O que muda
A adoção de quatro métricas, em especial o Checklist Score e o Dependency-Aware Checklist Score, desloca a avaliação de agentes para o processo, não só para o resultado. Times que hoje reportam acurácia de resposta final passam a ter uma alternativa para medir se as conclusões intermediárias estavam corretas sob as dependências anotadas.
O Mr.LHDR também coloca a evidência multimodal no centro da avaliação. Cada pergunta do benchmark exige pelo menos um elemento não textual que altera o estado de raciocínio, o que torna difícil reivindicar bom desempenho em pesquisa profunda sem tratar imagens, mapas, tabelas e quadros de vídeo como parte da cadeia, e não como anexo decorativo.
O que vem agora
O artigo do Mr.LHDR está disponível no arXiv (arXiv:2609.11318v1), submetido em 10 de setembro de 2026, e descreve a metodologia completa do benchmark, as oito categorias de questões e as métricas de avaliação. O material não detalha cronograma de atualizações nem planos de expansão do conjunto de testes.
O caminho indicado pelos próprios resultados é claro. Se a integração de evidências dependência por dependência é o gargalo, o próximo ciclo de desenvolvimento de agentes de deep research deve mirar exatamente esse ponto, com atenção especial ao desempenho em cadeias longas e à presença de elementos visuais que mudam o raciocínio.
Fontes
arXiv cs.AI: Mr.LHDR: A Benchmark for Multimodal Real-World Long-Horizon Deep Research Agents (https://arxiv.org/abs/2609.11318)