
Multi-Harness RL: estudo mostra que ambiente de avaliação pesa mais que a receita de treino
Paper no arXiv testa GRPO com agrupamento Within e Cross e conclui que a regra de agrupamento quase não altera a taxa de resolução
O que aconteceu
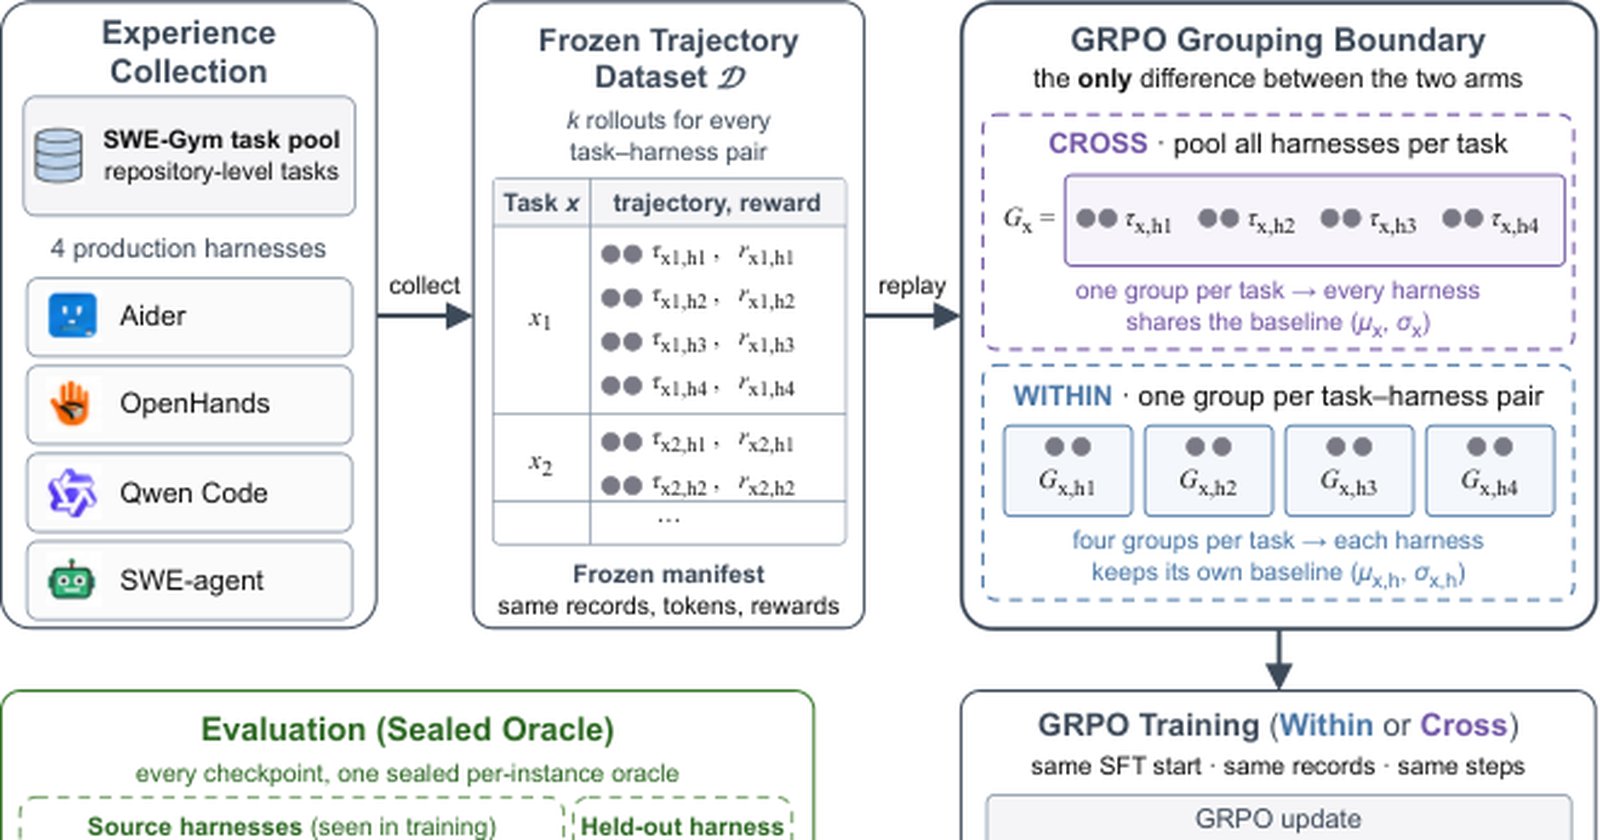
O paper "What Does Multi-Harness RL Learn? Credit Assignment and Portability in Coding Agents" (arXiv:2609.04518v1), submetido em 3 de setembro de 2026, investiga uma escolha específica no treinamento por reforço (RL) de agentes de programação: comparar recompensas de harnesses diferentes dentro de um mesmo grupo de vantagem relativa.
Os autores partiram de um único warm start supervisionado do Qwen3-8B e reproduziram os mesmos registros congelados de tarefa-harness de quatro ferramentas: Aider, OpenHands, Qwen Code e SWE-agent, com o mesmo número de atualizações. Compararam duas regras de group-relative policy optimization (GRPO): Within, com um grupo por par tarefa-harness, e Cross, com harnesses agrupados dentro de cada tarefa.
Cada checkpoint foi avaliado com um oráculo selado do SWE-bench Verified nos quatro harnesses de origem e em um harness mínimo mantido fora do treino. Foram 24.000 avaliações seladas no total.
O resultado central: o harness de avaliação é a variável dominante. Ele move a taxa média de resolução de 2,14% a 9,27%, um fator de 4,3. A receita de treino move o resultado por apenas 1,16 ponto. A regra de agrupamento, que era a hipótese em teste, não importa.
Contexto
O RL de agentes cada vez mais roda através de harnesses de execução completos, que definem como o modelo interage com o repositório, quais ferramentas usa e como as ações são formatadas. A receita multi-harness mistura duas decisões: expor a política a vários harnesses e comparar suas recompensas dentro de um grupo de vantagem relativa.
A esperança implícita da comunidade era que o crédito cruzado entre harnesses (a regra Cross) ensinasse algo geral sobre a tarefa, e não apenas sobre a configuração específica de execução. O paper isola exatamente a segunda escolha para testar essa expectativa.
Por que importa
No harness reservado (held-out), a diferença Cross menos Within foi de +0,25 ponto percentual, com intervalo de confiança de 95% de [-0,48, +1,02] a oito tentativas por tarefa. Somando três seeds de treino, a diferença cai para +0,16 [-0,41, +0,72], e as estimativas individuais mudam de sinal. A faixa de cada regra entre seeds, de 0,42 a 0,45 pp, é maior que a diferença entre elas.
Ou seja: o ganho aparente do agrupamento cruzado é ruído estatístico. Para laboratórios e equipes que investem em RL multi-harness, o paper sugere que o esforço extra de comparar harnesses dentro do mesmo grupo não compra capacidade portável.
Impacto
A evidência mais reveladora vem de um classificador out-of-fold: a partir da vantagem produzida pela regra Cross, ele recupera o harness gerador com +4,48 pp acima da linha de base de rótulos embaralhados. Com a regra Within, a recuperação não acontece. Isso significa que a vantagem agrupada carrega a assinatura do harness, não da tarefa.
As duas regras ainda alcançam a mesma pontuação no harness held-out e a mesma distribuição de ações dentro de cada harness. Re-coletar metade dos dados de treino on-policy não muda o quadro. A conclusão dos autores: crédito cruzado entre harnesses produz adaptação de configuração, não capacidade mais portável.
O que muda
Para quem treina agentes de código com GRPO, o paper propõe duas mudanças de prática. Primeiro, relatórios de RL multi-harness devem declarar explicitamente o limite de agrupamento (grouping boundary). Segundo, toda avaliação deve incluir um harness não visto no treino, sem o qual os ganhos podem ser apenas ajustes à configuração de execução.
O dado de que o harness de avaliação move o resultado em um fator de 4,3 também serve de alerta para benchmarks: comparar modelos sem fixar o harness pode produzir diferenças maiores que qualquer decisão de treino.
O que vem agora
O paper está disponível no arXiv (arXiv:2609.04518) com PDF e versão HTML experimental, além de ferramentas de citação e integrações como Connected Papers, Litmaps e scite. A recomendação prática para a área é adotar o protocolo proposto: declarar o agrupamento e testar sob um harness inédito. Estudos futuros de RL para agentes de código deverão, no mínimo, justificar por que sua regra de agrupamento supera o intervalo de ruído de 0,42 a 0,45 pp observado entre seeds.