
NIFS: método para steering de LLMs usa similaridade entre features
Pesquisadores propõem seleção de features baseada em vizinhos representacionais para melhorar o controle de modelos de linguagem.
O que aconteceu
No dia 28 de agosto de 2026, foi submetido à plataforma arXiv o artigo científico intitulado "Enhancing SAE-based Steering via Neighbor Integrated Feature Selection", disponível sob o identificador arXiv:2608.28806. O trabalho propõe uma nova estratégia chamada Neighbor Integrated Feature Selection (NIFS) para melhorar o steering de grandes modelos de linguagem (LLMs) usando sparse autoencoders (SAEs). O NIFS é descrito como uma estratégia plug-and-play que utiliza a similaridade entre representações para selecionar features mais eficazes.
A pesquisa parte de uma constatação: os métodos atuais de steering baseados em SAEs selecionam features aplicando um filtro top-k baseado em scores estatísticos, assumindo que features com maior score produzem efeitos de steering mais fortes. Os autores demonstram que essa suposição frequentemente é inválida, levando a uma seleção subótima de features.
A análise do grupo revela que features eficazes para steering podem estar distribuídas entre grupos semânticamente similares e representacionalmente adjacentes, um fenômeno induzido pelo que eles chamam de feature splitting nos SAEs. Dentro desses grupos, features com scores estatísticos bastante diferentes podem ter influência de steering comparável, o que faz com que a seleção por score ignore features importantes.
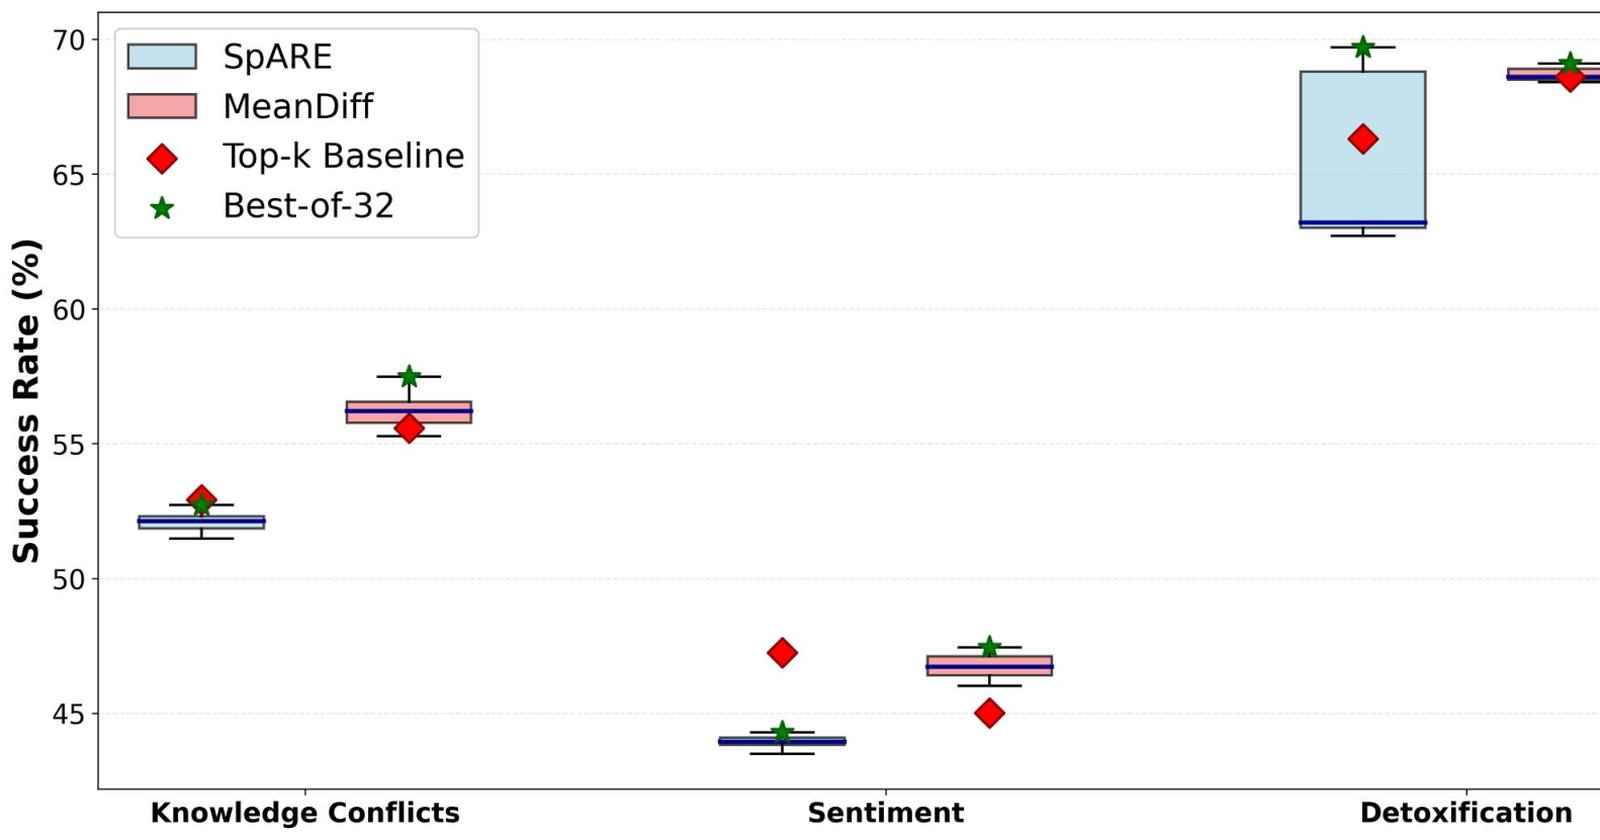
Para validar a proposta, os pesquisadores avaliaram o NIFS em múltiplos métodos de steering baseados em SAE e em diversas tarefas. Em todos os cenários testados, o NIFS apresentou ganhos consistentes de desempenho em comparação com a seleção convencional top-k.
Contexto
O steering de modelos de linguagem é uma técnica que visa controlar o comportamento do modelo durante a geração, ativando ou suprimindo features interpretáveis internas. Sparse autoencoders (SAEs) são amplamente utilizados para esse fim, pois conseguem decompor as ativações internas dos modelos em features interpretáveis.
O artigo se insere em uma linha de pesquisa que busca melhorar a interpretabilidade de LLMs. A abordagem tradicional de seleção de features por score estatístico, como o top-k, parte do princípio de que a importância de uma feature é diretamente proporcional ao seu score. No entanto, o estudo mostra que essa relação nem sempre se sustenta, especialmente quando há feature splitting.
O feature splitting é um fenômeno conhecido em SAEs, no qual uma mesma feature conceitual acaba sendo dividida em múltiplas features representacionalmente próximas. Isso ocorre porque o autoencoder esparso pode não aprender uma representação totalmente fatorizada, criando duplicatas parciais que dificultam a seleção por score.
Por que importa
A melhoria no steering de LLMs tem impacto direto em aplicações práticas que dependem de controle fino de comportamento, como moderação de conteúdo, personalização de respostas e alinhamento de modelos. Uma seleção de features mais precisa pode reduzir custos computacionais e melhorar a eficácia de técnicas de intervenção em modelos.
Para pesquisadores e engenheiros de IA, o NIFS oferece uma alternativa simples e eficaz ao top-k, sem a necessidade de re-treinar os autoencoders. Como é uma estratégia plug-and-play, pode ser incorporada a pipelines existentes com baixo esforço de adaptação.
O estudo também questiona premissas consolidadas na área de interpretabilidade de modelos. Ao mostrar que scores estatísticos podem não refletir a influência real das features, ele abre caminho para novas investigações sobre como medir a importância de features em SAEs.
Impacto
Em curto prazo, a proposta pode ser adotada por laboratórios de pesquisa em interpretabilidade e por empresas que usam steering em produção. O fato de o NIFS ser agnóstico ao método de steering baseado em SAE aumenta sua aplicabilidade: pode ser usado com diferentes arquiteturas de autoencoder e em diferentes tarefas.
A demonstração de ganhos consistentes sobre o top-k em múltiplas tarefas sugere que o método é robusto e não depende de um domínio específico. Isso tende a acelerar sua adoção em benchmarks de interpretabilidade.
Em médio prazo, a pesquisa pode influenciar o design de novos SAEs. Se a seleção por score é insuficiente, talvez a própria estrutura dos autoencoders deva ser repensada para evitar feature splitting, ou para facilitar a seleção baseada em vizinhança.
O que muda
A principal mudança é a forma como features são escolhidas para steering. Em vez de apenas ordenar por score estatístico, o NIFS incorpora a similaridade representacional entre features, permitindo que features com score inferior, mas com influência comparável, sejam consideradas.
Isso afeta tanto a eficácia quanto a eficiência do steering. Empiricamente, os autores observaram ganhos consistentes, o que indica que o custo adicional de calcular similaridades vale a pena em termos de qualidade do controle de geração.
O que vem agora
O artigo foi disponibilizado na arXiv e está em processo de revisão por pares, ainda sem confirmação de publicação em conferência. O código e os dados associados ainda não foram liberados, mas os autores sinalizam que os experimentos foram conduzidos em múltiplas tarefas e métodos.
A expectativa é que a comunidade de interpretabilidade teste o NIFS em novos cenários e que pesquisas complementares explorem formas de integrar a similaridade de vizinhança diretamente ao treinamento dos SAEs. Também é provável que surjam variações do método, como o uso de métricas de similaridade diferentes da cosseno, que é comum em representações de ativações.