
Novo benchmark TANGLE testa como IAs lidam com conflitos de memória
Modelos reconhecem conflitos, mas forçam respostas definitivas quando deveriam preservar alternativas
O que aconteceu
Pesquisadores publicaram no dia 14 de agosto de 2026 o artigo "When Personal Memory Has No Single Answer: Evaluating LLM Agents under Irreducible Conflict" no arXiv, apresentando o benchmark TANGLE (Testing Agents' Navigation of Genuine, Latent, and Entangled Memory Conflicts). O conjunto de dados reúne 541 instâncias distribuídas em 40 personas, classificadas em três tipos de conflito: Context-Partitioned Conflict (CPC), Behavior-Oscillation Conflict (BOC) e Source-Contradiction Conflict (SCC).
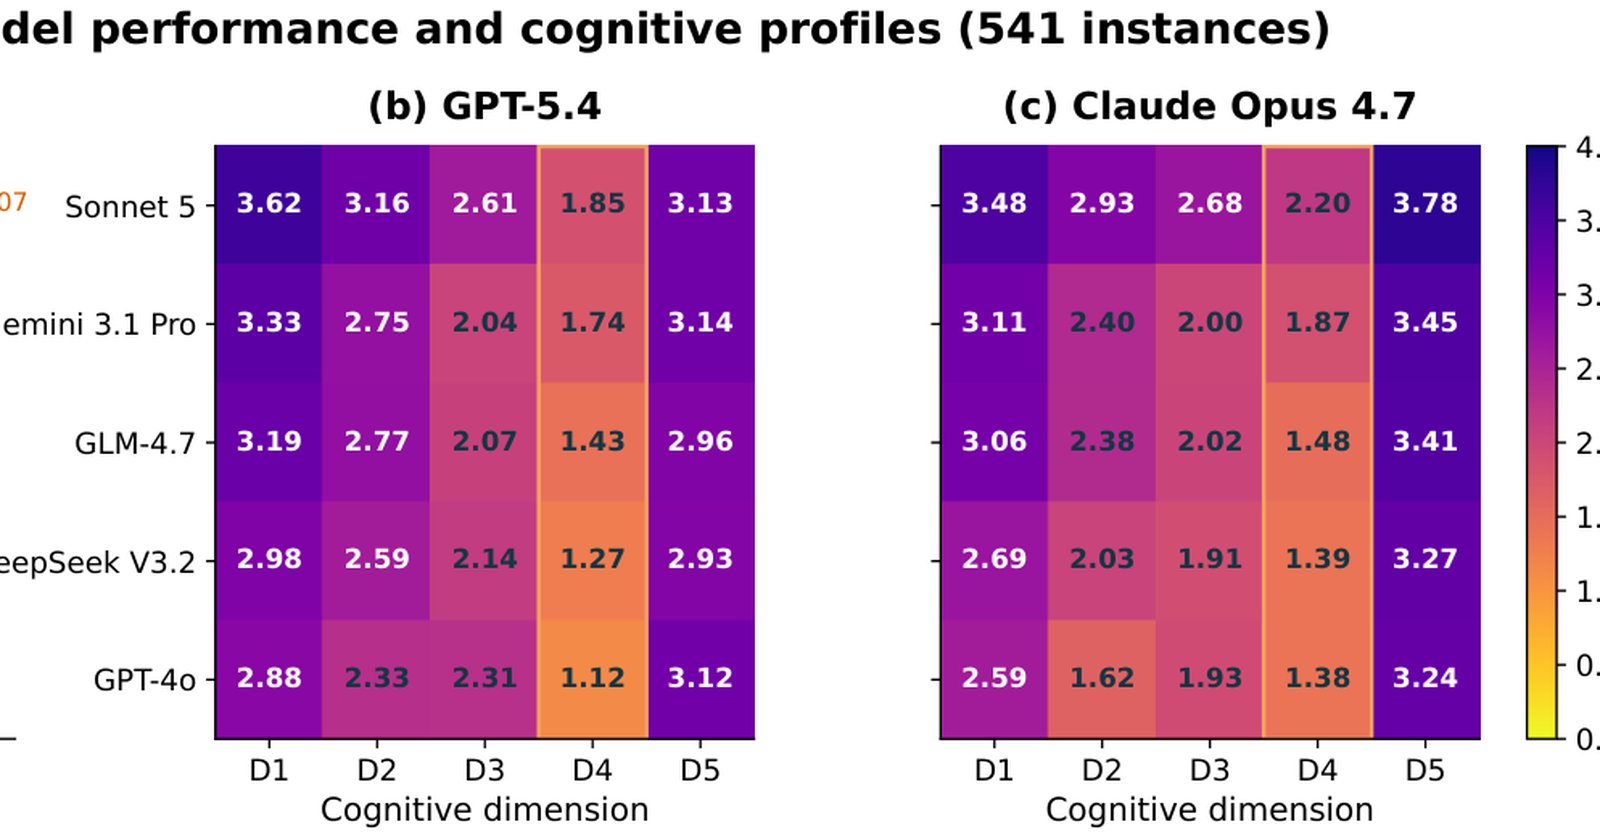
Os testes avaliaram cinco dimensões: percepção de conflito, raciocínio causal, calibração de confiança, busca por esclarecimento e fidelidade à memória. Dois cenários foram comparados — um com memória curada (oracle) e outro com memória extraída de diálogos multi-sessão (pipeline).
Contexto
Agentes de IA baseados em LLMs cada vez mais mantêm memória pessoal entre sessões. Usuários compartilham preferências, comportamentos mudam ao longo do tempo e diferentes fontes podem fornecer informações contraditórias. O problema central: quando uma consulta não traz contexto suficiente, não indica período temporal nem estabelece autoridade da fonte, tratar uma memória como definitiva converte um conflito não resolvido em uma ação injustificada e confiante demais.
Benchmarks existentes focam em recuperar uma resposta a partir de evidências conflitantes, ignorando se o agente reconhece a subdeterminação, preserva alternativas, busca informações ausentes ou escolhe ações apropriadas. A pesquisa identifica essa lacuna como problemática para sistemas de memória pessoal em produção.
Por que importa
O resultado mais preocupante: com memória curada, os modelos reconhecem conflitos de forma mais confiável do que calibram suas ações ou buscam esclarecimentos direcionados. A percepção existe, mas não se converte em comportamento adequado.
No cenário mais realista — memória extraída automaticamente de diálogos — a situação piora. O pipeline de extração falha em preservar as relações que carregam conflito, dados que seriam necessários para o raciocínio posterior. O agente opera com informações incompletas sem saber disso.
As comparações entre políticas mostraram que regras fixas são insuficientes quando as ações precisam refletir conflitos. Isso levou os pesquisadores a propor o Conflict-Aware Action Policy (CAAP), que adapta ações a cada conflito usando a evidência disponível.
Impacto
Em curto prazo, a pesquisa sinaliza riscos concretos para sistemas de IA com memória pessoal em uso comercial — assistentes pessoais, chatbots de atendimento e ferramentas de produtividade que acumulam contexto entre sessões. Um agente que força resposta definitiva diante de preferências do usuário contraditórias toma decisões baseadas em premissas não verificadas.
Em médio prazo, o TANGLE pode se tornar referência para avaliar robustez de memória em modelos comerciais. A distinção entre reconhecer conflito e agir adequadamente diante dele tende a ganhar atenção de equipes de segurança alinhamento.
O que vem agora
O artigo propõe o CAAP como caminho para políticas de ação conscientes de conflito, mas o mecanismo ainda precisa de validação em ambientes reais. A pesquisa aponta para necessidade de extrair e representar memória de forma que relações conflitantes sejam preservadas, não eliminadas durante processamento.
Fontes
- arXiv (arxiv.org/abs/2608.13921) — "When Personal Memory Has No Single Answer: Evaluating LLM Agents under Irreducible Conflict" — 14 de agosto de 2026