
Novo critério prevê quando seleção por hidden state supera votação em LLMs
Critério 'decodability' oferece forma prática e sem vazamento de dados de escolher entre métodos de fusão de respostas
O que aconteceu
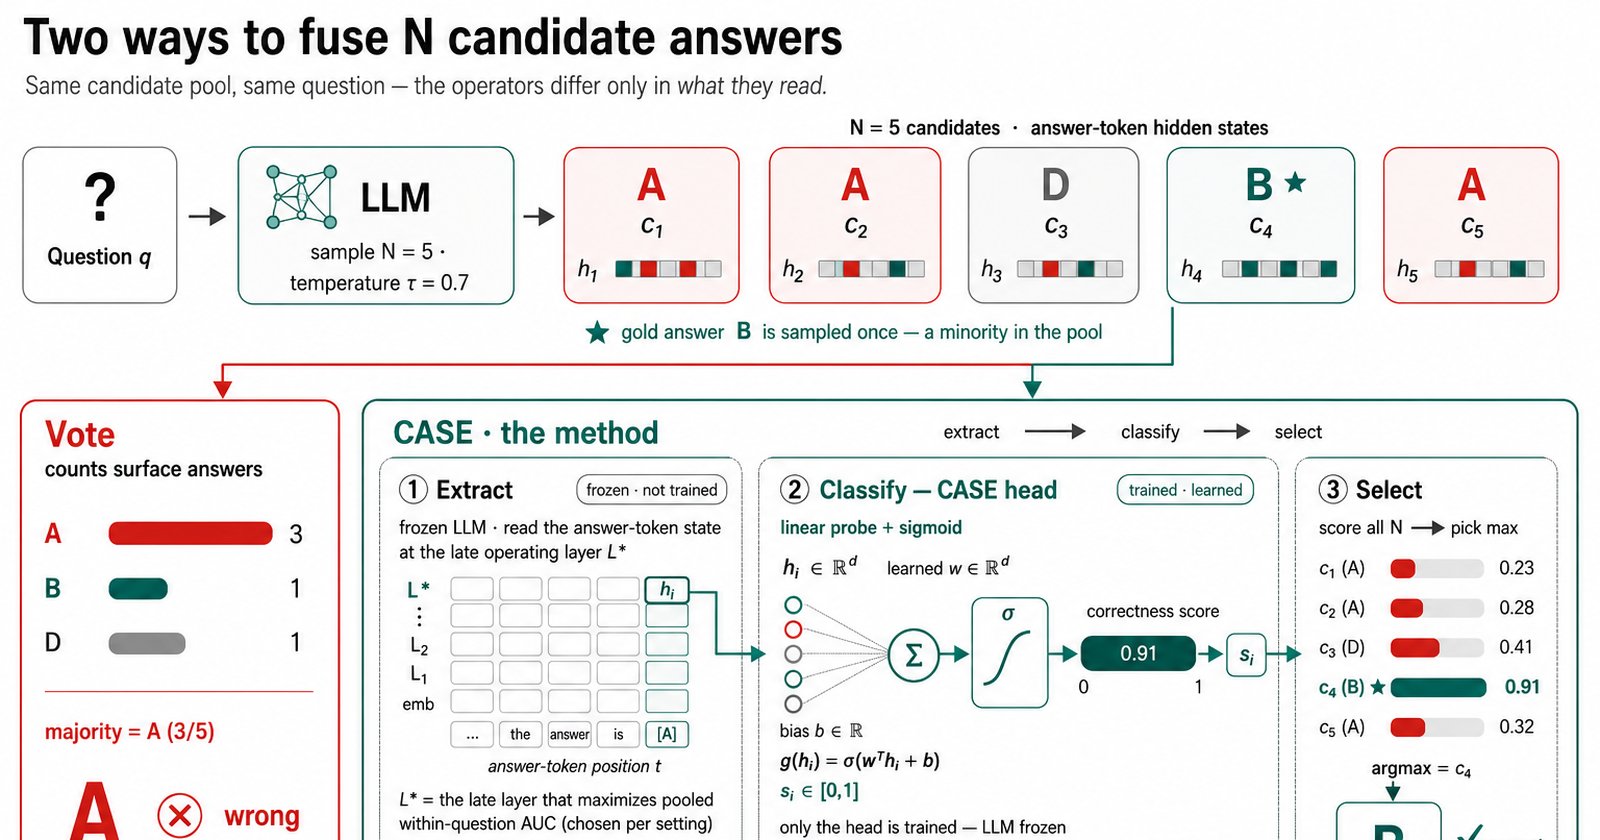
Uma nova pesquisa publicada no arXiv (17/ago/2026) apresenta o CASE (Correctness-Axis SElection), um método dinâmico de combinação de respostas para LLMs. O trabalho também propõe o 'decodability', uma métrica sem vazamento que mede quão bem um classificador linear ranqueia respostas corretas acima das incorretas.
Os resultados mostram que o CASE melhora a acurácia sobre a votação majoritária em até 19 pontos em perguntas de dificuldade média e 16,8 pontos em perguntas difíceis. A correlação de Pearson entre o decodability e o ganho real de acurácia é de r=0,75, com um limiar de decisão próximo a um AUC de 0,60.
Contexto
A votação majoritária é a técnica padrão para combinar múltiplas respostas amostradas por um LLM em uma única decisão. Porém, em perguntas complexas, as respostas amostradas tendem a compartilhar erros correlacionados. Nesse cenário, o voto vencedor pode estar errado, e gerar mais amostras pode piorar a decisão.
A seleção de candidatas a partir dos estados ocultos (hidden states) do modelo foi vista como uma alternativa promissora. Porém, sua eficácia varia entre modelos e tarefas, e não existia uma medida confiável para prever quando ela seria superior. Pesquisas anteriores usando sondas convencionais (probes) apresentavam acurácia artificialmente alta por causa do vazamento de identidade da pergunta durante o treinamento, um problema que o 'decodability' resolve ao usar avaliação agrupada por perguntas.
Por que importa
O CASE e sua métrica de decodability oferecem uma ferramenta prática e mensurável para engenheiros e pesquisadores. Antes de implementar um sistema de fusão de respostas em produção, é possível calcular o decodability para um dado modelo e tarefa. Esse valor serve como um critério objetivo para decidir se vale a pena treinar e usar o gate de seleção ou se a votação majoritária continua sendo a opção mais robusta.
Isso é especialmente relevante para domínios de alto risco, como o médico, onde o trabalho demonstrou melhorias significativas. A pesquisa indica que o decodability depende do conhecimento alinhado que o modelo precisa acessar, não da sua escala, e que a predição transferi para um domínio científico não visto com uma margem de erro de apenas 3,8 pontos.
Impacto
No curto prazo, o CASE pode otimizar pipelines de inferência que dependem de múltiplas amostras (como raciocínio em cadeia ou verificação), reduzindo a necessidade de modelos muito maiores para atingir alta acurácia. Para empresas, abre caminho para sistemas de IA mais confiáveis e eficientes em tarefas de raciocínio complexo.
No médio prazo, a métrica de decodability pode se tornar um padrão para avaliar a "confiabilidade interna" de um LLM para uma tarefa específica, influenciando a escolha do modelo e a arquitetura do sistema de geração de resposta.
O que muda
O método altera a abordagem para a "fusão de informação em tempo de teste" (test-time information fusion) em LLMs. Em vez de tratar todas as amostras como votos iguais, permite que o modelo "olhe para dentro" (via hidden states) para pontuar a confiança de cada candidata. A mudança fundamental é a introdução de um critério prévio e não-viesado (decodability) para guiar essa escolha.
O que vem agora
Próximos passos prováveis incluem a validação do CASE e do decodability em uma gama mais ampla de modelos de código aberto e proprietários, além de tarefas de raciocínio não-científicas. Pode haver trabalhos futuros focados em otimizar a eficiência computacional do gate linear e em integrar o critério de decodability em frameworks de orquestração de LLMs (como LangChain ou frameworks proprietários) como um seletor automático de estratégia.