
Novo framework explica agentes de IA por rastros de execução
Método pós-hoc converte o histórico longo de um agente em relatório estruturado e explicação em linguagem natural, diz artigo no arXiv
O que aconteceu
O artigo "Explaining AI Agents Through Execution Traces" foi submetido ao arXiv em 5 de setembro de 2026 e aparece na categoria Computer Science, na área de Artificial Intelligence, sob o código arXiv:2609.06063v1. O framework descrito no arXiv:2609.06063v1 parte de um problema específico: agentes de IA cada vez mais rodam em ambientes reais, chamam ferramentas externas e tomam decisões em sequência com pouca supervisão humana.
A proposta é pós-hoc, ou seja, roda depois que a execução terminou. O sistema pega o rastro de execução de um agente, aquele registro comprido de cada passo dado durante uma tarefa, e o converte em duas saídas. A primeira é um relatório estruturado. A segunda é uma explicação em linguagem natural explicitamente ancorada no comportamento observável do agente, e não em suposições sobre o que ele "quis dizer".
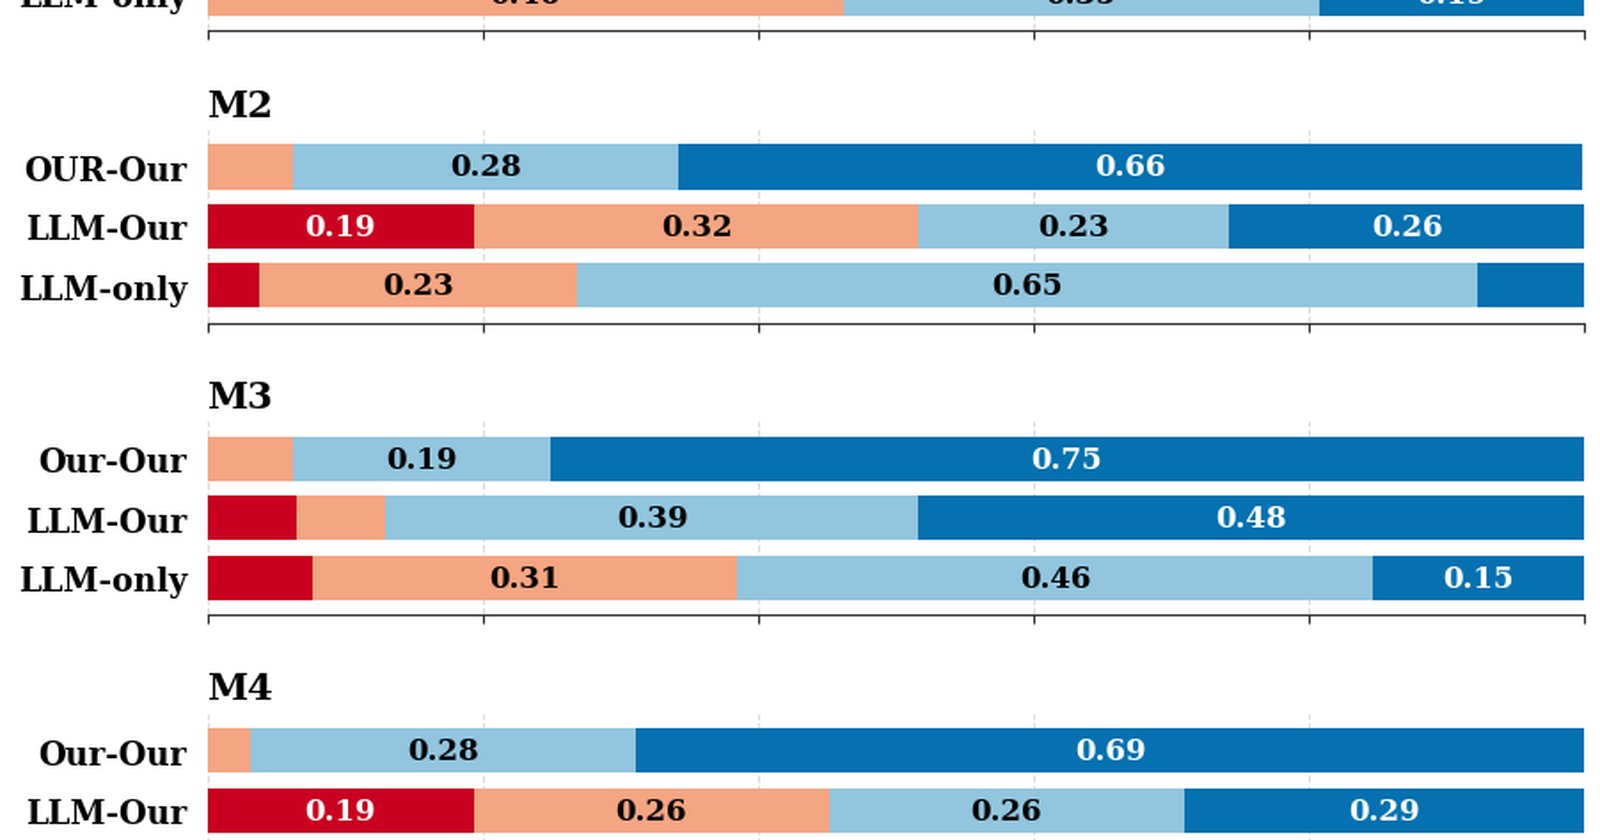
Os autores afirmam ter feito avaliações humanas e automatizadas em múltiplos benchmarks e arquiteturas. Segundo o artigo, o framework produz explicações de alta qualidade e fiéis ao rastro, além de identificar com confiabilidade três tipos de problema: alegações sem suporte, ações injustificadas e lacunas de evidência. O desempenho supera o de explicações geradas por LLM de forma ingênua, sem esse tipo de estrutura.
Contexto
A discussão parte de uma limitação conhecida das técnicas tradicionais de Explainable AI, a chamada XAI. Esses métodos foram desenhados para modelos avaliados de forma mais estática e não oferecem a transparência de nível de processo que sistemas interativos e de múltiplos passos exigem. Um agente que consulta uma API, decide buscar um dado em outro sistema e depois escreve uma resposta final não é explicado por uma atribuição simples de importância a features.
O artigo descreve isso como uma mudança de paradigma necessária, com abordagens desenhadas especificamente para agentes de IA. A lacuna que o trabalho tenta fechar é justamente a auditoria do processo, não apenas do resultado.
Por que importa
Explicar agentes deixou de ser exercício acadêmico. Quando um agente executa ações com efeito real, alguém precisa responder o que aconteceu e por quê, com evidência. O framework do arXiv:2609.06063v1 ataca esse ponto ao exigir que cada afirmação da explicação esteja fundamentada no rastro observável. Se não houver evidência no trace, o sistema sinaliza a lacuna em vez de preencher com texto plausível.
Ganha quem precisa auditar: times de engenharia, segurança, compliance e operações que hoje leem logs gigantes ou aceitam resumos gerados por LLM sem verificação. Perde, em tese, a prática de aceitar explicação fluente como prova. O artigo trata exatamente da diferença entre uma justificativa bonita e uma justificativa fiel.
Impacto
O ponto prático é a portabilidade. Como o método depende apenas de rastros de execução, o framework descrito no artigo se aplica a arquiteturas de agente diferentes, ambientes diferentes e tarefas diferentes. Não é preciso acesso ao interior do modelo nem adaptação para cada fornecedor de LLM.
Isso reduz o custo de revisão manual de execuções longas, porque o relatório estruturado já separa o que tem base no rastro do que não tem. Em pipelines de agentes que chamam ferramentas externas, a detecção automática de ações injustificadas funciona como um filtro de qualidade antes de qualquer revisão humana.
O que muda
A comparação relevante é com explicações geradas por LLM de forma direta. O artigo afirma que o framework supera essa abordagem ingênua, e a diferença está na checagem. Uma explicação ingênua pode soar coerente e ainda assim afirmar coisas que o agente nunca fez. O framework proposto foi avaliado justamente pela capacidade de apontar alegações sem suporte, ações injustificadas e evidências faltantes.
O que vem agora
O trabalho está no arXiv como preprint, versão v1, submetido em 5 de setembro de 2026, e ainda não passou por revisão por pares. O anúncio não informa os nomes dos benchmarks usados nas avaliações nem detalha as arquiteturas testadas. A página do artigo lista ferramentas de exploração ligadas ao arXiv, como alphaXiv, Hugging Face e Connected Papers, mas o material disponível não confirma se os autores liberaram código ou dados. Os próximos passos naturais são a revisão por pares e a reprodução independente dos resultados em outros ambientes de agentes.
FONTES
- arXiv cs.AI: Explaining AI Agents Through Execution Traces (arXiv:2609.06063v1) - https://arxiv.org/abs/2609.06063