
Novo método de timestamping palavra a palavra para SpeechLLMs
Técnica híbrida de fine-tuning melhora a precisão temporal sem sacrificar a transcrição.
O que aconteceu
O artigo "Relative Time Intervals Representation for Word-level Timestamping with Masked Training" (arXiv:2608.24041) foi submetido em 25 de agosto de 2026, na categoria Computer Science > Artificial Intelligence do arXiv. O grupo responsável pelo trabalho identifica uma lacuna: apesar de os Speech Large Language Models (SpeechLLMs) serem bons em entender e gerar fala, eles têm dificuldade em produzir saídas temporalmente alinhadas, como marcar o instante exato de cada palavra na transcrição.
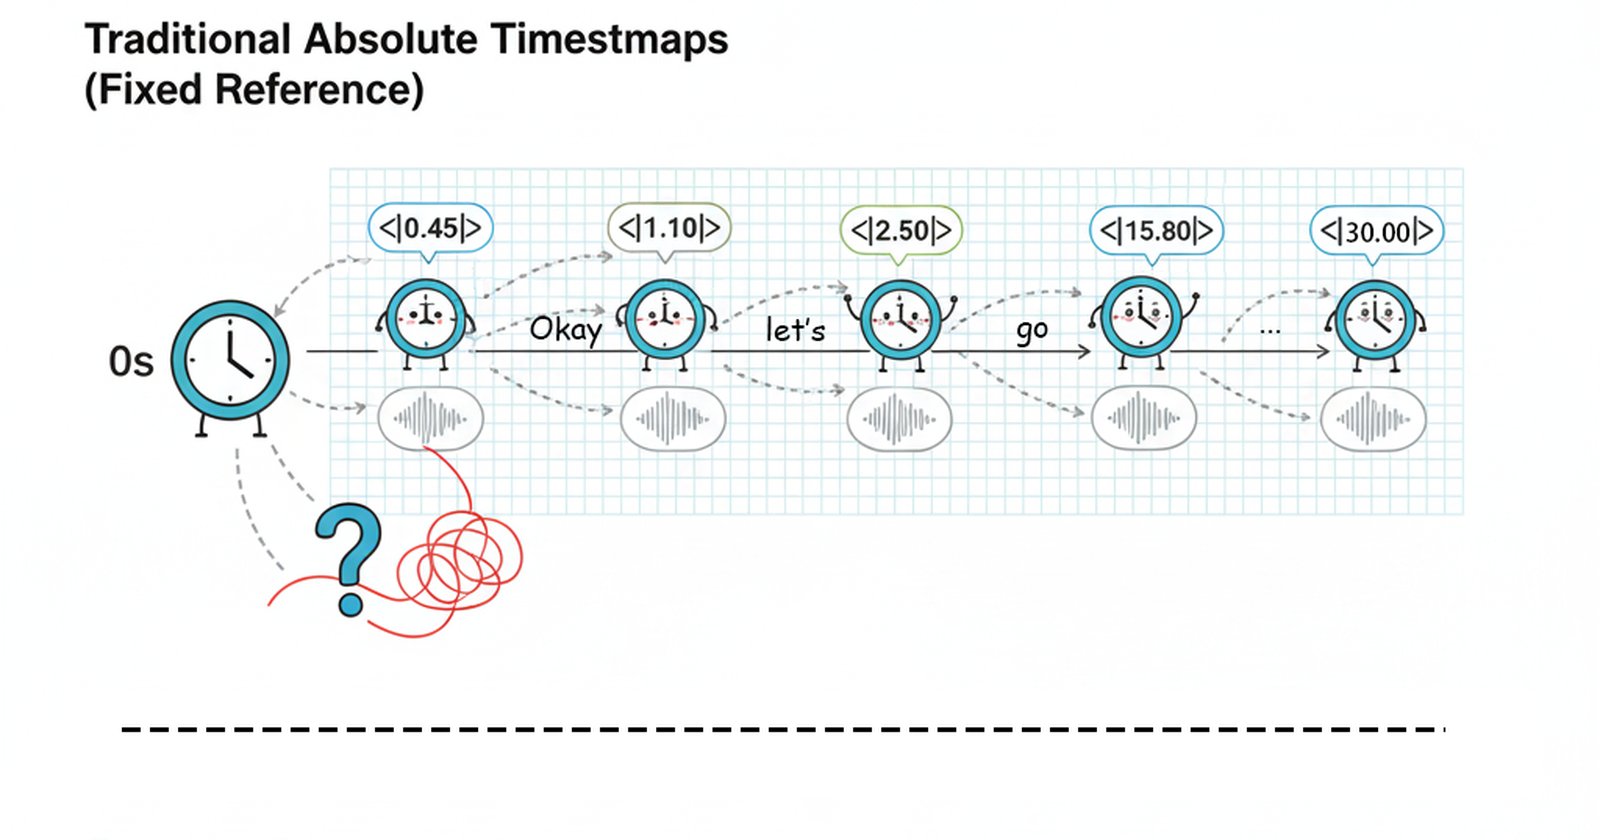
A proposta central é trocar os timestamps absolutos por representações de intervalos de tempo relativos. Com isso, o vocabulário fica mais compacto e o modelo generaliza melhor, segundo o resumo do paper. O método ainda introduz uma estratégia híbrida de fine-tuning: ajuste completo dos parâmetros da camada de embedding (que recebe os timestamps) e da cabeça de linguagem, combinado com LoRA nas camadas do decodificador.
Para impedir que o modelo se apoie demais nos timestamps verdadeiros durante o treino, o paper desenha um objetivo de treinamento mascarado (masked timestamp training). Ele oculta parte dos rótulos temporais, o que torna o sistema mais robusto quando encontra anotações ruidosas em aplicações reais. Na avaliação feita pelos autores, a técnica alcançou melhora significativa na precisão da predição de timestamps, mantendo forte desempenho em transcrição de fala.
Contexto
Speech Large Language Models são grandes modelos de linguagem treinados para entender e gerar fala. Eles já performam bem em tarefas como transcrição, tradução e respostas faladas. O problema é que, até agora, a dimensão temporal ficava de fora. Modelos que transcrevem fala costumam usar timestamps absolutos, que marcam um instante fixo no eixo do tempo. Essa abordagem tem vocabulário extenso e dificuldade de generalizar para pausas, ruídos e durações variáveis de fala.
O paper ataca exatamente essa limitação. Ao representar o tempo como intervalos relativos entre palavras, o modelo passa a codificar a estrutura temporal de forma mais econômica. A técnica de treinamento mascarado, por sua vez, segue a lógica de denoising: se o modelo aprende a prever timestamps mesmo com parte deles ocultada, ele não cria dependência excessiva dos rótulos e fica mais preparado para dados imperfeitos.
Por que importa
Transcrição com timestamps palavra a palavra é útil em várias aplicações práticas: legendagem de vídeos, análise de diálogos, edição de áudio, assistentes que precisam sincronizar a resposta com a fala e sistemas de indexação de mídia. Hoje, quem usa APIs de transcrição muitas vezes precisa de pós-processamento para alinhar texto a vídeo. Se um SpeechLLM consegue fazer isso nativamente, o pipeline inteiro fica mais simples.
A troca de timestamps absolutos por relativos também tem impacto direto em custo computacional. Um vocabulário mais compacto significa menos tokens para representar a mesma informação, algo relevante para quem roda esses modelos em produção e paga por token ou por hora de GPU.
Impacto
No curto prazo, a contribuição é acadêmica: o paper serve de referência para quem pesquisa alinhamento temporal em modelos de fala. No médio prazo, a técnica pode entrar em bibliotecas de código aberto e em APIs comerciais de transcrição, reduzindo a necessidade de ferramentas externas de alinhamento.
Um ponto importante é a robustez contra anotações ruidosas. Em conjuntos de dados reais, o alinhamento palavra a palavra é caro de produzir e frequentemente impreciso. O treinamento mascarado de timestamps ataca justamente esse problema, o que pode baratear a criação de novos datasets e aumentar a confiabilidade dos modelos em áudios do mundo real, com ruído de fundo e variação de ritmo de fala.
O que muda
Modelos de fala deixam de ser apenas máquinas de entender conteúdo e passam a ser máquinas cientes do tempo. Esse é o giro conceitual defendido no paper. Na prática, quem desenvolve produtos de fala pode esperar sistemas que entregam o texto com a posição temporal de cada palavra já incluída, sem depender de etapas externas. Para o usuário final, o resultado aparece em legendas melhor sincronizadas e em buscas que localizam o trecho exato de um áudio.
O que vem agora
O paper foi submetido e está disponível em versão preliminar no arXiv. Ainda não há anúncio de código aberto, dataset ou integração com produtos comerciais. Para acompanhar, vale observar a página do artigo no arXiv (arxiv.org/abs/2608.24041), onde aparecem versões atualizadas e eventuais links para código e dados, que a plataforma costuma listar em ferramentas como alphaXiv e Hugging Face.
Fontes
- arXiv cs.AI: "Relative Time Intervals Representation for Word-level Timestamping with Masked Training" (arXiv:2608.24041, submetido em 25 ago 2026). Disponível em: https://arxiv.org/abs/2608.24041