
Novo Pipeline QDOS Usa Aprendizado Offline para Acelerar Robôs e IA
Abordagem resolve limitação clássica de métodos anteriores que dependiam da qualidade dos dados
O que aconteceu
O paper "Learning Hierarchical Skill Policies with Offline Quality-Diversity Reinforcement Learning" apresenta o QDOS (Quality-Diversity Offline Skill learning), um pipeline unificado para aprendizado robusto do offline para o online. O método foi submetido ao arXiv em 20 de agosto de 2026.
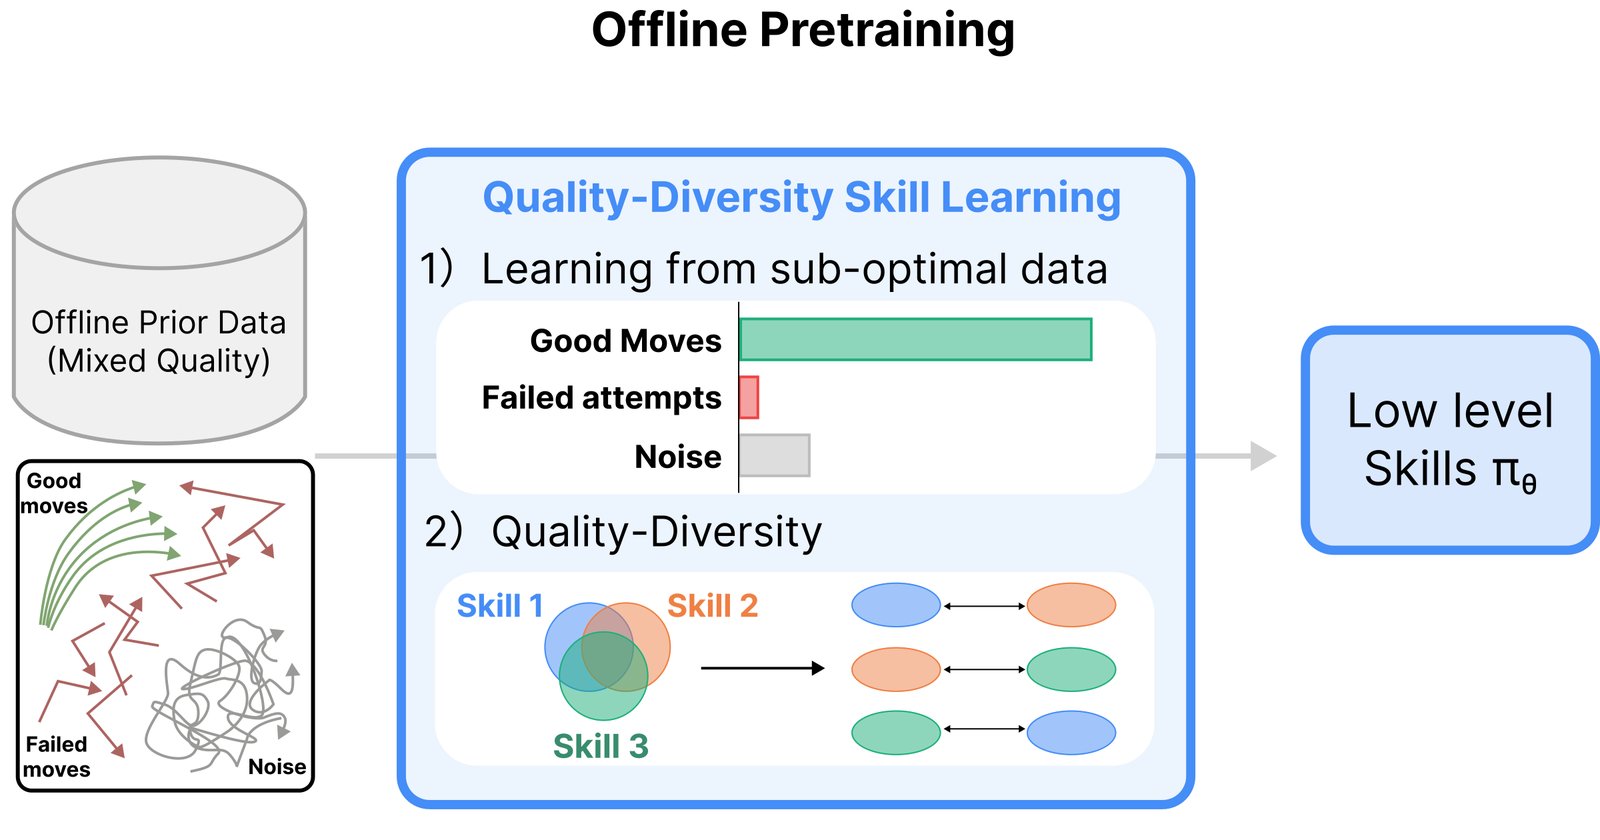
A inovação principal é o objetivo de pré-treinamento "Advantage-Weighted Quality-Diversity". Ele pondera os objetivos de extração de skills e diversidade pelo valor (advantage) estimado de cada segmento da trajetória. Isso permite extrair habilidades que são ao mesmo tempo diversas e de alto valor para a tarefa.
Além disso, o QDOS incorpora uma estratégia de reutilização dupla de dados. Os dados offline são usados tanto para o pré-treinamento das skills quanto para popular o buffer de replay online via rotulagem pseudo-automática. Em testes, o método superou por larga margem baselines fortes em tarefas de manipulação estruturada e locomoção não estruturada, acelerando a exploração e melhorando os resultados finais em domínios com recompensa esparsa.
Contexto
O principal desafio do aprendizado por reforço (RL) offline, que usa dados pré-coletados, é que a qualidade da política de baixo nível (as skills atômicas) depende diretamente da qualidade do dataset. Abordagens anteriores, como a extração não supervisionada via trajectory VAE, não garantiam que as habilidades extraídas fossem as mais relevantes ou eficazes. Isso limitava o desempenho da política de alto nível que deve usar essas skills para resolver a tarefa final.
O QDOS foi projetado para resolver essa limitação, criando uma representação de skills mais robusta e alinhada com a tarefa alvo, mesmo partindo de dados imperfeitos.
Por que importa
O impacto prático é significativo para empresas que desenvolvem robótica, automação e sistemas autônomos. Coletar dados do mundo real é caro, lento e muitas vezes perigoso. O QDOS promete maximizar o valor desses dados já existentes, acelerando o ciclo de treinamento de agentes que precisam realizar tarefas complexas.
Isso pode reduzir custos de pesquisa e desenvolvimento, permitindo que empresas brasileiras na indústria, logística ou agronegócio treinem robôs com mais eficiência usando os dados de operações passadas.
Impacto
No curto prazo, o método abre caminho para pesquisas mais rápidas em laboratórios de IA e robótica, uma vez que acelera o experimento com políticas hierárquicas. No médio prazo, pode viabilizar o uso de aprendizado por reforço em ambientes industriais onde a interação online é restrita, permitindo um "aquecimento" offline qualificado antes do ajuste fino.
O que muda
O QDOS muda o paradigma de como se valorizam os dados no treinamento offline. Em vez de tratar todas as trajetórias como igualmente úteis, o método atribui um peso dinâmico baseado no valor real daquele trecho para a aprendizagem. Isso cria um espaço de habilidades intrinsecamente mais direcionado para a resolução de problemas.
O que vem agora
Os próximos passos envolvem a validação em aplicações do mundo real e a integração com diferentes tipos de dados e robôs. A publicação do paper abre a porta para que outros grupos adaptem e aprimorem o pipeline QDOS para domínios específicos, como manipulação de objetos delicados ou navegação em ambientes não estruturados.