
Nvidia anuncia racks Groq em produção e online em 2026
Equipamentos com 256 chips entregam 3.400 tokens por segundo e miram em latência zero
O que aconteceu
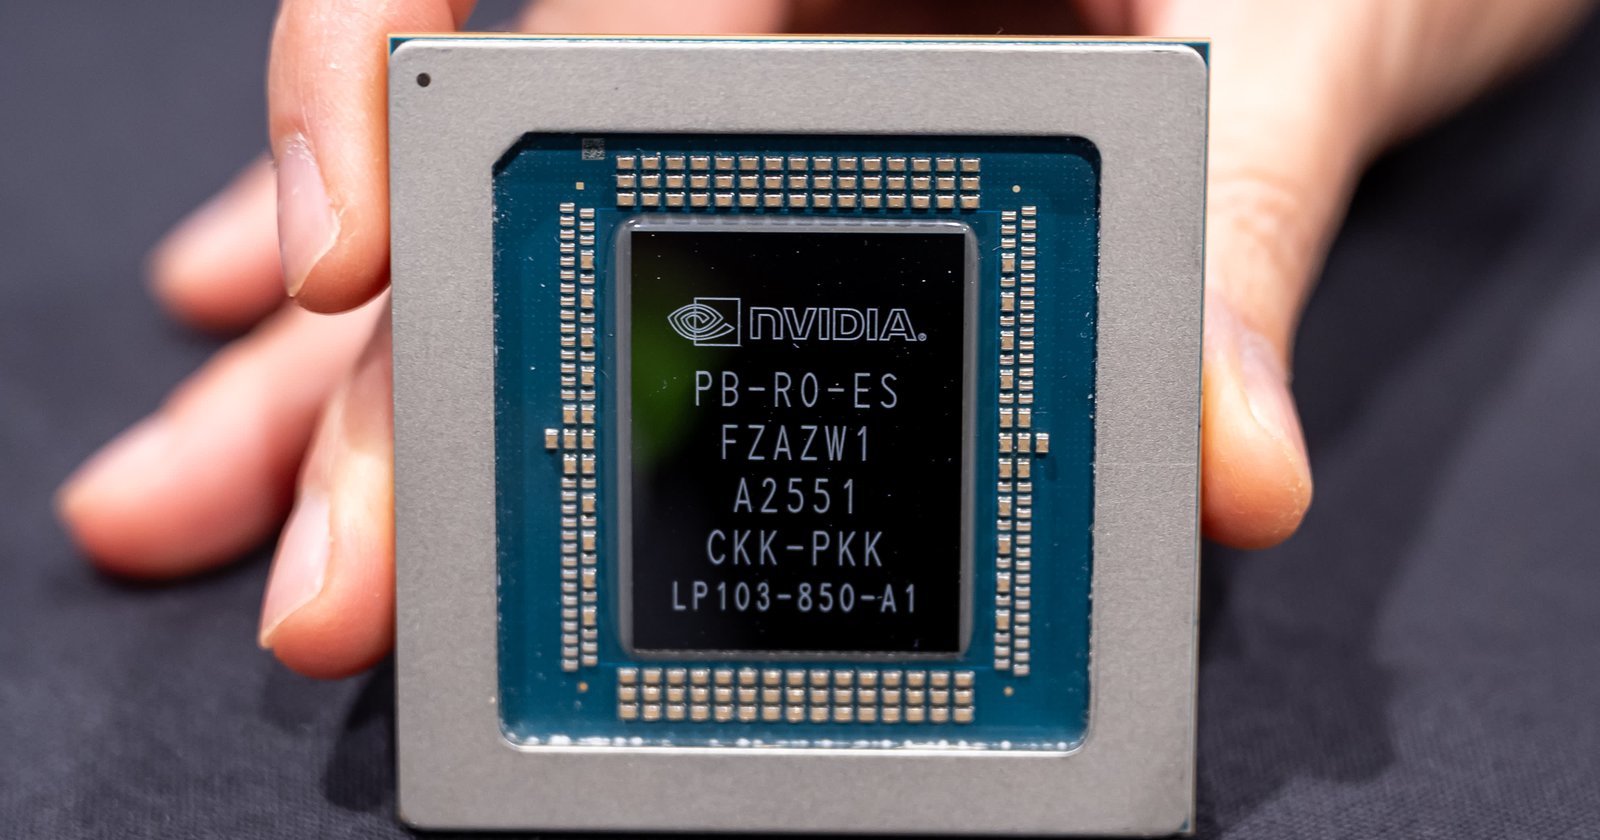
A Nvidia divulgou que seu rack Groq 3 LPX está em produção plena e será implantado, junto com processadores centrais Vera e GPUs Rubin, no neocloud Nebius até o final de 2026. A informação foi dada por Dion Harris, diretor sênior da Nvidia, em coletiva de imprensa (CNBC). Cada rack empacota 256 chips Groq 3 individuais e é capaz de entregar 3.400 tokens por segundo, segundo benchmark da empresa de análise Artificial Analysis citada pela Nvidia. A capacidade de produção comercializa a tecnologia adquirida na compra de ativos da startup Groq por US$ 20 bilhões em dezembro, a maior aquisição já feita pela fabricante.
O design do chip Groq inclui 500 megabytes de SRAM rápida diretamente no die, uma arquitetura projetada para reduzir gargalos de memória. Esses chips são fabricados pela Samsung, em contraste com os GPUs da própria Nvidia, que são produzidos pela TSMC. Harris esclareceu que a solução não substitui GPUs, que continuam como a base para treino e inferência. "Isso não é sobre substituir GPUs. É sobre usar o preço certo, o processador certo para a parte certa da carga de trabalho", disse o executivo.
Contexto
A compra da Groq em dezembro representou um marco estratégico para a Nvidia. O valor de US$ 20 bilhões superou todas as aquisições anteriores da empresa e sinalizou uma aposta de longo prazo em arquiteturas específicas para inferência de IA. A corrida para industrializar a tecnologia Groq se intensifica em um mercado onde a velocidade de resposta é um diferencial comercial cada vez mais importante.
A competição nesse segmento está acirrada. A AMD anunciou neste ano que integrará seus sistemas em escala de rack com chips da Cerebras, empresa que recentemente abriu capital e também foca em inferência de baixa latência. A OpenAI, por sua vez, lançou seu modo "Ultrafast", que promete 750 tokens por segundo e é "energizado por Cerebras" (OpenAI). A Nvidia agora entra nessa disputa com uma solução própria, montada em escala de rack.
Por que importa
A iniciarção é a fase que consome mais tempo e energia ao servir um modelo de IA. Chips de baixa latência como o Groq são otimizados especificamente para a fase de "decodificação", a etapa que gera os tokens de resposta. Para empresas que vendem acesso a IA, como provedores de nuvem, reduzir a latência significa poder cobrar mais caro por um serviço premium.
"Para quem fornece tokens, isso desbloqueia a capacidade de oferecer níveis de serviço premium para aqueles clientes que realmente demandam acordos de serviço sensíveis à latência", explicou Harris. Isso abre um novo modelo de monetização no mercado de cloud para IA, focado em velocidade em vez de apenas capacidade de processamento bruta.
Impacto
A adoção dos racks Groq pela Nvidia pode redefinir a arquitetura dos data centers voltados para inferência de IA. Com a operação no Nebius planejada para o final de 2026, empresas terão um novo benchmark de performance em latência. A capacidade de 3.400 tokens por segundo estabelece um novo patamar público, comparado aos 750 tokens por segundo da solução da OpenAI/Cerebras.
Para o ecossistema, a mensagem é clara: o mercado está se fragmentando. As GPUs da Nvidia permanecerão como o cavalo de batalha para treino e cargas de trabalho gerais, mas soluções especializadas ganharão parcela significativa do tráfego de inferência. A Nvidia está se posicionando para vender ambas as soluções, garantindo receita independente de qual arquitetura prevalecer.
O que vem agora
A Nvidia está paralelamente acelerando o envio de seus sistemas Vera Rubin, que iniciaram produção neste ano. Em março, durante a apresentação conjunta do Vera Rubin e do Groq 3 LPX, o CEO Jensen Huang projetou vendas acumuladas de US$ 1 trilhão entre as gerações de chips Blackwell atuais e os novos sistemas Vera Rubin até 2027. A integração dos racks Groq nesse portfólio amplia a oferta da empresa.
O próximo passo observado pelo mercado será a expansão da base de clientes para os racks Groq além do Nebius. A capacidade de manufacturing, repassada da Groq para a Nvidia e sua parceria com a Samsung, será testada à medida que pedidos de neoclouds e grandes empresas de tecnologia surgirem. O foco da Nvidia em oferecer uma plataforma completa, com CPUs, GPUs e agora chips de inferência especializados, entrará em confronto direto com as ofertas da AMD e Cerebras em 2027.