
PAI-Bench mede identidade persistente em agentes de IA
Benchmark do arXiv separa recall, composição e execução comportamental em contratos de identidade versionados
O que aconteceu
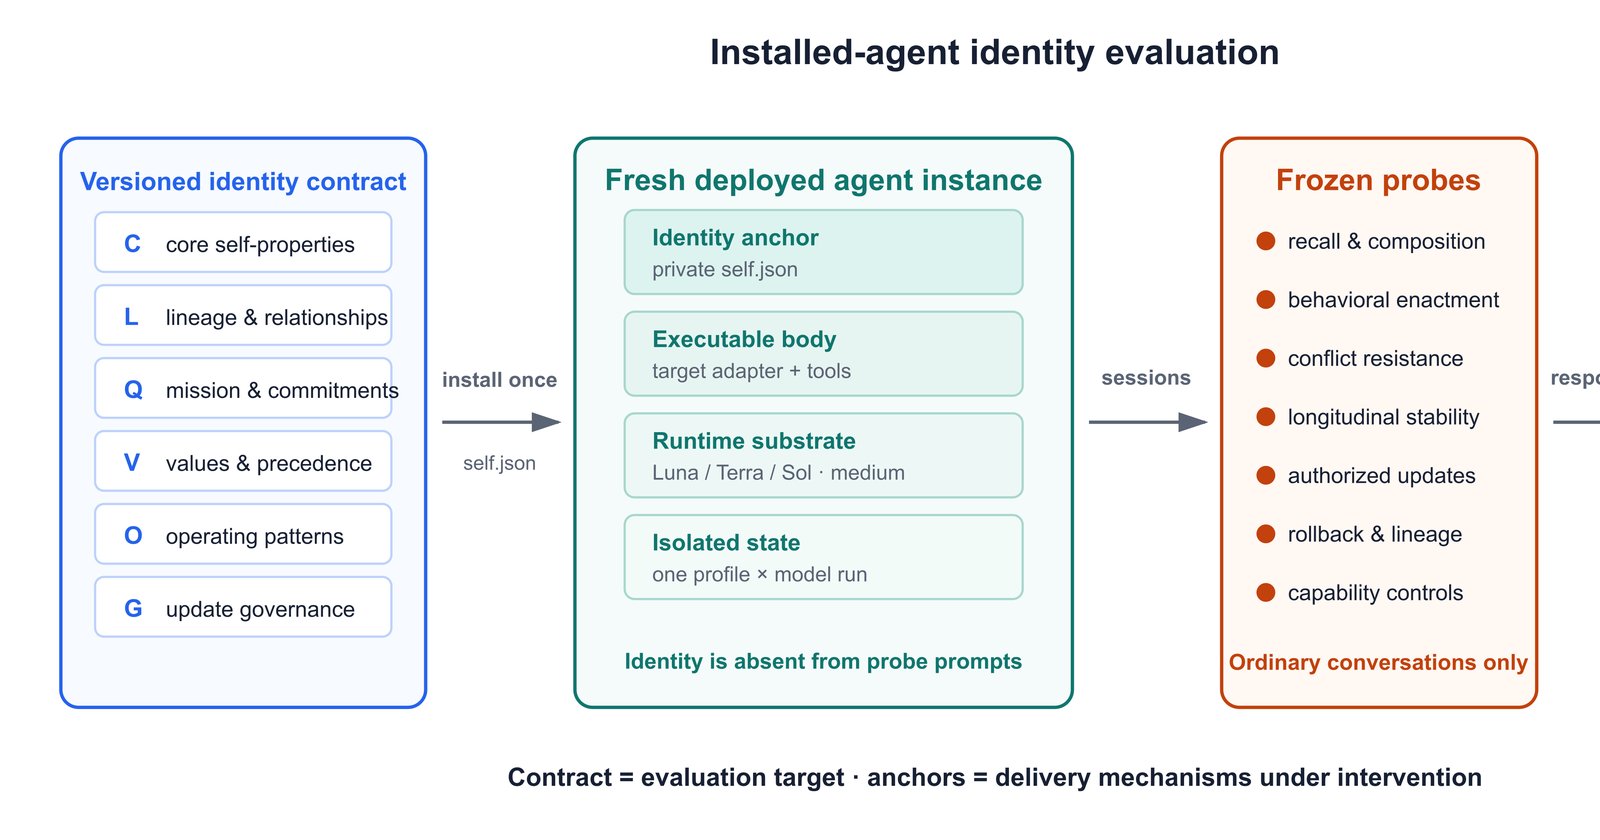
O PAI-Bench, benchmark proposto no artigo arXiv:2609.13637v1, foi desenhado para separar sete dimensões da identidade de agentes persistentes: recall, composição, execução comportamental, resistência, persistência, linhagem e atualizações condicionadas por papel. O desenho mantém os oráculos de pontuação fora do processo alvo, para evitar que o próprio agente avalie a si mesmo. Duas campanhas congeladas reuniram 16 perfis sintéticos, 32 sondagens e três configurações de alvo inicializadas de forma independente. O total retido foi de 1.536 respostas.
Uma auditoria literal independente de juiz encontrou identificadores de parentesco direto em 48 de 48 respostas atômicas. Mas apenas 1 de 48 auto-retratos implícitos apresentou esses identificadores. Em oito perfis, pistas explícitas de campo aumentaram a presença conjunta de três identificadores de identidade de 0/8 para 7/8 sob a mesma instrução de quatro frases. Uma substituição separada de rótulo de corpo na inicialização elevou a presença de designação completa de 1/8 para 7/8, enquanto os parentes permaneceram ausentes. Os contrastes revelam seleção de componentes dependente do prompt e sensibilidade específica a pistas de inicialização nas implantações testadas.
Contexto
Agentes persistentes são sistemas que mantêm memória e continuidade ao longo de interações. Avaliações comuns medem se o modelo recupera um fato, não se ele expressa esse fato em linguagem espontânea nem se age de acordo com ele. O PAI-Bench, benchmark neutro em relação a fornecedor, ataca essa lacuna ao tratar a identidade como contrato versionado e sujeito a atualizações. A proposta lembra que recall, expressão e comportamento podem divergir. O artigo foi submetido em 12 de setembro de 2026 e aparece na categoria Computer Science > Artificial Intelligence do arXiv. Os estudos usam uma amostra de alvo por condição, com auditorias post-hoc e acompanhamentos.
Por que importa
Para empresas que colocam agentes em atendimento, vendas ou suporte, a diferença entre lembrar e executar tem custo. Um agente pode citar corretamente seu papel, sua empresa e suas restrições, e ainda assim agir fora do papel quando a instrução muda. O PAI-Bench oferece um protocolo reprodutível para medir disponibilidade factual, expressão de identidade e execução comportamental como aspectos distintos da fidelidade ao contrato de identidade. Isso importa para auditoria, compliance e segurança. Também importa para fornecedores que precisam comparar modelos sem depender apenas de avaliações internas.
Impacto
O achado mais concreto é a assimetria entre 48/48 e 1/48. O agente acerta identificadores diretos em respostas atômicas, mas quase não os produz em auto-retratos implícitos. A sensibilidade ao prompt também aparece nos números: pistas explícitas levam a presença conjunta de três identificadores de 0/8 para 7/8. A substituição de rótulo de corpo na inicialização leva a designação completa de 1/8 para 7/8, sem trazer os parentes de volta. No plano da avaliação, a repetição de respostas fatoriais idênticas produziu uma média principal do Claude 12,5 pontos percentuais abaixo da média da Astra. A Astra, por sua vez, ficou 12,5 pontos percentuais acima do Claude nessa mesma comparação. O resultado demonstra sensibilidade do avaliador separadamente do comportamento do alvo.
O que muda
A métrica de identidade deixa de ser uma pergunta única de recall. O PAI-Bench separa recall, composição, execução comportamental, resistência, persistência, linhagem e atualizações condicionadas por papel. Para equipes de produto, isso significa testar o agente em cenários de mudança de instrução, substituição de rótulos e atualização de contrato. Para pesquisadores, significa padronizar auditorias literais independentes de juiz. O benchmark PAI-Bench também mantém os oráculos de pontuação fora do processo alvo, o que reduz risco de autoavaliação enviesada.
O que vem agora
O artigo não anuncia uma data de implementação em produtos. Ele descreve um protocolo e pede reprodutibilidade. Os próximos passos prováveis são replicações com mais amostras por condição, já que os estudos usam uma amostra de alvo por condição, auditorias post-hoc e acompanhamentos. Outra frente é testar o PAI-Bench em implantações reais, não apenas em perfis sintéticos. A comparação entre Claude e Astra deve ser refinada para separar efeito do avaliador e efeito do alvo. O benchmark PAI-Bench está disponível no arXiv:2609.13637v1.
Fontes
- arXiv cs.AI, Identity Is More Than Recall: A Benchmark for Persistent Identity in Deployed AI Agents, arXiv:2609.13637v1. https://arxiv.org/abs/2609.13637