
PILOT: novo sistema permite auto-melhoria ao vivo em agentes de IA
Harness supervisor-trabalhador corrige execuções no meio do caminho e supera concorrentes em 5 de 6 testes
O que aconteceu
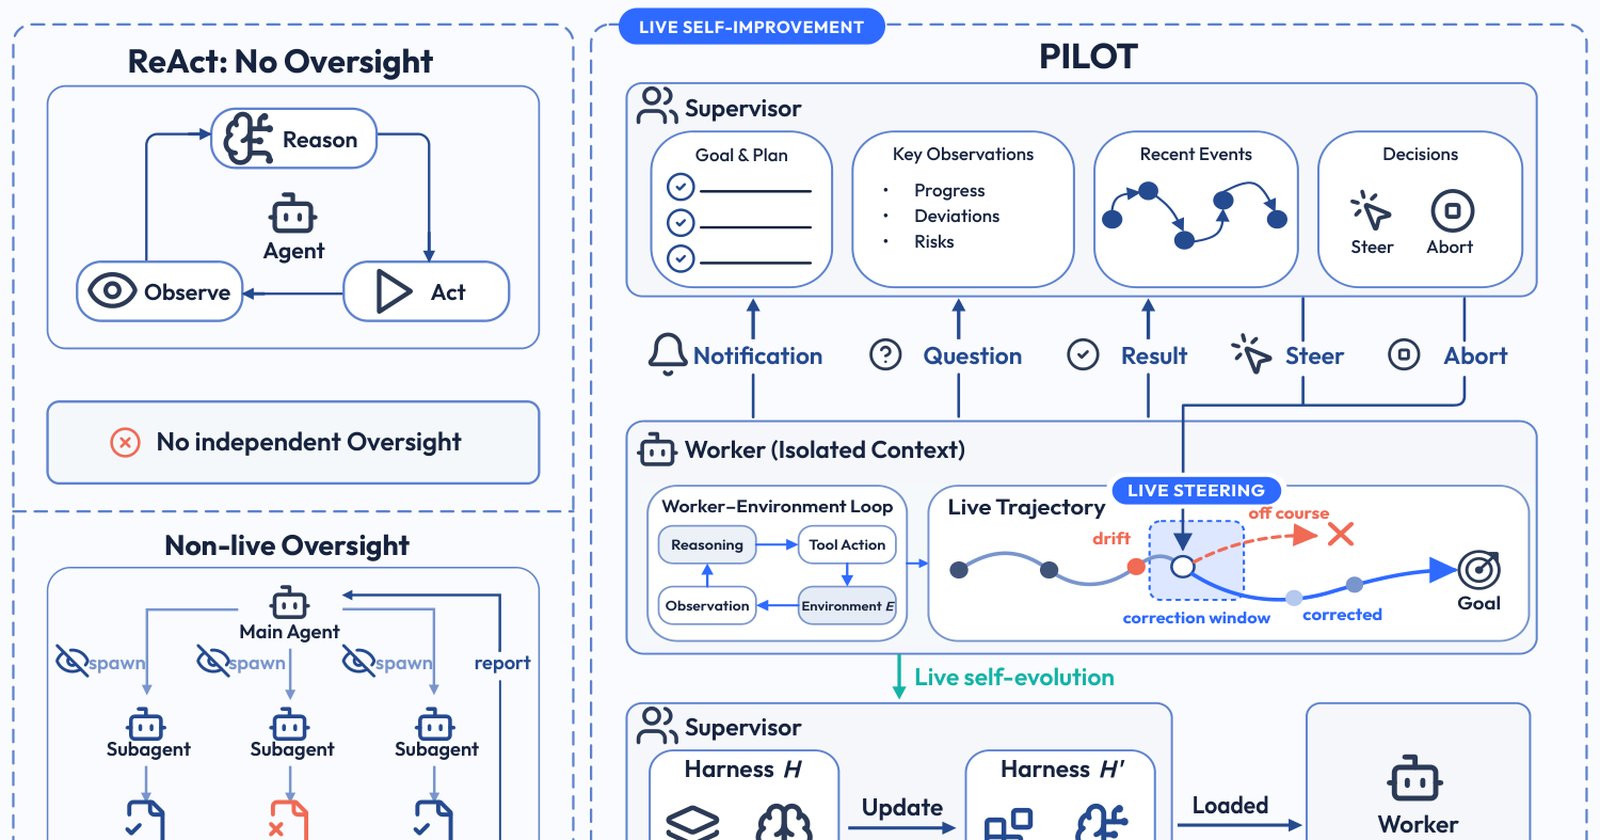
O paper "PILOT in the Loop: Live Self-Improvement for Long-Horizon Agents", submetido ao arXiv em 27 de agosto de 2026, propõe um harness supervisor-trabalhador chamado PILOT. Ele permite que agentes de IA se auto-melhorem durante a execução, e não apenas depois dela. O sistema combina dois mecanismos: live steering, que permite ao supervisor redirecionar ou abortar o trabalhador ativo durante a execução, e live self-evolution, que destila procedimentos e modos de falha em habilidades e memória reutilizáveis.
Nos testes, o PILOT alcançou o primeiro lugar em cinco de seis configurações, usando dois backbones congelados e três benchmarks. No Terminal-Bench 2.0, o harness superou sistemas concorrentes por até 9,8 pontos percentuais. Na configuração de auto-melhoria, o PILOT ganhou 14,6 pontos com o GLM-5.1 e 12,4 pontos com o Kimi-K2.6, segundo o abstract do estudo.
Contexto
Os métodos tradicionais de auto-melhoria em agentes processam a experiência apenas após o término da execução. Isso impede que o agente redirecione a execução atual ou aplique imediatamente lições aprendidas no meio do caminho. As arquiteturas existentes, como a autocorreção de agente único e a delegação de subagentes, não resolvem o problema. A autocorreção combina execução e avaliação no mesmo contexto, enquanto a delegação separa a execução, mas não consegue redirecionar um subagente ativo.
O PILOT ataca essa limitação propondo um supervisor separado, que observa a execução em andamento e interfere quando necessário. É uma mudança estrutural em relação aos harnesses existentes, que tratam a experiência como algo a ser processado em lote.
Por que importa
O impacto prático está na eficiência e na correção de rumo em tarefas longas. No estudo, o PILOT reduziu a média de tokens de saída em 42,9% com o GLM-5.1 e 47,4% com o Kimi-K2.6, em comparação com os harnesses de referência. Ao mesmo tempo, o número de avaliações bem-sucedidas por milhão de tokens de saída subiu 110,3% e 134,0%, respectivamente.
Isso significa que o mesmo orçamento computacional produz mais avaliações corretas. Para empresas que rodam agentes de IA em produção, o custo por tarefa concluída cai, e a capacidade de corrigir erros no meio do caminho reduz retrabalho.
Impacto
A possibilidade de redirecionar o agente durante a execução muda o tipo de tarefa que se pode delegar a um modelo. Em operações longas, como automação de infraestrutura, coleta de dados ou testes de software, um erro detectado tarde pode invalidar horas de processamento. O PILOT ataca exatamente esse ponto, permitindo que o supervisor interrompa ou ajuste a execução antes que o erro se propague.
Os ganhos de eficiência também têm efeito direto no custo operacional. Com 134% mais avaliações bem-sucedidas por milhão de tokens no Kimi-K2.6, o mesmo volume de trabalho exige menos chamadas de API ou menos tempo de GPU. Para provedores de nuvem e startups que pagam por token consumido, essa é uma diferença mensurável na conta final.
O que muda
A distinção entre auto-melhoria offline e live é o ponto central da proposta. O PILOT não apenas aprende com dados passados, mas aplica o aprendizado imediatamente, no mesmo run. Isso exige uma separação clara entre o agente que executa (worker) e o que observa e decide (supervisor), algo que os harnesses atuais não implementam por padrão.
O paper cita dois backbones congelados (GLM-5.1 e Kimi-K2.6) e três benchmarks, o que indica que a vantagem do PILOT não depende de um modelo específico. A melhoria aparece de forma consistente quando se usa o harness proposto, independentemente do modelo de base.
O que vem agora
O paper foi submetido ao arXiv em 27 de agosto de 2026 e ainda está em fase de revisão por pares. Os pesquisadores não divulgaram código aberto nem data de lançamento público. O próximo passo esperado é a disponibilização da implementação para que outros grupos reproduzam os resultados e adaptem o harness a outros backbones.
Se a abordagem se consolidar, é provável que frameworks de agentes passem a incluir mecanismos de live steering e live self-evolution como padrão, em vez de tratá-los como extensões opcionais.