
Preferências inferidas por LLMs não são consistentes, aponta estudo
Pesquisa do arXiv mostra que juízos de valor gerados por IA não seguem uma única lógica utilitária.
O que aconteceu
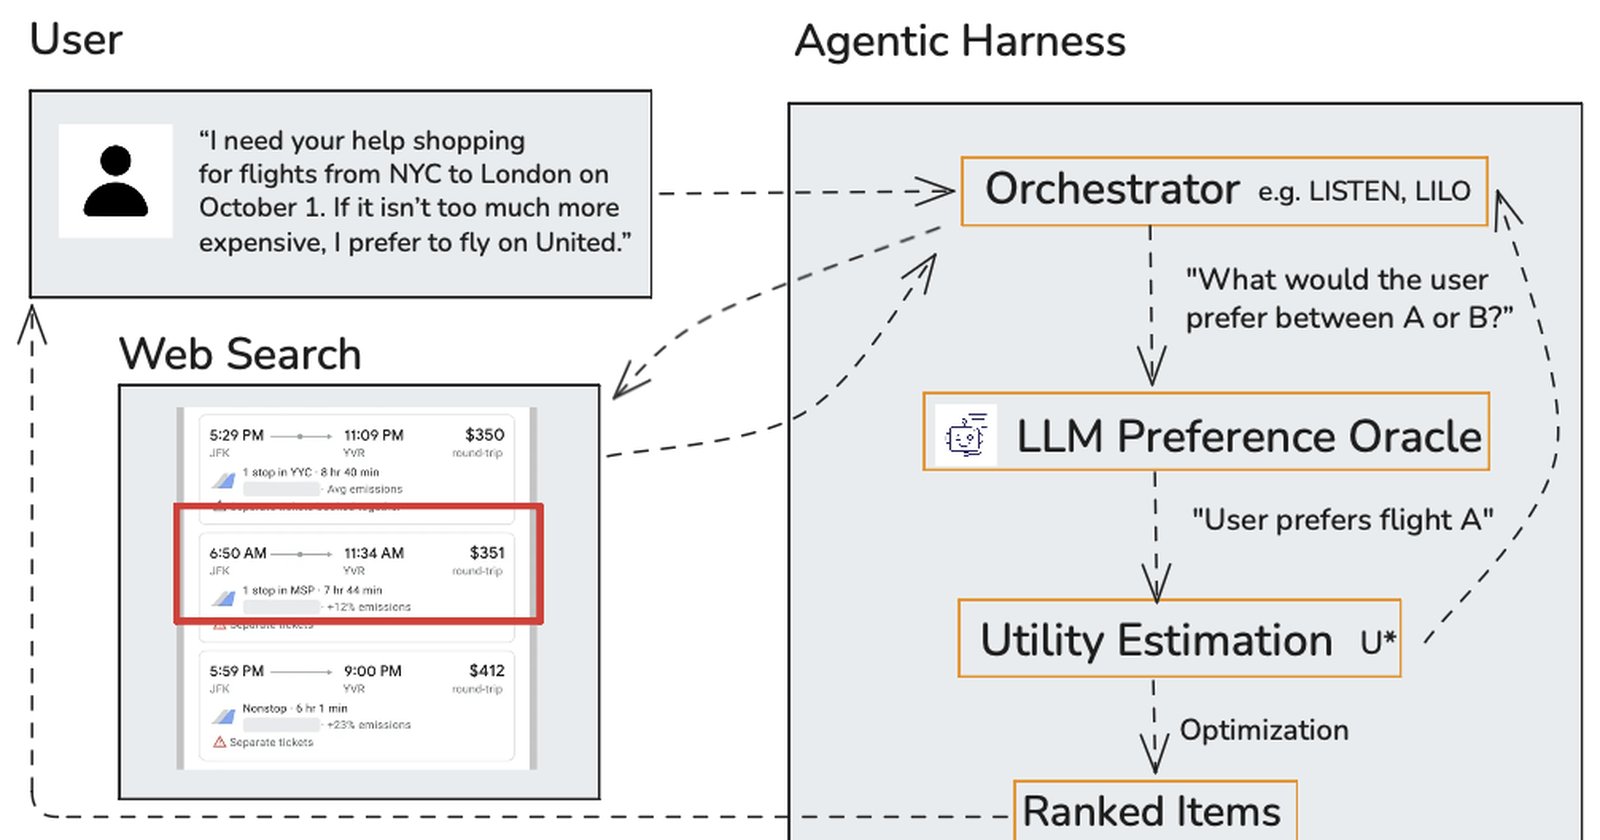
Um paper intitulado "LLM-Derived Preference Judgments Are Not Self-Consistent", publicado em 18 de agosto de 2026 no repositório arXiv, mediu a autoconsistência de juízos de preferência cardinais (números quantitativos) gerados por LLMs. Os pesquisadores desenvolveram testes estatísticos e medidas para avaliar quanto as respostas dos modelos se desviam de uma "função utilidade" ideal e autoconsistente. Exemplos práticos usaram cenários de escolha entre voos, apartamentos e hotéis. O resultado, testado em seis LLMs distintos, foi a identificação de "grandes e persistentes inconsistências" (arXiv:2608.17644).
Contexto
Vários sistemas de IA, incluindo agentes autônomos e sistemas de recomendação, utilizam LLMs para extrair preferências de usuários a partir de linguagem natural. O pipeline comum consiste em perguntar ao modelo, por exemplo, quanto alguém estaria disposto a pagar por um item e, a partir disso, construir uma função utilidade para tomar decisões automatizadas. A premissa implícita é que as respostas do LLM são aproximadamente consistentes: que uma única e coerente preferência subjacente pode explicar todos os seus juízos numéricos. Este estudo testou diretamente essa premissa.
Por que importa
A descoberta tem implicações diretas para empresas e desenvolvedores que confiam em LLMs para personalização e tomada de decisão. Se as preferências inferidas não são consistentes, modelos construídos com base nelas podem ser imprevisíveis e potencialmente injustos. Um sistema que usa o "preço justo" sugerido por um LLM para um voo pode dar respostas diferentes e conflitantes para o mesmo usuário, comprometendo a confiança e a utilidade prática da automação baseada nesses dados.
Impacto
No curto prazo, o estudo abala a validade de abordagens que tratam as respostas de LLMs como dados de preferência estáveis e racionais. Isso pode frear projetos em fases de concepção que dependem dessa pipeline. No médio prazo, pode impulsionar o desenvolvimento de métodos mais robustos para validar e calibrar julgamentos de IA antes de usá-los em decisões críticas, ou a busca por arquiteturas de modelos que ofereçam maior consistência interna.
O que muda
A pesquisa indica que não é possível resumir fielmente as preferências inferidas por LLMs em uma única e coesa "curva de utilidade". Isso muda a forma como devemos interpretar e utilizar esses dados: não como uma representação precisa de um estado interno de preferência, mas como uma fonte de sinal ruidoso e contextual. Passa a ser necessária uma camada adicional de verificação ou agregação estatística antes de confiar nessas respostas para ações automatizadas.
O que vem agora
Os próximos passos prováveis incluem a replicação deste estudo com uma gama ainda maior de modelos e cenários para mapear a extensão do problema. Também deve haver um foco crescente em técnicas de "ensemble" ou abordagens estatísticas para mitigar as inconsistências, encontrando padrões de utilidade mais robustos. A comunidade de pesquisa em IA precisará incorporar testes de consistência no conjunto de ferramentas para avaliar a confiabilidade de LLMs em aplicações que envolvem julgamento humano.