
Privacidade vs. precisão: estudo revela tradeoff entre DP e alucinações em LLMs
Pesquisa do arXiv mostra que privacidade diferencial em modelos de linguagem aumenta erros factuais, exigindo novas soluções.
O que aconteceu
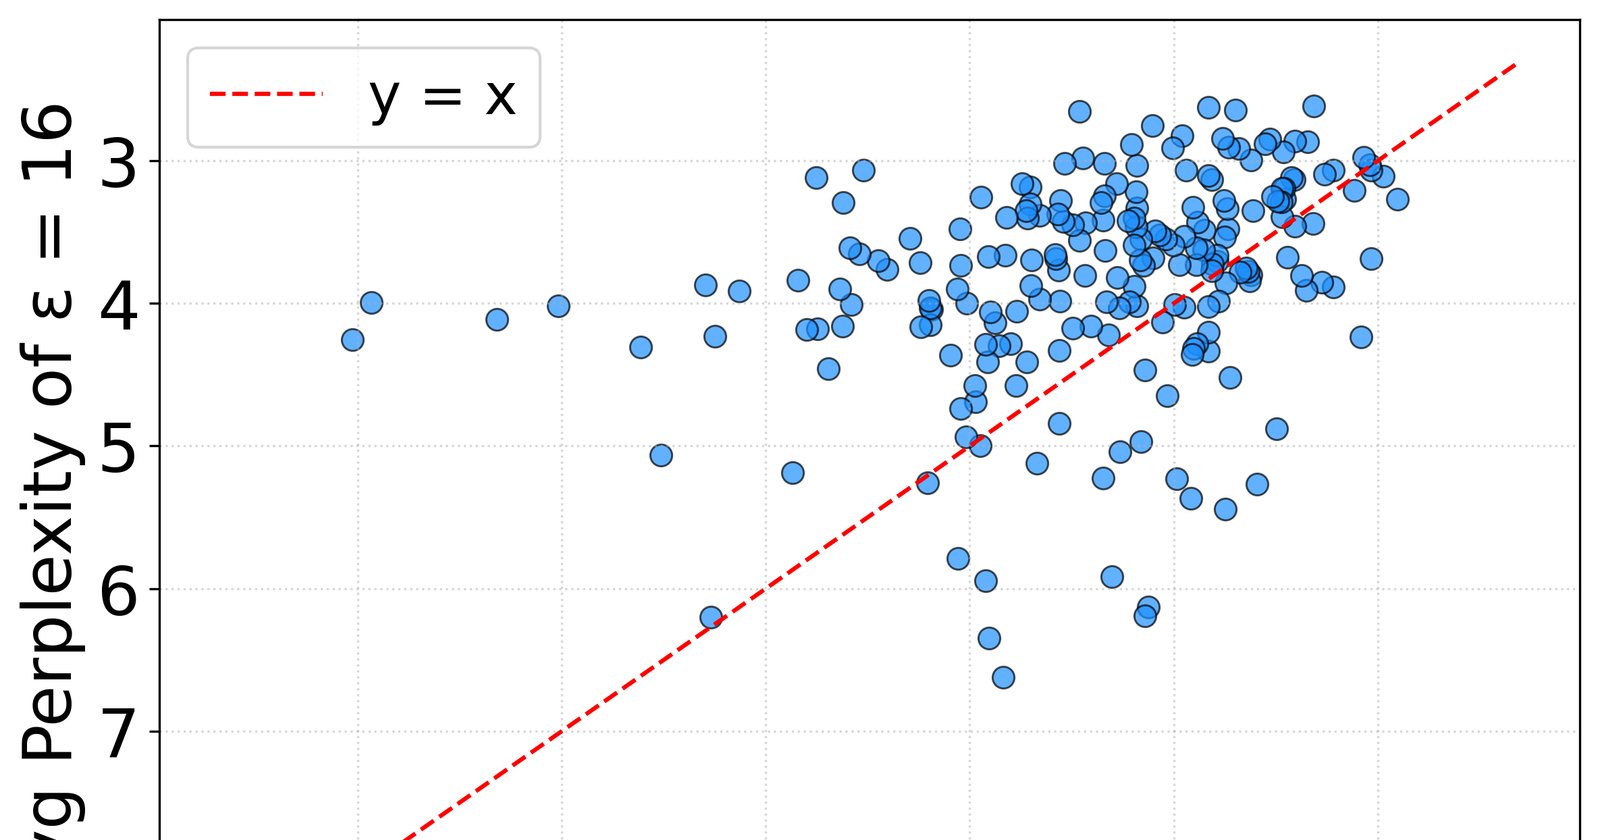
Um estudo intitulado "The Privacy-Hallucination Tradeoff in Differentially Private Language Models" foi submetido ao arXiv em 31 de agosto de 2026, com o identificador 2609.00492. A equipe investigou a relação entre privacidade diferencial (DP) e a taxa de alucinações em modelos de linguagem. Os autores demonstraram empiricamente que modelos pré-treinados ou ajustados com DP tendem a gerar mais alucinações do que suas versões sem DP. A severidade do problema aumenta conforme o orçamento de privacidade (epsilon) se torna mais estrito.
O paper, classificado na área de Computer Science > Artificial Intelligence, é o primeiro a caracterizar formalmente esse tradeoff. A pesquisa também analisou os mecanismos por trás do fenômeno. Os cientistas mostraram que os mecanismos de DP achatam as distribuições de saída dos modelos, o que pode redistribuir massa de probabilidade para alternativas factualmente incorretas.
Contexto
A privacidade diferencial é uma técnica matemática que adiciona ruído controlado aos dados de treinamento ou aos gradientes para impedir a identificação de indivíduos. Em setores como saúde e finanças, ela é considerada essencial para cumprir regulamentações como a LGPD e a HIPAA. No entanto, esse ruído pode corromper as representações internas dos modelos, levando a respostas inventadas ou distorcidas.
Estudos anteriores já haviam notado que DP afeta a qualidade dos modelos, mas nenhum havia quantificado especificamente o impacto sobre alucinações. O novo trabalho preenche essa lacuna ao estabelecer uma relação direta entre o nível de privacidade e a frequência de erros factuais. A equipe controlou a frequência de fatos nos dados de treinamento e mostrou que informações mais frequentes reduzem o risco de alucinação, mesmo sob DP.
Por que importa
Para aplicações em saúde, diagnósticos assistidos por IA e atendimento ao paciente, um modelo que inventa sintomas ou dosagens é inaceitável. O estudo mostra que tentar proteger dados sensíveis com DP pode, na prática, aumentar o risco de erros clínicos. Isso coloca as empresas de tecnologia diante de um dilema: garantir privacidade ou garantir precisão.
A pesquisa quantifica o tradeoff, o que permite que engenheiros calibrem o orçamento de privacidade com base no risco tolerável de alucinação. Em cenários onde a precisão é crítica, como triagem de exames, o custo de um epsilon baixo pode ser alto demais. Por outro lado, em tarefas menos sensíveis, como geração de texto criativo, um pouco mais de ruído pode ser aceitável.
Impacto
No curto prazo, o estudo deve influenciar a forma como desenvolvedores configuram DP em modelos de linguagem. Muitas bibliotecas de código aberto, como a Opacus, usada pelo Facebook AI Research, permitem ajustar o epsilon sem aviso sobre o impacto em alucinações. Esse trabalho fornece um alerta e uma métrica para monitoramento.
O achado também abre caminho para novas técnicas de mitigação. Uma direção é combinar DP com mecanismos de verificação factual pós-treinamento. Outra é usar métodos de edição de conhecimento que reforcem fatos críticos antes da aplicação da DP. Os autores sugerem que intervenções mais nuances, como DP por camada ou por token, podem preservar melhor a distribuição original.
O que muda
A principal mudança é a percepção de que privacidade diferencial não é um aditivo gratuito. Empresas que adotam DP para cumprir leis de proteção de dados precisarão agora incluir testes de alucinação em seus pipelines de avaliação. Modelos como o GPT e o LLaMA, quando adaptados com DP, devem ser auditados quanto à precisão factual antes do lançamento.
Além disso, o estudo incentiva a pesquisa em métodos híbridos, que apliquem DP apenas em partes sensíveis dos dados, como identificadores pessoais, e preservem a integridade dos fatos gerais. Essa abordagem poderia reduzir o tradeoff, mas ainda exige validação prática.
O que vem agora
Os autores afirmam que seus resultados sublinham a necessidade de intervenções mais nuances para oferecer garantias de privacidade sem comprometer a precisão factual. O próximo passo natural é o desenvolvimento de novas arquiteturas que integrem mecanismos de correção de fatos durante o treinamento com DP.
Também é esperado que a comunidade de IA trabalhe em benchmarks específicos para medir alucinações em modelos com DP. Isso permitiria comparações padronizadas entre técnicas de privacidade. O estudo, por ser um preprint, ainda não passou por revisão por pares, mas já está disponível para análise da comunidade científica.