
RubricForge Reduz Erros em Avaliação de Agentes IA sem Recompensas Externas
Sistema cria rubrics legíveis por humanos para julgar desempenho sem ambiente de execução.
O que aconteceu
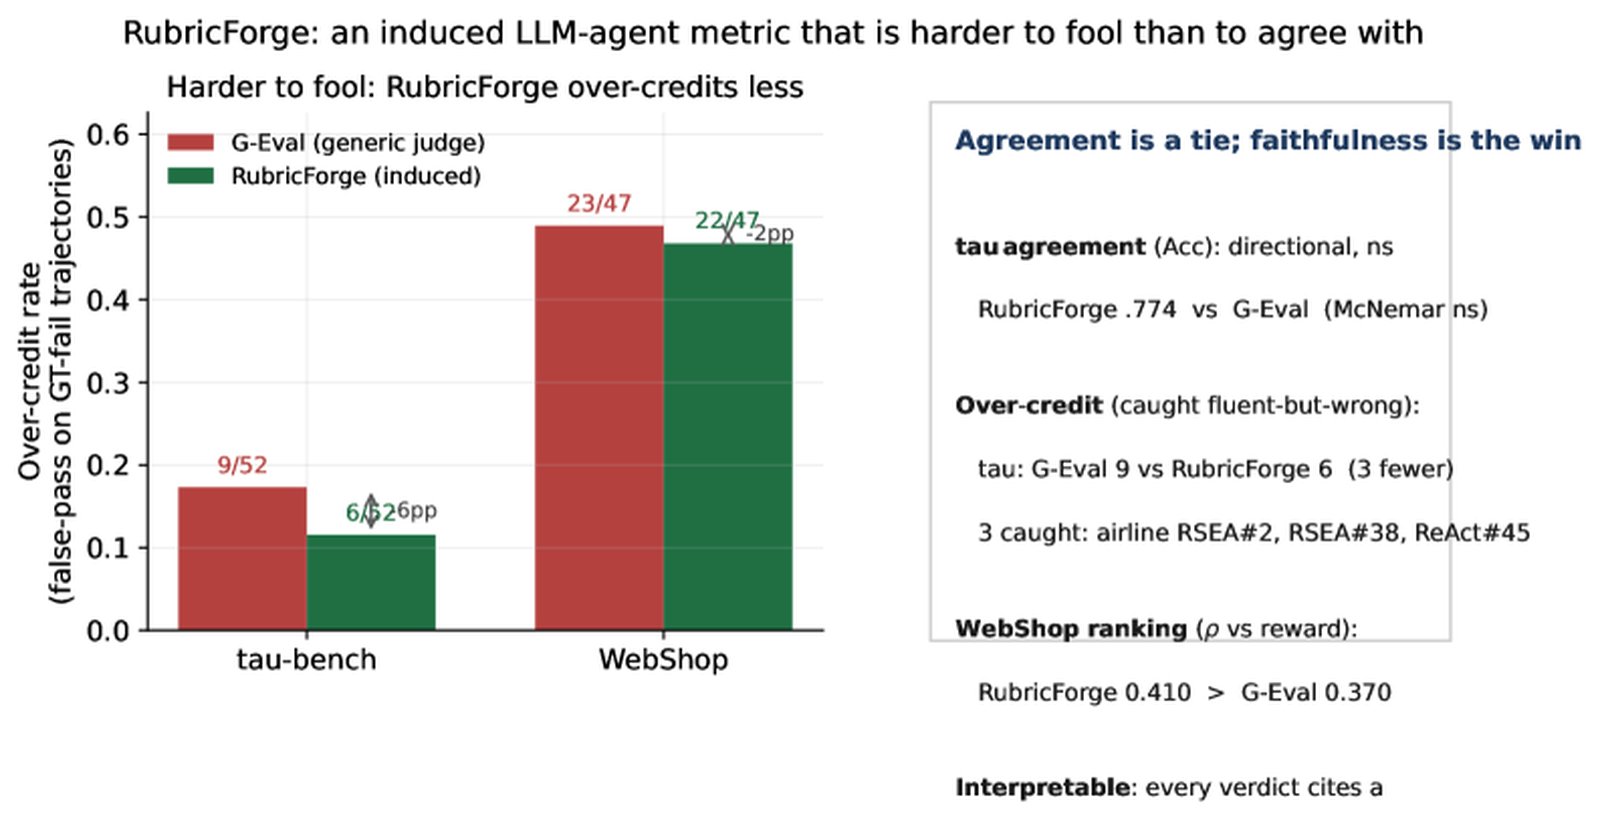
Em 25 de junho de 2026, foi publicado no arXiv o estudo "Inducing Reward-Free Judging Rubrics that Reduce Over-Crediting in Agent Evaluation", apresentando o RubricForge. O sistema induz o texto de uma rubrica de avaliação para agentes de IA a partir de um pequeno conjunto de trjetórias rotuladas com resultados verdadeiros. Ele utiliza evolução reflexiva contra essas trjetórias para maximizar a concordância com a recompensa do ambiente, congela a rubrica e a aplica em trjetórias novas com uma única chamada de modelo, sem acesso ao ambiente. Em testes com um modelo congelado de 7B como agente e juiz, no tau-bench (173 trjetórias rotuladas), a taxa de falsos positivos (over-credit) caiu de 0,173 para 0,115. No WebShop (160 trjetórias), a correlação de Spearman para classificação dos resultados aumentou de 0,370 para 0,410. A vantagem sobre um juiz genérico G-Eval não foi estatisticamente significativa no acordo bruto (McNemar p = 0,248), mas o ganho principal está na fidelidade, reduzindo erros que enviariam agentes quebrados para produção (arXiv:2608.13564).
Contexto
A avaliação de agentes de IA em larga escala depende cada vez mais de um segundo modelo como juiz automático, porque o sinal de ouro (uma recompensa executável no ambiente) é caro, lento ou indisponível no momento do deploy. Métodos atuais, como o G-Eval, usam rubrics escritos à mão, enquanto outros ajustam pesos do juiz. Ambas as abordagens tendem a creditar trjetórias fluentes sem sucesso como êxitos, gerando falsos positivos. O RubricForge aborda essa lacuna ao gerar rubrics baseados em resultados reais, tornando os critérios legíveis e atribuíveis.
Por que importa
Para empresas e desenvolvedores, a confiabilidade nas avaliações automatizadas de agentes é crítica. Um falso positivo pode levar ao deploy de um agente que falha em tarefas reais, com custos operacionais e reputacionais. Já um falso negativo apenas implica retrabalho. RubricForge reduz a taxa de falsos positivos, tornando as avaliações mais robustas sem a necessidade de ambientes de teste complexos ou caros. Isso é especialmente relevante para aplicações onde a falha tem impacto significativo, como em assistentes virtuais ou sistemas autônomos.
Impacto
No curto prazo, a técnica pode melhorar a qualidade das ferramentas de avaliação automatizada, diminuindo custos associados a testes extensivos e aumentando a confiança em agentes antes do deploy. A médio prazo, pode facilitar a adoção de agentes IA em domínios críticos, como saúde ou finanças, onde a fiabilidade é essencial. A rubrica legível por humanos também adiciona transparência, permitindo auditoria dos critérios de avaliação.
O que muda
O método introduz um artefato textual, a rubrica otimizada, que serve como proxy fiável para recompensas de ambiente. Isso significa que cada veredito do juiz pode ser rastreado até critérios específicos, aumentando a explicabilidade. Embora a calibração de escores absolutos ligeiramente favoreça juízes genéricos, a redução no false-pass rate (de 0,173 para 0,115 no tau-bench) é a métrica-chave para implantação.
O que vem agora
Próximos passos provavelmente incluem a validação do RubricForge em mais domínios e a integração em frameworks de avaliação existentes. A pesquisa também pode explorar a escalabilidade do método para modelos maiores e sua aplicação em diferentes tipos de agentes de IA, consolidando-o como padrão para avaliações sem recompensas externas.