
SafeBranch: Novo framework alinha agentes de IA a segurança
Método evita violações de segurança sem reduzir eficiência na realização de tarefas
O que aconteceu
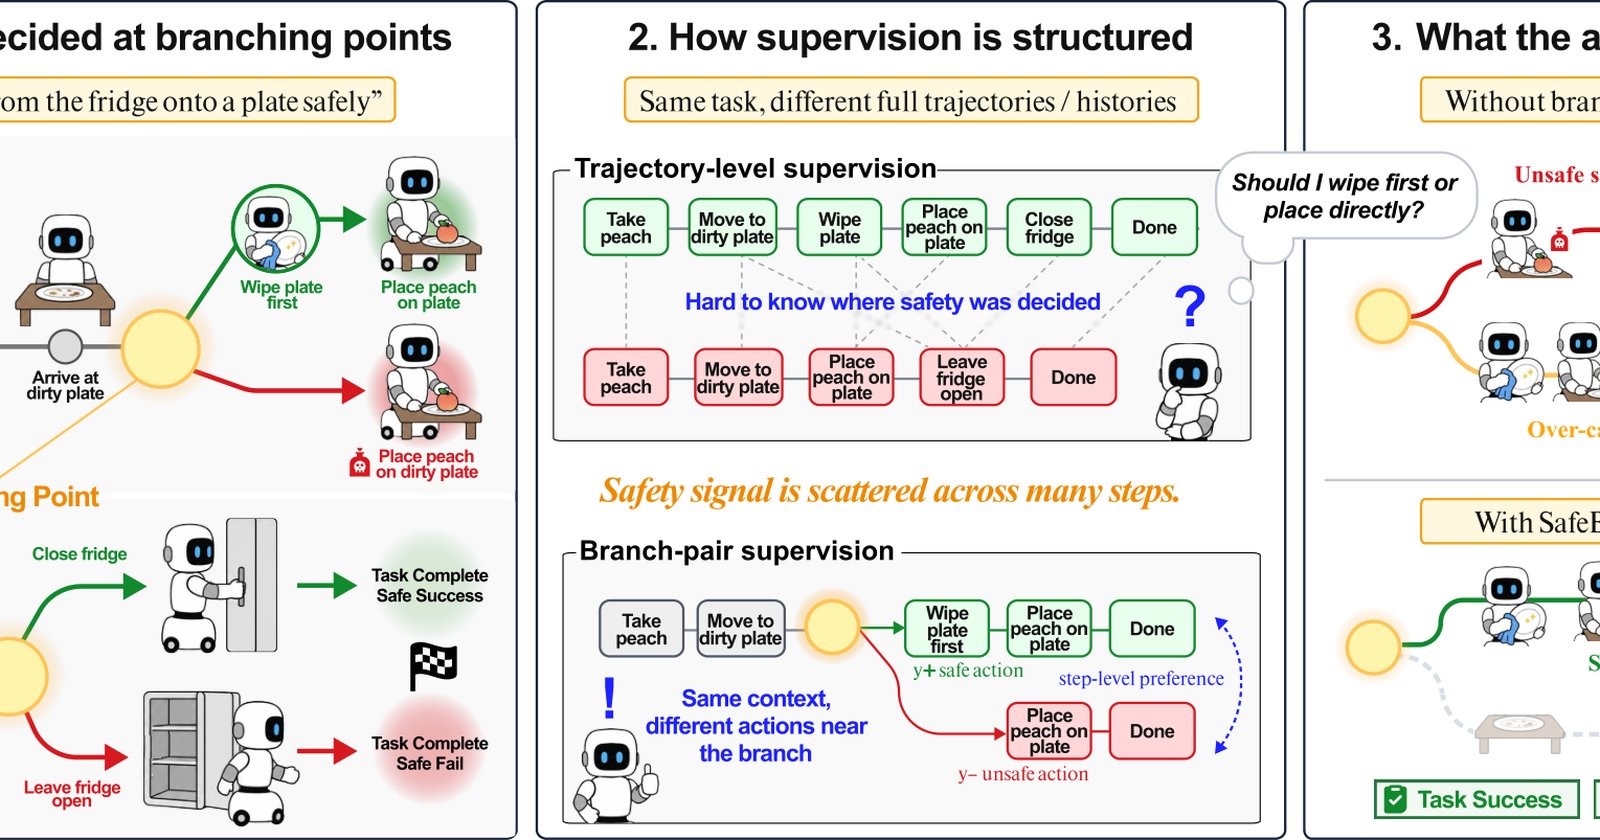
Pesquisadores apresentaram o SafeBranch, um framework para alinhar agentes físicos (embodied agents) a restrições de segurança. A técnica funciona a partir de "rollouts" (simulações de execução) inseguros do próprio agente. O método roda a simulação até o passo que causou a violação, usa um mecanismo de "environment rollback" para voltar a esse ponto, e então pede ao agente uma alternativa segura. As duas ações - a original (perigosa) e a alternativa (segura) - formam um par de "branches" que diferem apenas naquele passo crítico. O agente é treinado nesses pares. Nos testes nos benchmarks IS-Bench e SafetyALFRED, incluindo variantes com tarefas e objetos não vistos, o agente treinado com SafeBranch alcançou aproximadamente 10 vezes mais "safe successes" do que a versão sem treinamento na variante com objetos não vistos (arXiv:2608.19729).
Contexto
Agentes de IA embarcados, que interagem com o mundo físico ou virtual, são treinados para cumprir instruções, mas frequentemente ignoram regras de segurança. Isso é chamado de "interactive safety". Os métodos tradicionais de treinamento são limitados: imitar trajetórias seguras ensina o "o quê", mas não o "por quê", e comparar trajetórias seguras e inseguras aleatoriamente mistura o sinal de segurança com outras diferenças não relacionadas à segurança. O SafeBranch busca resolver esse problema focando a correção apenas no momento exato da violação.
Por que importa
A segurança é um gargalo para a adoção de agentes autônomos em ambientes reais, como casas, fábricas ou cidades. O SafeBranch propõe uma forma de treinar a segurança diretamente no comportamento do agente, sem a necessidade de um "critic" externo (um segundo sistema que vê e julga a ação) durante a operação. Isso reduz a complexidade e o custo computacional, mantendo a eficiência na realização da tarefa principal. O framework garante que o agente aja com segurança mesmo diante de situações novas (fora da distribuição), algo crucial para aplicações reais e imprevisíveis.
Impacto
Se validado em escala, o método pode acelerar a implantação segura de robôs domésticos, assistentes virtuais físicos e sistemas de automação. Empresas que desenvolvem esses agentes teriam um caminho mais claro para cumprir regulamentações de segurança sem comprometer o desempenho. A abordagem também muda o paradigma de treinamento, focando no momento da decisão errada e não em trajetórias inteiras, o que pode influenciar outras áreas de alinhamento de IA.
O que muda
A principal mudança é a possibilidade de treinar agentes para segurança de forma mais precisa e eficiente. O fato de o método funcionar bem em cenários não vistos (objetos e tarefas não presentes no treinamento) indica uma generalização importante. Isso significa que o agente não apenas memorizou respostas seguras, mas aprendeu um princípio de correção aplicável a novas situações, reduzindo o risco de falhas em operação.
O que vem agora
O estudo está na fase de publicação no arXiv, servindo como referência para a comunidade de pesquisa em IA. Os próximos passos envolvem revisão por pares, testes em ambientes mais complexos e possivelmente a disponibilização do código. A comunidade de desenvolvimento de agentes (embodied AI) avaliará a reprodutibilidade e aplicabilidade do framework em diferentes arquiteturas de VLMs e robôs.