
SciDSK: Nova representação de dados científicos para agentes de IA
Paper do arXiv apresenta Scientific Data Skill para superar barreiras na descoberta e uso autônomo de conjuntos de dados.
O que aconteceu
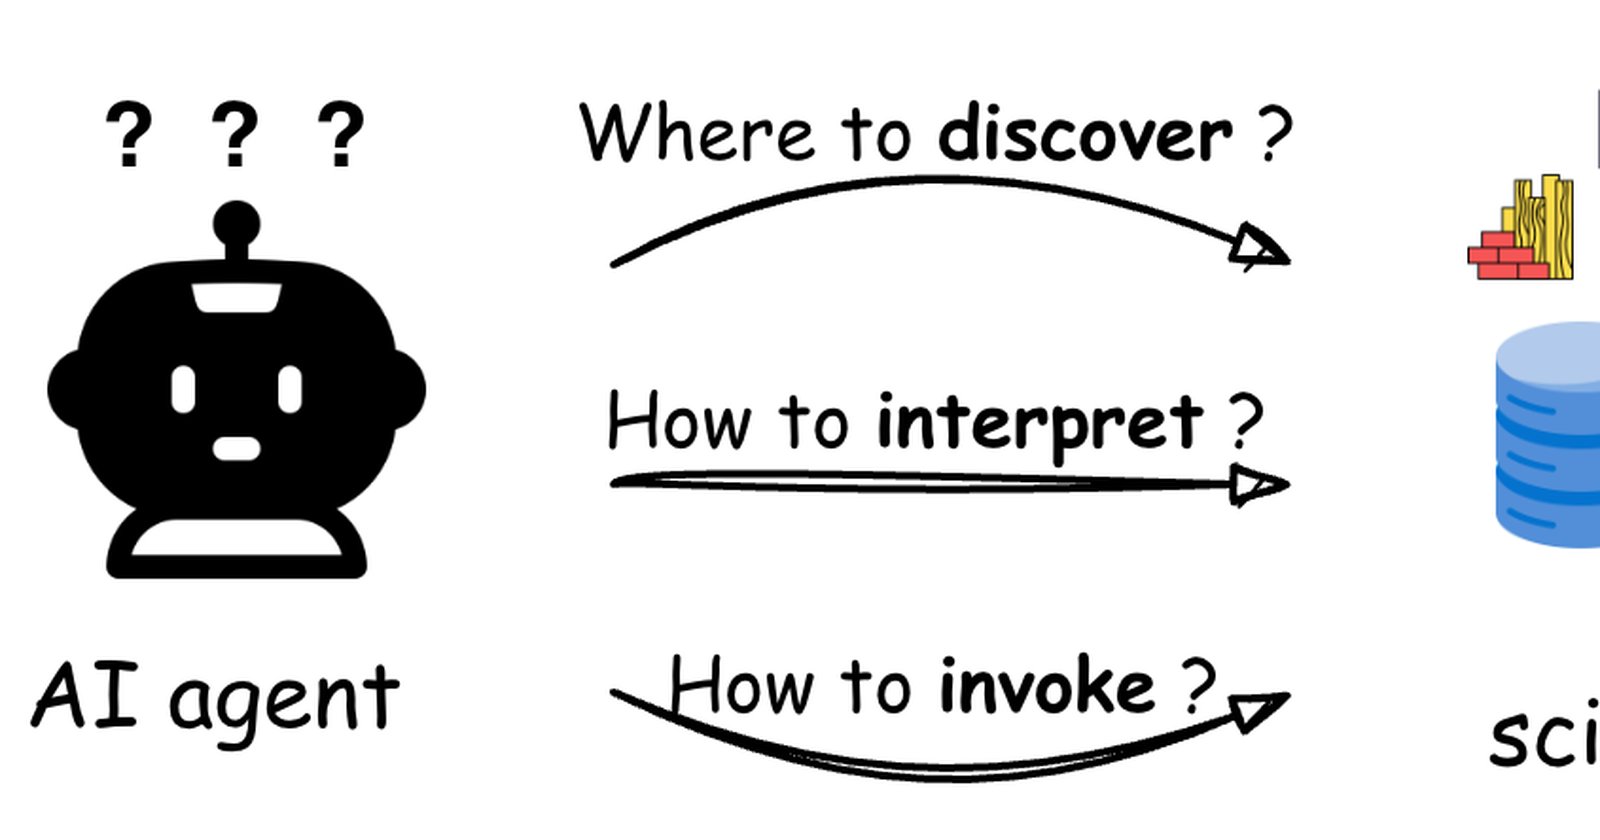
Pesquisadores da área de computação publicaram no arXiv, em 20 de agosto de 2026, um artigo que introduz o Scientific Data Skill (SciDSK). Trata-se de uma nova representação de dados, descrita como "agent-ready", projetada para empacotar conhecimento específico de conjuntos de dados (datasets) em uma "habilidade" reutilizável para agentes de IA. O projeto também apresenta o Scientific Data Skill Bank, uma plataforma unificada que publica esses recursos SciDSK em seis disciplinas científicas, oferecendo acesso a pacotos, identificação persistente e rastreabilidade até os conjuntos de dados originais (arXiv).
A avaliação inicial, realizada por meio de um benchmark de recuperação para descoberta de datasets e casos controlados para interpretação, mostrou que o SciDSK melhora a capacidade dos agentes de descobrir dados automaticamente e oferece suporte mais preciso e acionável para sua interpretação (arXiv).
Contexto
A pesquisa científica gera dados massivos, armazenados em repositórios heterogêneos. Com o avanço dos agentes de IA, esses dados são cada vez mais consumidos de forma autônoma. O problema central é que as representações atuais desses datasets foram projetadas principalmente para humanos, o que cria barreiras para a descoberta, interpretação e invocação por máquinas. A fragmentação dos dados entre diferentes plataformas agrava a dificuldade para os agentes de IA, que precisam navegar e compreender essas estruturas de forma independente (arXiv).
Por que importa
Para o ecossistema de IA e pesquisa científica, o SciDSK oferece uma padronização que pode reduzir drasticamente o tempo e o custo de curadoria manual para uso por agentes. Em vez de cada agente precisar aprender a estrutura única de cada repositório, ele pode interagir com uma representação unificada e rica em contexto. Isso pode acelerar a automação de análises científicas, desde revisão de literatura até síntese de dados experimentais, impactando pesquisadores, desenvolvedores de IA e organizações que gerenciam grandes acervos de dados.
Impacto
No curto prazo, a iniciativa pode impulsionar a adoção de agentes em workflows de pesquisa que dependem de múltiplos conjuntos de dados. No médio prazo, a existência de uma especificação estruturada como o SciDSK pode promover maior interoperabilidade entre repositórios científicos, que passariam a oferecer uma camada de dados otimizada para consumo por software autônomo. A criação de um "banco de habilidades" centralizado também estabelece um novo modelo para descoberta e acesso a recursos de dados.
O que muda
A mudança fundamental é a inversão de prioridade: em vez de dados formatados apenas para exibição em um navegador, surge uma camada de metadados complexos e orientações operacionais projetadas para a "compreensão" de um agente. O SciDSK não move os dados de sua origem, mas adiciona uma husky de conhecimento (descrição, contexto, organização, procedimentos, qualidade e proveniência) que torna esses dados acionáveis de forma autônoma.
O que vem agora
O SciDSK Specification e o Scientific Data Skill Bank já estão disponíveis como parte desta pesquisa (arXiv). Os próximos passos envolvem a expansão da plataforma para mais disciplinas científicas, além da investigação de integrações com os principais frameworks de agentes de IA e repositórios científicos existentes para tornar a geração e o consumo dessas "habilidades" um padrão.