
Second Thought: como raciocínio paralelo acelera agentes de IA
Framework de inferência que rova raciocínios em paralelo durante a espera por ações externas, ganhando velocidade sem perder acurácia
O que aconteceu
Em 13 de agosto de 2026, foi publicado no arXiv um artigo que apresenta o Second Thought, um framework de inferência (que não precisa de treino) para agentes baseados em grandes modelos de linguagem (LLMs). O método foi testado em três benchmarks agênticos e três modelos de raciocínio diferentes.
O resultado principal: em todos os nove pares (modelo, benchmark) testados, o Second Thought reduziu o número médio de turnos necessários. Em seis desses cenários, a decodificação no thread principal (o ciclo principal do agente) caiu em até 43%, com média de redução de cerca de 20% nos cenários onde houve melhora. A taxa de acerto (Pass@1) não mudou significativamente em sete dos nove pares, sendo que os dois pares com diferença significativa mostraram ganhos de +12.4 e +10.2 pontos.
Contexto
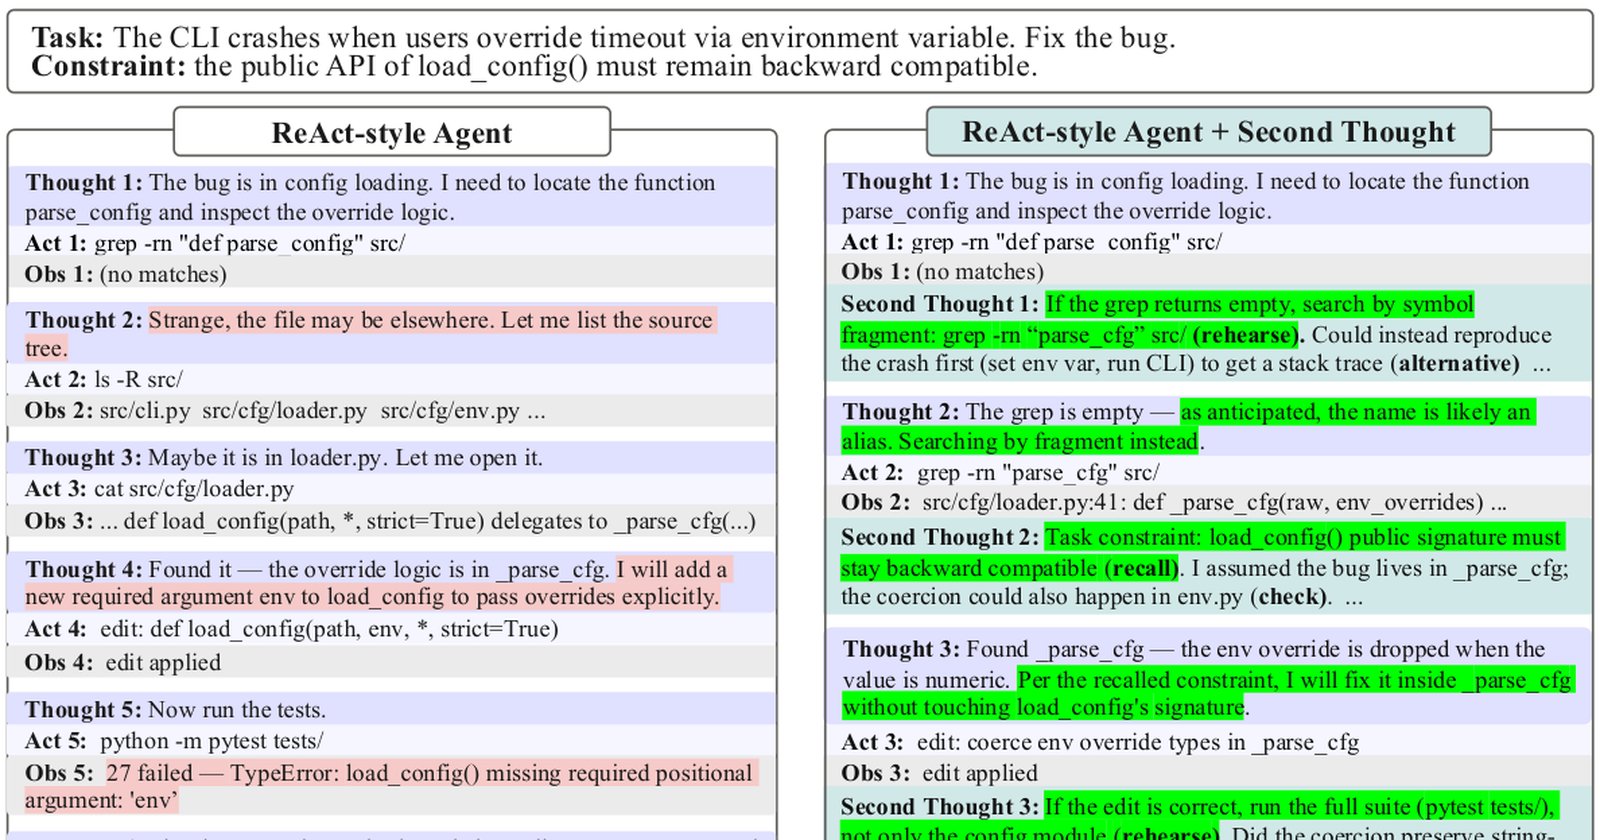
O problema se encontra no paradigma ReAct, que alterna entre raciocinar (Thought), agir (Action) e observar (Observation). Durante a fase de ação e observação, quando o agente envia um comando e aguarda o resultado do ambiente, seu raciocínio fica congelado. Os autores identificaram esse período como uma "janela de ociosidade para raciocínio" (reasoning idle window).
O Second Thought propõe que, no instante em que a fase Thought conclui, o framework crie quatro ramificações auxiliares paralelas. Essas ramificações continuam raciocinando de forma independente enquanto o thread principal执行a a ação e aguarda a observação. Quando a observação retorna, os pensamentos gerados paralelamente são integrados de volta ao fluxo principal.
Por que importa
Agentes autônomos que usam LLMs para navegar ferramentas, códigos ou APIs são uma das aplicações mais promissoras da IA, mas sua velocidade é limitada justamente por essas esperas sequenciais. O Second Thought oferece um caminho concreto para tornar esses agentes mais eficientes em termos de computação, sem precisar retreinar os modelos.
A redução de até 43% na decodificação sequencial pode significar respostas mais rápidas e custos menores de inferência para empresas que já utilizam ou planejam usar agentes de IA em fluxos de trabalho. O fato de a acurácia não cair — e em alguns casos até melhorar — é crucial para a adoção prática.
Impacto
No curto prazo, o framework pode ser integrado a sistemas existentes de agentes com ajustes mínimos, já que é "training-free". Isso acelera a experimentação para equipes de pesquisa e desenvolvimento.
No médio prazo, a técnica pode influenciar a forma como novos frameworks de agentes são projetados, com a parallelização do raciocínio em momentos de espera se tornando uma abordagem padrão para otimização. Pode também reduzir a dependência de hardware mais potente para obter respostas rápidas em tarefas complexas.
O que muda agora
O Second Thought demonstra que a eficiência de agentes de IA não depende apenas de modelos maiores ou mais rápidos, mas de arquiteturas de inferência mais inteligentes. Ao explorar os "tempos mortos" do processo atual, abre uma via de otimização que pode ser combinada com outras técnicas.
O que vem agora
O estudo é preliminar (publicado como paper no arXiv). Os próximos passos lógicos incluem validação em ambientes de produção, testes com uma gama mais ampla de tarefas e modelos, e a liberação de código para que a comunidade possa implementar e adaptar o framework. A integração com ecossistemas populares de agentes (como LangChain ou AutoGPT) seria um passo importante para sua adoção.