
StateSight: Benchmark Testa Raciocínio Espacial em Modelos de IA Visual
Estudo revela que respostas formatadas corretamente podem esconder falhas na compreensão visual profunda.
O que aconteceu
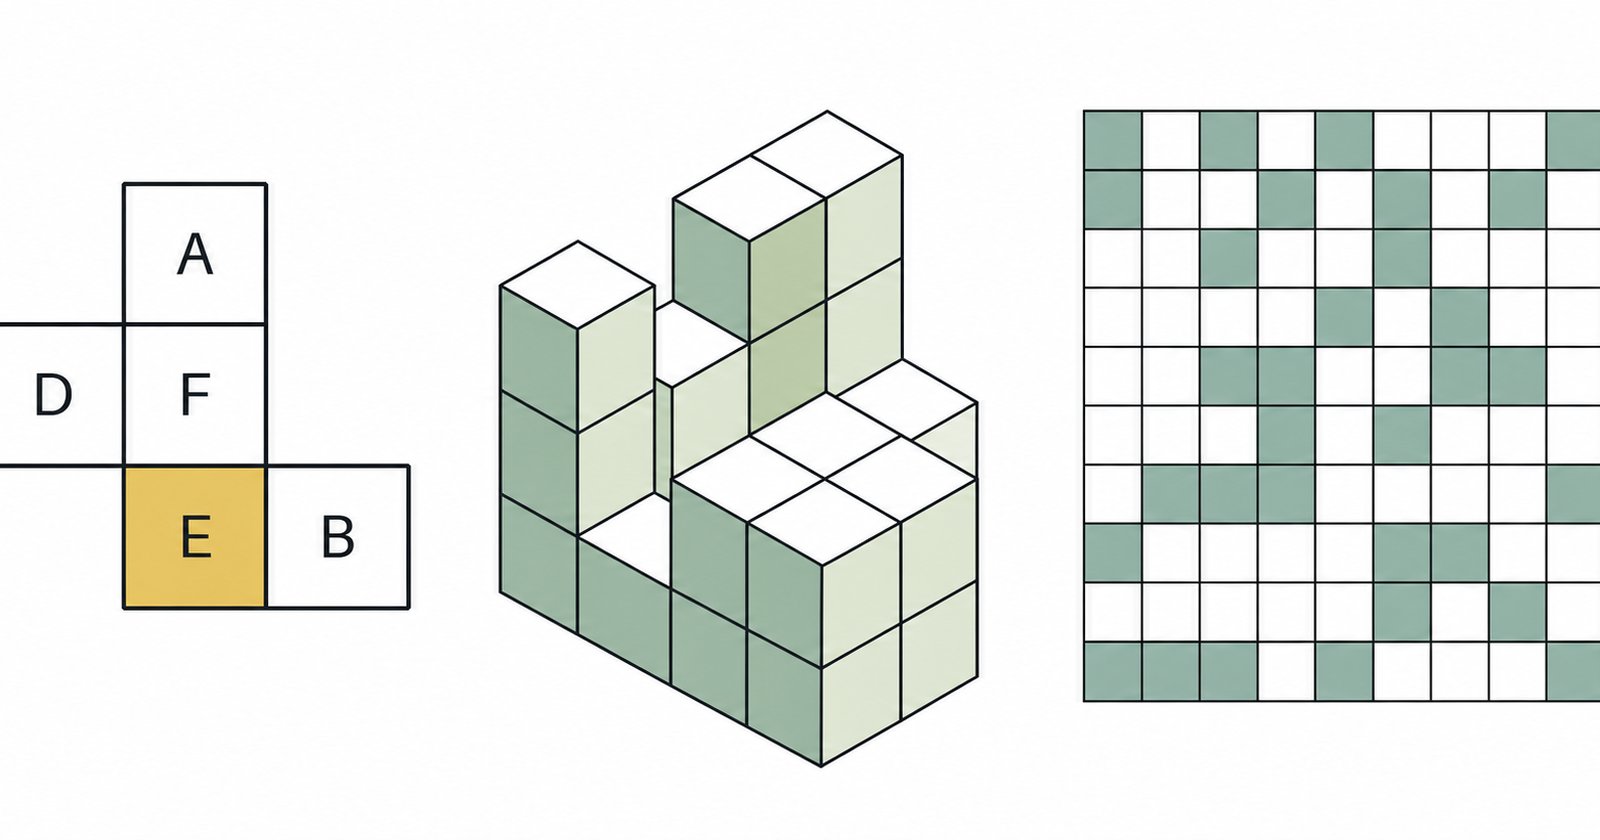
O paper "StateSight: Benchmarking Latent Spatial-State Reconstruction in Vision-Language Models", publicado no repositório arXiv em 15 de agosto de 2026, introduziu um novo benchmark proceduralmente gerado para isolar a capacidade de modelos de linguagem visuais (VLMs) de reconstruir estrutura espacial latente. O StateSight foca em três famílias de tarefas: cube-net opposite-face reasoning (raciocínio sobre faces opostas de um cubo desenvolvido), occluded cube-tower counting (contagem de torres de cubos ocluídos) e 4-neighbor connected-component counting (contagem de componentes conectados por 4 vizinhos). Cada uma das três famílias contém 300 prompts de imagem única com rótulos oraculares determinísticos e é avaliada por pontuação de correspondência exata. O modelo GPT-5.5, da OpenAI, acessado via o identificador de API "gpt-5.5", alcançou uma precisão de 59.3% na primeira tarefa, 33.3% na segunda e 28.3% na terceira. O Claude Sonnet 5, da Anthropic, obteve 53.3%, 18.7% e 7.3%, respectivamente. Todos os testes diretos finais ("direct runs") dos modelos apresentaram zero erros de formato na resposta. Como baseline, um estudo com 30 participantes humanos resolveu 60 itens do benchmark, obtendo precisões médias de 80.8%, 68.8% e 64.3% nas três tarefas, superando ambos os modelos em todas elas. A análise "visible-derivation" identificou erros recorrentes na reconstrução da imagem-estado e no procedimento de raciocínio. O estudo também lançou o StateSight-Steps, um dataset complementar com 900 exemplos interleaved de imagem-texto e 3.600 estados visuais intermediários determinísticos.
Contexto
Os modelos de linguagem visuais, como o GPT-5.5 e o Claude Sonnet 5, são cada vez mais utilizados para question answering multimodal, processando imagens e texto conjuntamente. No entanto, a capacidade de isolar a habilidade específica de reconstruir a estrutura espacial latente de uma imagem isolada era difícil de avaliar. Benchmarks tradicionais e amplos, como os comumente usados na avaliação de VLMs, frequentemente combinam múltiplas competências: percepção visual básica, reconhecimento de caracteres ópticos (OCR), conhecimento de domínio específico, vieses linguísticos e raciocínio lógico-espacial na mesma métrica. Essa mistura torna difícil identificar onde um modelo está falhando exatamente. O StateSight foi criado para contornar esse problema, projetando tarefas que forçam a reconstrução e o raciocínio sobre estados espaciais ocultos a partir de uma única imagem, minimizando a ajuda de priors linguísticos ou conhecimento externo.
Por que importa
O impacto prático do StateSight é revelar uma falha crítica na avaliação de IA avançada: o fato de que respostas formatadas corretamente e aparentemente coerentes podem mascarar uma incapacidade fundamental de recuperar a estrutura espacial necessária para uma inferência visual verificável. Isso tem implicações diretas para o desenvolvimento de sistemas de IA confiáveis em campos que dependem de compreensão visual precisa, como robótica, veículos autônomos, assistentes visuais para deficientes e análise de imagens médicas ou industriais. Empresas que desenvolvem ou utilizam VLMs agora têm uma métrica mais clara e isolada para diagnosticar e melhorar essas capacidades específicas. O fato de o GPT-5.5, um dos modelos mais avançados do mercado, ter atingido apenas 28.3% na tarefa mais difícil (connected-component counting) mostra que há uma lacuna significativa entre a performance atual e a necessária para automação visual confiável.
Impacto
As consequências de curto e médio prazo são direcionar pesquisas e investimentos para melhorar a componentes espaciais dos VLMs. No curto prazo, o benchmark fornece uma nova referência pública e rigorosa para a comunidade de IA. Desenvolvedores de modelos agora podem usar o StateSight para testar versões futuras, focando não apenas na acurácia final, mas na capacidade de gerar um "derivation" (derivação visível) correta do raciocínio. No médio prazo, pode surgir uma geração de modelos treinados com dados como os do StateSight-Steps, que contém 3.600 estados intermediários, para melhorar a transparência e a acurácia do processo de raciocínio visual. A disparidade entre o desempenho dos humanos e da IA também reforça que, para muitas tarefas de senso comum espacial, a supervisão humana continua essencial em sistemas críticos.
O que muda
O principal resultado é a confirmação de que a precisão em benchmarks tradicionais pode não refletir a compreensão real do mundo visual. A pesquisa estabelece um novo padrão de isolamento de habilidades para avaliar VLMs. A introdução do StateSight-Steps como dataset aberto também facilita o desenvolvimento de técnicas de treinamento mais sofisticadas, focadas em estados intermediários e raciocínio passo a passo. Modelos futuros da OpenAI e da Anthropic provavelmente serão avaliados contra esse benchmark para medir progresso real em raciocínio espacial.
O que vem agora
Os autores do paper disponibilizaram o benchmark StateSight para uso da comunidade de pesquisa. Próximos passos incluem a possibilidade de expandir o conjunto de tarefas para cobrir mais tipos de raciocínio espacial e testar uma gama mais ampla de modelos comerciais e de código aberto. A comunidade de IA também pode usar o dataset StateSight-Steps para desenvolver e benchmarkar métodos novos de chain-of-thought visual ou raciocínio interativo. A data de publicação do paper, 15 de agosto de 2026, marca um ponto de referência para a avaliação de VLMs voltados para compreensão espacial profunda.