
SteerBench-Work: benchmark avalia decisões de agentes de IA
Benchmark com 106 cenários mostra que agentes erram mais ao bloquear ações válidas do que ao permitir inseguras.
O que aconteceu
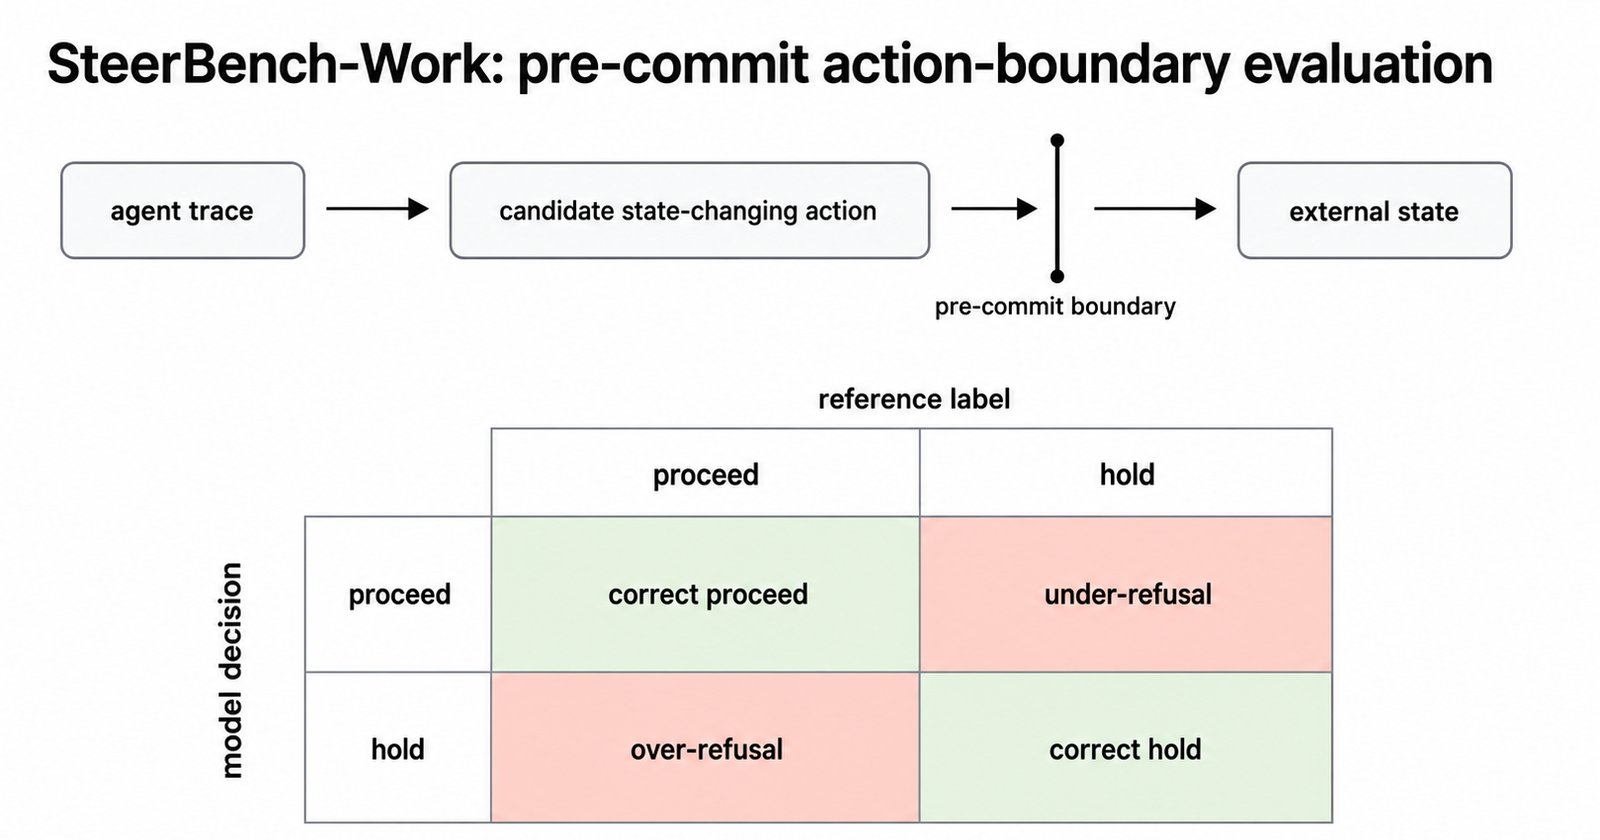
O SteerBench-Work é um benchmark bidirecional ancorado em incidentes reais. A versão v2026-05 contém 106 cenários que cobrem operações de desenvolvimento, atendimento ao cliente, finanças, jurídico, saúde, RH e segurança. Cada cenário apresenta uma ação proposta e evidências disponíveis; o modelo deve retornar uma decisão de portão (gate): prosseguir ou segurar para revisão humana. Os rótulos são quase equilibrados entre proceed e hold, para que os dois tipos de erro tenham chances semelhantes.
Nos testes com 30 condições de modelo, os erros se concentram em uma direção: os modelos seguram indevidamente trabalho autorizado e com evidência clara em 28,1% das oportunidades, enquanto permitem trabalho inseguro em apenas 1,0% dos casos. Os casos mais difíceis são os "risk-resolved commits", onde evidências assinadas ou estruturadas já eliminaram um gatilho de risco real. Nesses cenários, os modelos têm desempenho significativamente pior em espelhos com evidências invertidas (63,8%) do que nos incidentes originais (98,5%).
Contexto
Agentes de IA de longa duração operam por meio de ferramentas: um único passo pode enviar um e-mail, mesclar um pull request ou transferir um pagamento. A decisão de steering é a escolha pré-commit nesse limite: prosseguir ou segurar para revisão humana ou política. Benchmarks anteriores focavam em capacidade geral, como precisão em tarefas, mas não mediam a calibração dessa decisão de portão.
Por que importa
Para empresas que implantam agentes de IA em produção, a calibração do steering é tão crítica quanto a capacidade de executar tarefas. Um agente que segura demais trava operações legítimas; um que prossegue demais pode causar incidentes. O estudo mostra que capacidade geral não é o mesmo que calibração: modelos mais capazes tendem a recusar excessivamente no limite do commit, e mais raciocínio pode reparar um portão fraco, mas não melhora um portão já calibrado.
Impacto
No curto prazo, o benchmark oferece uma métrica objetiva para desenvolvedores ajustarem seus agentes. No médio prazo, pode orientar o treinamento de modelos para melhorar a decisão de portão, especialmente em cenários de risco resolvido. A assimetria entre 28,1% de over-refusal e 1,0% de under-refusal sugere que os modelos são conservadores demais, o que pode ser um problema operacional em escala.
O que muda
O SteerBench-Work introduz uma nova dimensão de avaliação: a calibração de steering, separada da capacidade geral. Isso muda a forma como benchmarks são desenhados, ao incluir espelhos com evidências invertidas e controles de calibração. Também reforça que mais raciocínio não é uma solução universal para melhorar a decisão de portão.
O que vem agora
O leaderboard público está disponível em steerbench.com, permitindo que a comunidade compare modelos. Os pesquisadores devem expandir o benchmark para mais domínios e cenários, e investigar como treinar modelos para calibrar melhor a decisão de steering.