
Survey mapeia agentes de IA para séries temporais em 4 categorias
Pesquisa submetida em agosto de 2026 organiza o campo por problemas, não por técnicas isoladas
O que aconteceu
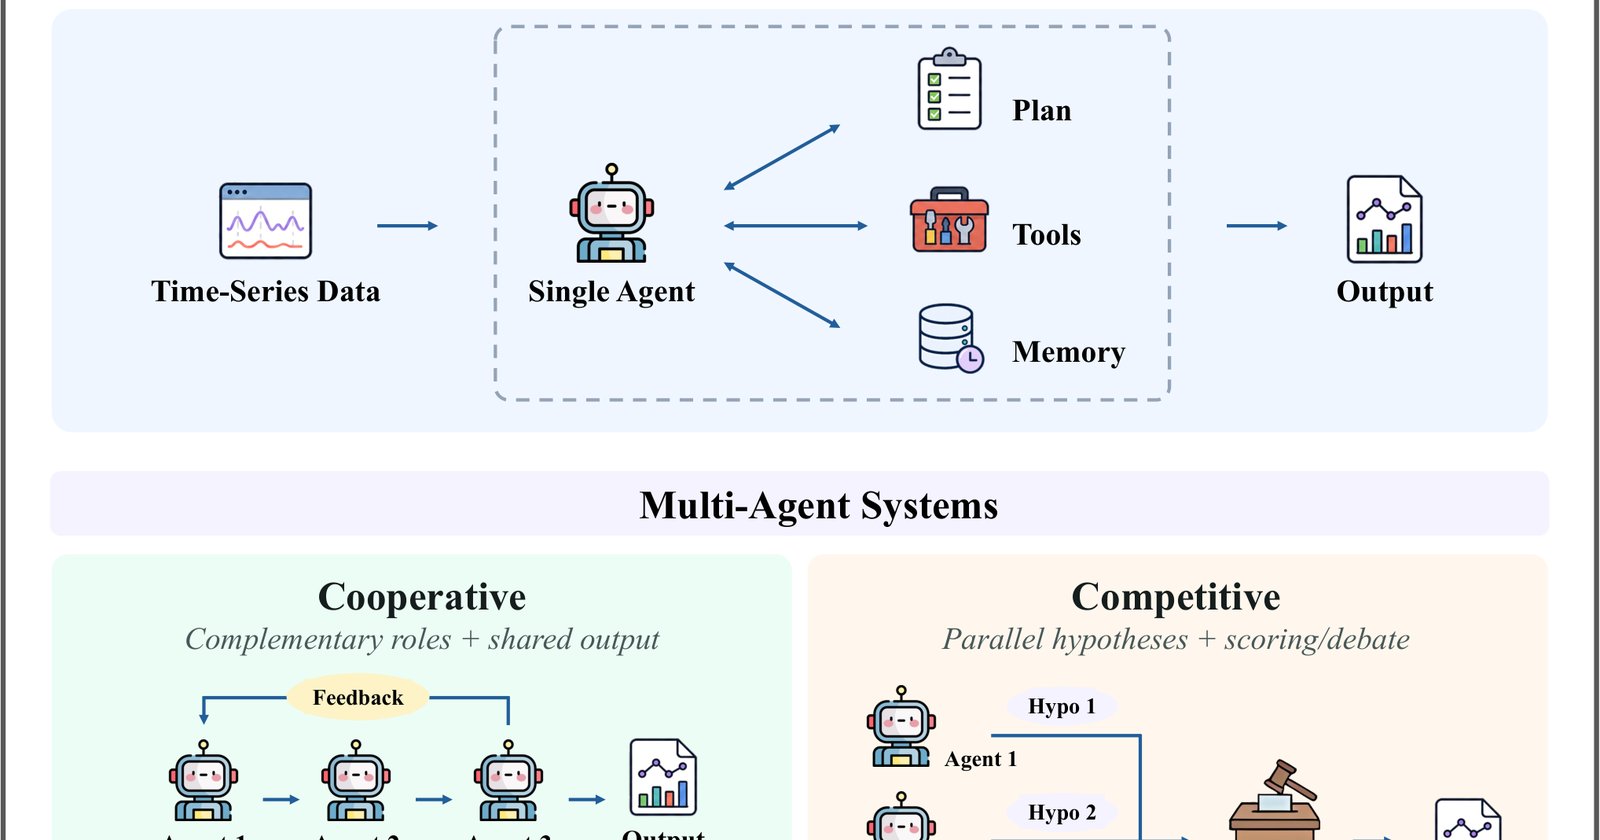
O paper intitulado "LLM Agents for Time-Series: A Survey" foi publicado no arXiv (ID 2608.26226) na área de Computer Science, subárea Artificial Intelligence, em 26 de agosto de 2026. O trabalho, que teve sua primeira visualização registrada em 28 de agosto de 2026, analisa como agentes baseados em grandes modelos de linguagem estão sendo desenvolvidos para problemas de séries temporais. O survey adota uma taxonomia orientada a problemas, agrupando os sistemas existentes em quatro categorias: previsão e raciocínio, aumento e síntese, detecção e diagnóstico de anomalias, e suporte a decisões.
O estudo examina como os requisitos de cada tarefa moldam a arquitetura do agente, o uso de ferramentas e o design de memória. Além disso, o survey resume conjuntos de dados e ambientes representativos, comparando o desempenho relatado dos modelos em configurações semelhantes ou compartilhadas.
Contexto
A área de séries temporais sempre dependeu de métodos estatísticos clássicos, como ARIMA e suavização exponencial, e, mais recentemente, de redes neurais como LSTMs e Transformers. Com a popularização dos LLMs, pesquisadores começaram a explorar agentes que combinam raciocínio linguístico com análise numérica. A proposta do survey é justamente organizar essa produção dispersa, que cresceu sem um consenso sobre boas práticas. A escolha por uma taxonomia baseada em problemas, e não em técnicas, reflete uma tendência de tornar o campo mais aplicável às necessidades reais de cada cenário.
Por que importa
Para pesquisadores, o survey oferece um guia prático para projetar agentes de LLM em problemas de séries temporais, com a identificação de lacunas abertas que podem direcionar futuras pesquisas. Para empresas que trabalham com previsão de demanda, detecção de fraudes ou monitoramento de sensores, a categorização ajuda a entender quais abordagens são mais adequadas a cada tipo de tarefa. O estudo também padroniza a comparação de desempenho entre modelos, algo essencial em um campo onde os resultados muitas vezes não são diretamente comparáveis devido a diferenças nos conjuntos de dados e métricas.
Impacto
A curto prazo, o survey deve funcionar como um ponto de partida para novos artigos, que poderão citar a taxonomia como referência para justificar suas escolhas de design. A médio prazo, a comparação de desempenho sob configurações compartilhadas pode reduzir a fragmentação do campo, facilitando a reprodução de resultados. Um impacto prático é a possibilidade de empresas usarem a classificação para avaliar rapidamente quais soluções de agentes já existem para o seu problema, antes de desenvolver uma do zero. A ausência de uma análise sobre custo computacional ou latência, porém, limita o uso imediato em aplicações de tempo real, que exigem respostas rápidas.
O que muda
O survey muda a forma como o campo se organiza. Antes, era comum classificar agentes de LLM por componentes, como o modelo base ou a técnica de prompting. A nova abordagem coloca o problema no centro, o que aproxima a pesquisa da prática de engenharia. Para quem desenvolve sistemas, isso significa que a escolha de um agente passa a ser guiada pela tarefa específica, como detectar anomalias em uma série financeira, em vez de pela hype em torno de um determinado modelo. O trabalho também destaca a importância do design de memória e do uso de ferramentas, elementos que muitas vezes são tratados como detalhes.
O que vem agora
O próprio abstract do survey aponta a identificação de lacunas abertas para trabalho futuro, mas não detalha quais são. Espera-se que os autores apresentem essas lacunas em versões expandidas do paper ou em apresentações em conferências da área, como a NeurIPS ou a ICML, que costumam ocorrer no fim do ano. Para a comunidade, o próximo passo natural é a criação de benchmarks padronizados que sigam a taxonomia proposta, permitindo comparações mais justas entre agentes. Enquanto isso, grupos de pesquisa podem começar a usar o guia para escolher os problemas mais promissores, especialmente nas áreas de suporte a decisões e síntese de dados, que parecem menos exploradas segundo a estrutura do estudo.