
Teste com MD5 avalia rastreamento de estado em LLMs
Estudo submetido ao arXiv em agosto de 2026 isola a dificuldade de manter estado intermediário e mostra que contexto e votação são cruciais
O que aconteceu
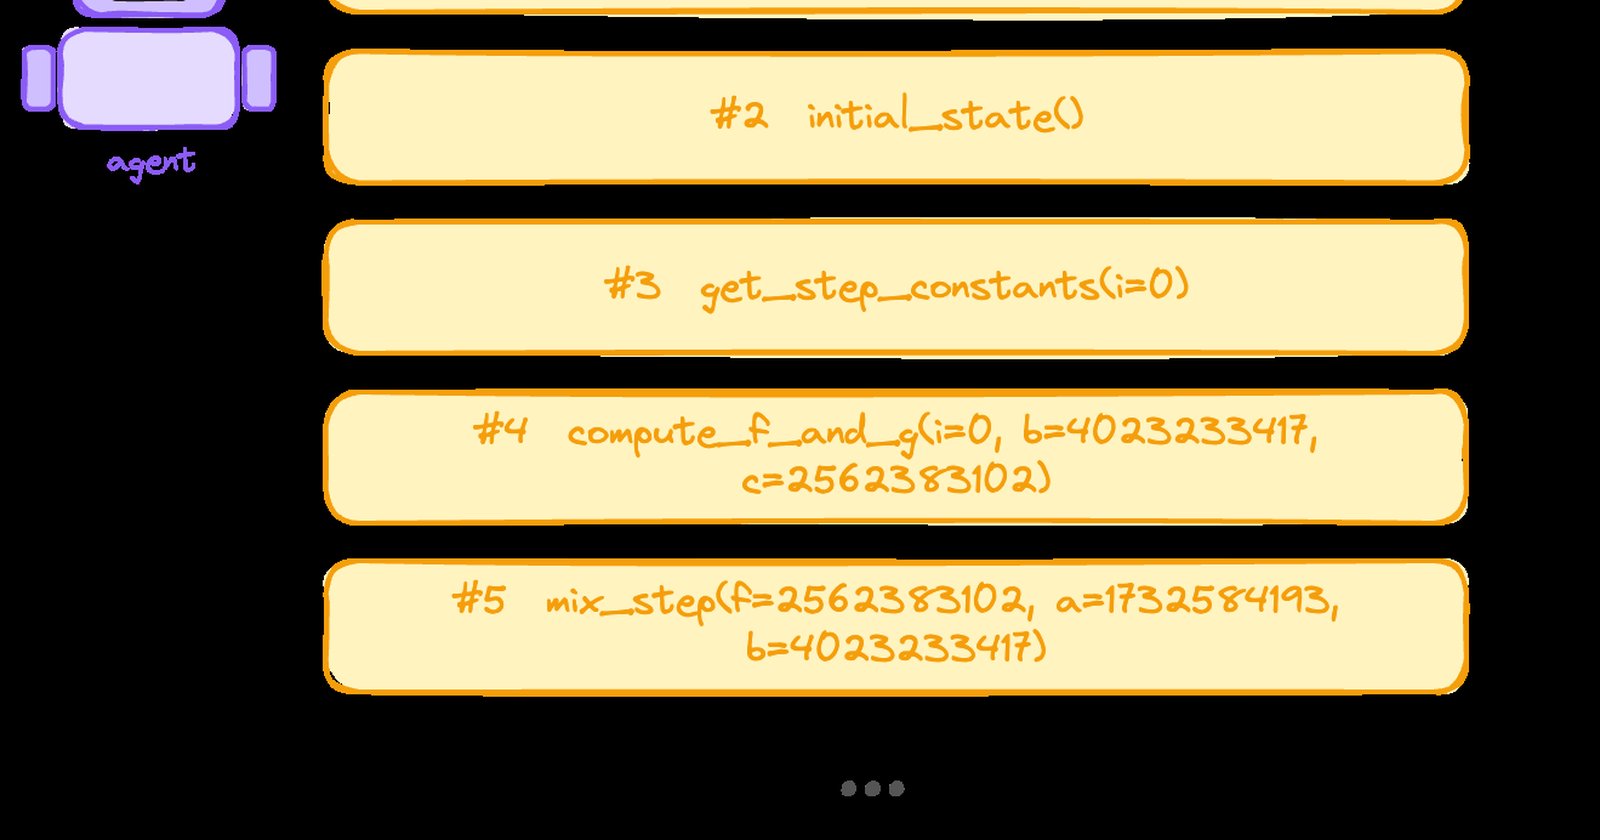
O estudo submetido ao arXiv em 2 de agosto de 2026 (arXiv:2609.00012) propõe um teste limpo para avaliar o rastreamento de estado em LLMs. A tarefa é calcular o hash MD5 passo a passo, o que exige uma sequência de 196 chamadas de ferramentas dependentes, distribuídas em 64 rodadas. O modelo precisa carregar quatro palavras de 32 bits (a, b, c, d) no próprio contexto, de uma chamada para a próxima. A interpretação é trivial, e como o MD5 é implementado do zero (RFC 1321), cada chamada é alinhada ao rastreamento real e o digest é verificado ao bit. Qualquer falha é puramente de manutenção de estado.
O modelo testado foi o gpt-oss-120b, um mixture-of-experts com cerca de 5,5B de parâmetros ativos por token, operando a temperatura 0 e com prompt fixo curto. Ele carregou o estado completo por todas as 196 chamadas e retornou o digest correto na maioria das execuções concluídas. Na configuração mais forte, os pesquisadores substituíram cada ferramenta primitiva por um segundo LLM, de modo que um driver e um worker calculam o hash do zero, sem oráculo de aritmética exata. Dois ingredientes decidiram o sucesso, sem alterar os pesos: manter o raciocínio do modelo no contexto a cada turno, e votar sobre um worker com pensamento habilitado para corrigir erros de aritmética modular.
Contexto
Tarefas de longo horizonte são raras na avaliação de LLMs. Quando cada passo depende do anterior, a precisão por passo que parece excelente isoladamente decai catastroficamente, com erros em cascata e a probabilidade de falha final crescendo rapidamente com o comprimento. Benchmarks agênticos existentes reportam sucesso de ponta a ponta, mas confundem a dificuldade de rastreamento de estado com interpretação de instruções, não têm grupo de controle que isole esse fator, e são vulneráveis a atalhos como uma resposta final alucinada. Por isso, não conseguem explicar por que uma execução longa falha. O estudo preenche essa lacuna ao isolar o rastreamento de estado, já que a interpretação é trivial e o resultado é verificável ao bit.
Por que importa
Este é um dos primeiros testes a isolar a capacidade de um LLM carregar estado intermediário exato ao longo de muitas chamadas de ferramentas dependentes. O resultado é positivo: o gpt-oss-120b consegue na maioria das vezes, mesmo com poucos parâmetros ativos. Isso tem implicações para sistemas de agentes que usam ferramentas em cadeia. Se o modelo mantém estado, a falha em tarefas longas pode ser atribuída a outros fatores, como erros aritméticos ou de serviço, e não a uma limitação fundamental de memória. Além disso, o estudo mostra que soluções de inferência, como manter o raciocínio no contexto e votação, podem melhorar o desempenho sem retreinar o modelo, o que é economicamente relevante.
Impacto
No curto prazo, a comunidade de pesquisa ganha um benchmark limpo para testar rastreamento de estado. O uso de MD5 é engenhoso por ser determinístico, passo a passo e fácil de verificar. No médio prazo, pode levar a melhores designs de agentes, com mais atenção ao contexto e à votação entre múltiplas execuções. O estudo também localiza falhas residuais por origem, separando transporte de estado, aritmética e serviço. Isso ajuda a direcionar melhorias específicas, como melhorar a precisão aritmética ou a infraestrutura de servidor.
O que muda
Antes, não se sabia se um LLM poderia carregar estado exato por dezenas de chamadas. Agora, há evidência de que sim, pelo menos para o gpt-oss-120b em configurações específicas. A mudança de perspectiva é importante: a falha em tarefas longas não é necessariamente de memória, mas de erros aritméticos ou de serviço, que podem ser mitigados. Para empresas que desenvolvem agentes, a dica prática é manter o raciocínio do modelo no contexto e usar votação com um worker com capacidade de pensamento, o que pode reduzir erros sem custo de treinamento.
O que vem agora
O artigo é uma submissão ao arXiv, ainda sem revisão por pares (Announce Type: new). O próximo passo é a validação pela comunidade. Os pesquisadores podem expandir o teste para outros hashes, como SHA-256, ou para sequências mais longas, para ver até onde o rastreamento aguenta. Há espaço para testar outros modelos, não apenas gpt-oss-120b, e para investigar como o desempenho escala com o número de parâmetros ativos. Também pode inspirar a criação de benchmarks mais realistas que isolem diferentes componentes de tarefas de agente.