
TileMix: Kernel Preciso Acelera Inferência de LLMs Longos
Novo kernel roteia precisão numérica por tiles, mantendo a qualidade em contextos longos
O que aconteceu
Uma nova técnica de otimização para inferência de LLMs, denominada TileMix, foi publicada no repositório de artigos científicos arXiv. O estudo demonstra que o método é capaz de acelerar o processo de "prefill" (quando o modelo processa o prompt inicial) em contextos longos, enquanto preserva a qualidade das respostas que normalmente se degrada com outras abordagens. Os testes foram conduzidos em benchmarks como LongEval e LV-Eval, utilizando modelos conhecidos como LLaMA, Qwen e Vicuna, em uma GPU NVIDIA A100.
Contexto
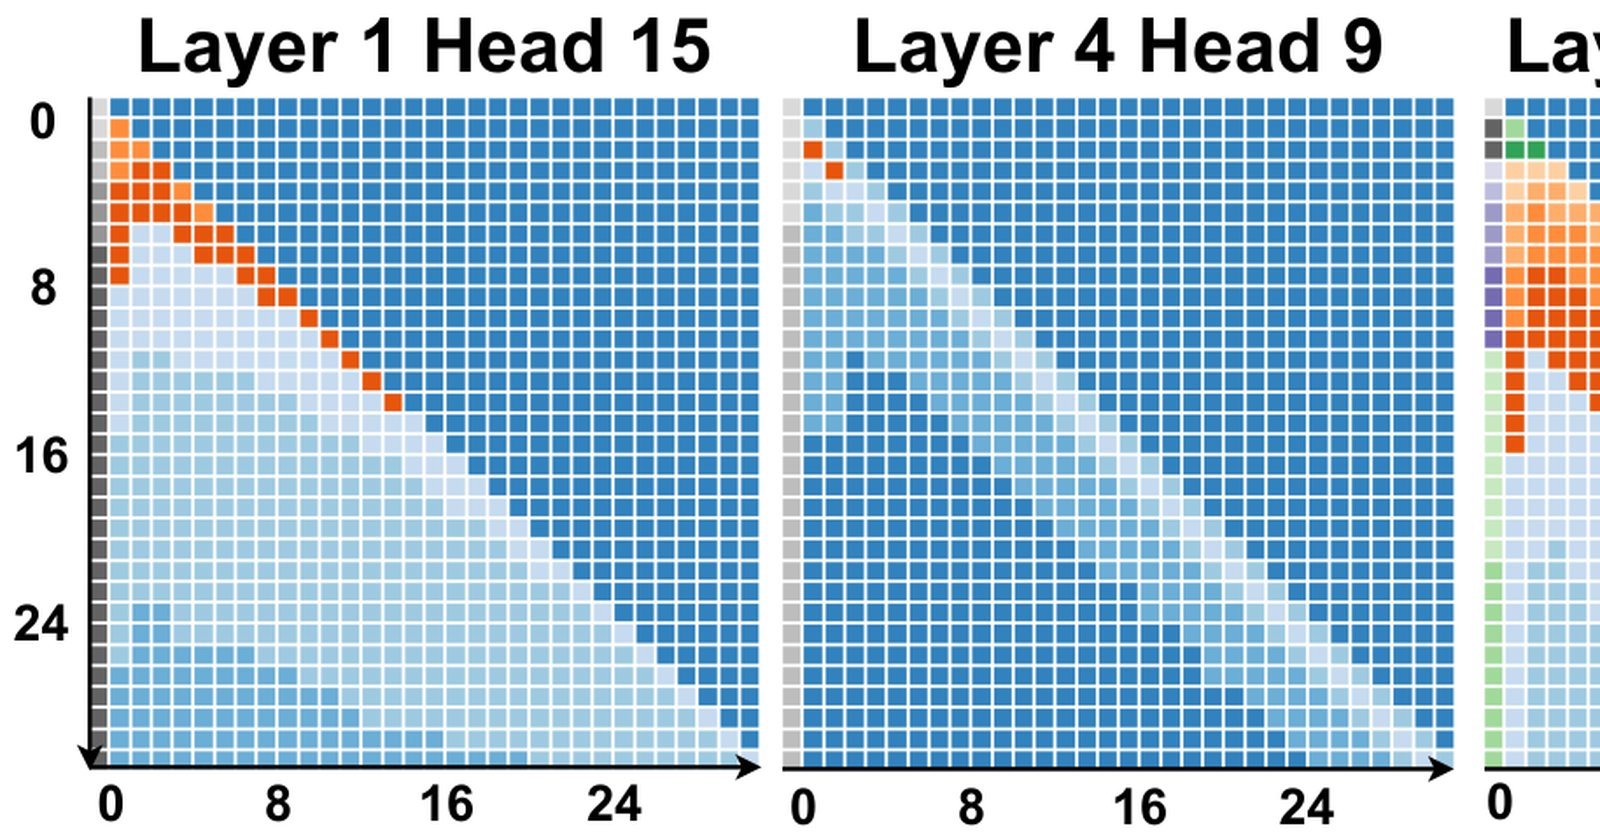
O principal gargalo no processamento de textos longos por LLMs é a camada de autoatenção, que computa o relacionamento entre cada token de consulta (query) e chave (key). Essa computação é quadrática, o que gera alto custo computacional e de memória. Métodos anteriores tentam resolver isso usando um caminho de precisão baixa uniforme (como INT8) ou selecionando quais pares de tokens interagir, o que pode perder informações importantes. O TileMix propõe uma terceira via.
Por que importa
O TileMix resolve um dilema prático para empresas e pesquisadores: como processar contextos longos de forma eficiente sem sacrificar a qualidade. Ao fazer o roteamento de precisão (usando FP16 ou INT8) de maneira inteligente e por "tiles" (blocos) da matriz de atenção, a técnica mantém a conectividade densa entre todos os tokens. Isso é crucial para tarefas que dependem de compreensão profunda do contexto, como análise de documentos longos ou multi-turnos de chat, sem exigir re-treinamento do modelo.
Impacto
A abordagem precisa e seletiva do TileMix pode reduzir o custo computacional de empresas que operam LLMs em produção, especialmente aquelas que lidam com entradas de texto extensas. Ao aumentar o throughput (quantidade de texto processado por segundo) em comparação com a precisão FP16 padrão, a técnica abre espaço para servir mais usuários ou processar prompts mais longos com o mesmo hardware. No cenário brasileiro, onde o custo de infraestrutura em nuvem é um fator relevante, otimizações como essa ganham importância estratégica.
O que muda
O código do TileMix está disponível no GitHub, permitindo que a comunidade teste e adote a técnica. Os resultados mostram que o método estabelece uma "fronteira controlável entre precisão e eficiência". Isso significa que os operadores de modelos podem ajustar dinamicamente a precisão por bloco para equilibrar qualidade e velocidade, em vez de aplicar uma configuração uniforme para todo o texto. A técnica é compatível com otimizações existentes, como agrupamento de consultas (GQA) e caches de chave/valor em INT8.
O que vem agora
A próxima etapa natural é a adoção em frameworks de inferência populares como vLLM ou TensorRT-LLM. A comunidade de código aberto irá validar a eficácia do método em diferentes cenários de produção. Se bem integrado, o TileMix pode se tornar uma peça-chave para tornar o uso de LLMs com janelas de contexto gigantes mais acessível e econômico para desenvolvedores e empresas.