
TimeThink: framework ensina LLMs a raciocinar em séries temporais
Paper no arXiv propõe gerador de dados sintéticos e aprendizado por reforço com recompensas verificáveis para forçar raciocínio explícito
O que aconteceu
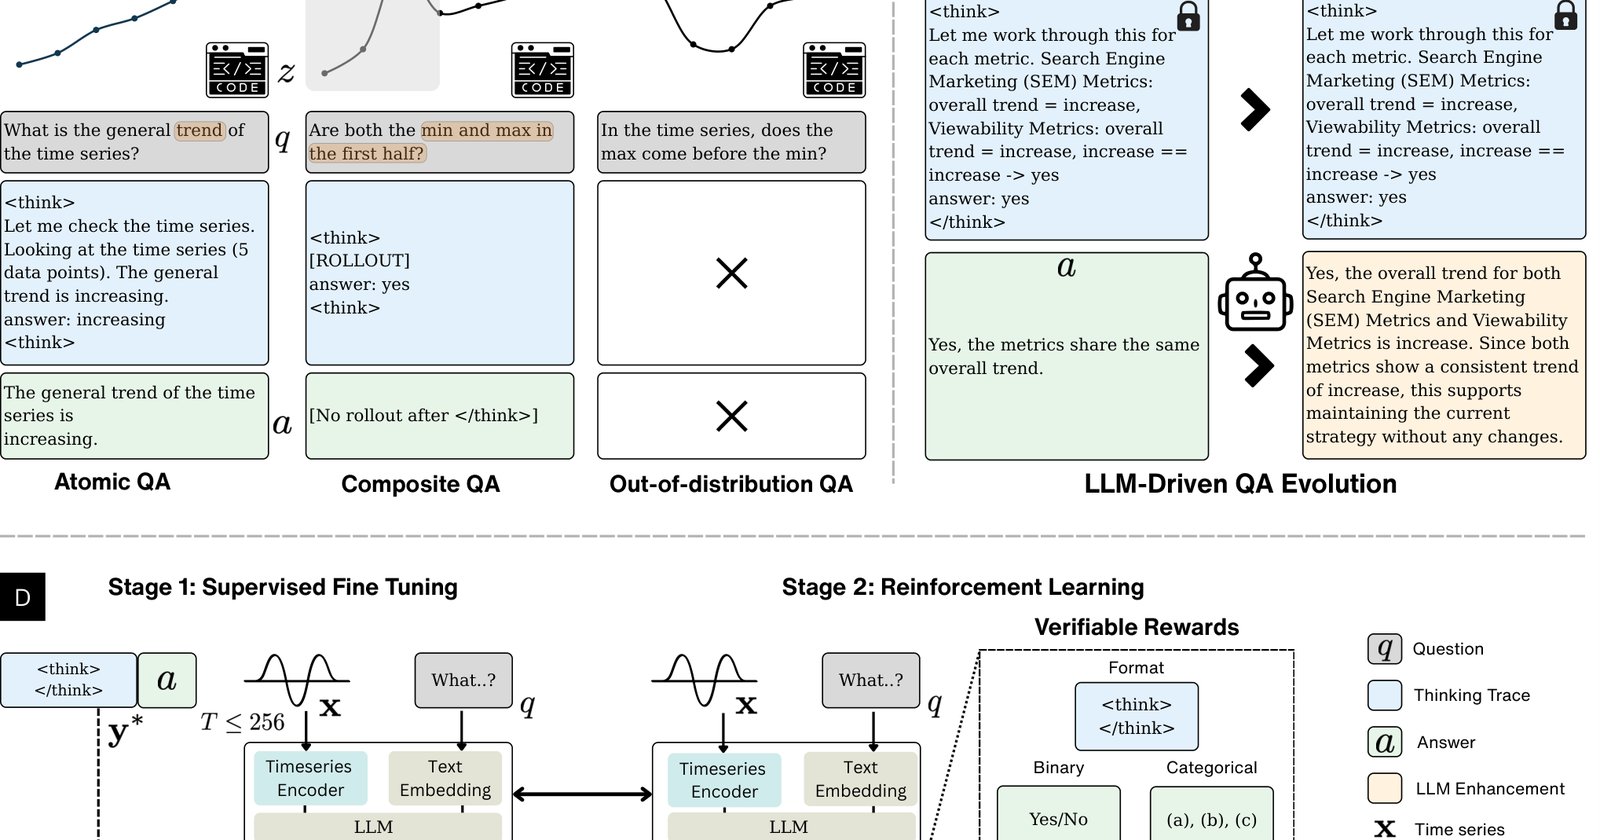
Um novo artigo científico publicado no arXiv descreve o TimeThink, um framework sintético criado para elicitar raciocínio composicional em modelos de linguagem aplicados a séries temporais. O paper "TimeThink: Eliciting Compositional Reasoning in Timeseries Large Language Models" foi submetido em 11 de setembro de 2026 e está catalogado como arXiv:2609.13457v1, na área de Computer Science, subcategoria Artificial Intelligence.
O TimeThink, framework proposto pelos autores do estudo, tem dois componentes centrais. O primeiro é um gerador de dados sintéticos que produz pares de pergunta e resposta, tanto atômicos quanto compostos, com ground truth objetivo e traços de raciocínio anexados a cada exemplo. O segundo é uma estratégia de treinamento por aprendizado por reforço com recompensas verificáveis, o RLVR, sigla de reinforcement learning with verifiable rewards, desenhada para incentivar o modelo a explicitar o raciocínio em vez de apenas devolver uma resposta curta.
Os resultados relatados no resumo do paper apontam que o TimeThink foi treinado apenas com dados sintéticos. Ainda assim, o framework supera baselines considerados fortes tanto em benchmarks sintéticos quanto em benchmarks do mundo real, segundo os próprios autores.
Contexto
Os modelos multimodais de linguagem para séries temporais, chamados TS-MLLMs, começaram recentemente a usar a capacidade de raciocínio dos grandes modelos de linguagem em tarefas de pergunta e resposta. O problema é que esses TS-MLLMs costumam falhar em capturar padrões temporais dinâmicos. A resposta que entregam é implícita e não traz a explicação por trás da conclusão, algo crítico em aplicações de alto risco como saúde.
A tentativa anterior de resolver esse gargalo veio dos modelos de linguagem para séries temporais baseados em aprendizado por reforço. Esses modelos também ficam aquém, segundo o paper, porque são treinados em dados estreitos e dentro da própria distribuição, o que os deixa travados diante de perguntas composicionais fora da distribuição.
A premissa que sustenta o TimeThink é que primitivas centrais de séries temporais, como tendência e sazonalidade, são independentes de domínio e podem ser geradas de forma determinística. É dessa ideia que nasce o gerador de dados sintéticos do TimeThink, descrito pelos autores como a base para produzir perguntas compostas com gabarito verificável.
Por que importa
O ponto sensível aqui é a explicabilidade. Em um hospital, saber que um modelo previu deterioração clínica nas próximas horas vale pouco se ele não mostrar qual padrão temporal sustentou a previsão. O paper cita explicitamente a saúde como exemplo de aplicação de alto risco em que o raciocínio implícito dos TS-MLLMs não basta.
Há também uma questão de generalização. Modelos treinados em dados estreitos e dentro da distribuição tendem a acertar o que já viram e errar combinações novas. Perguntas composicionais, que exigem juntar duas ou mais primitivas temporais, são justamente o teste que expõe essa fragilidade.
O TimeThink ataca os dois pontos ao mesmo tempo. O framework gera os dados que quer cobrar do modelo, com traço de raciocínio e resposta verificável, e depois treina com recompensa verificável para reforçar o comportamento explícito.
Impacto
O detalhe mais relevante do paper é que todo o treinamento aconteceu sobre dados sintéticos. Não houve, segundo o resumo, dependência de grandes volumes de dados anotados do mundo real para chegar ao desempenho relatado nos benchmarks.
Se o resultado se sustentar, ele reduz uma barreira conhecida na área de séries temporais: a dificuldade e o custo de anotar dados reais com explicações confiáveis. O TimeThink, framework dos autores, sugere um caminho em que o gabarito nasce do próprio gerador, de forma determinística, e o modelo aprende a lógica da composição.
Outro alvo declarado é o vício em templates. Métodos que dependem de templates fazem o modelo imitar traços de raciocínio prontos, não aprender a estrutura por trás deles. O uso de RLVR no TimeThink é apresentado como a alternativa para que o modelo internalize a lógica de composição.
O que muda
A mudança prática é o tipo de dado usado no treino. Em vez de partir de séries temporais anotadas por especialistas, o TimeThink parte de primitivas geradas de forma determinística e monta perguntas atômicas e compostas a partir delas.
Isso desloca o esforço: o trabalho vai para o desenho do gerador e para a definição das recompensas verificáveis, não para a rotulagem manual de cada exemplo. O paper não detalha, no resumo, a composição exata do gerador nem os benchmarks específicos usados, o que deixa em aberto a checagem independente dos números.
O que vem agora
O TimeThink chega como preprint e não como produto. O próximo passo natural é a replicação por outros grupos e a comparação com métodos que usam dados reais de domínios como saúde e finanças, exatamente o tipo de cenário citado no paper como motivação.
Também fica pendente entender como o framework se comporta quando as primitivas do mundo real não seguem a geração determinística assumida no treino. O paper afirma que o desempenho se mantém em benchmarks do mundo real, mas a análise detalhada desse ponto depende do texto completo, disponível no arXiv sob o identificador 2609.13457v1.
Fontes
arXiv cs.AI: TimeThink: Eliciting Compositional Reasoning in Timeseries Large Language Models (https://arxiv.org/abs/2609.13457)