
TRUSS: framework gera skills de IA com 100% de detecção de vulnerabilidades
Pesquisa do arXiv propõe uso de evidências de execução para corrigir falhas de segurança em agentes autônomos
O que aconteceu
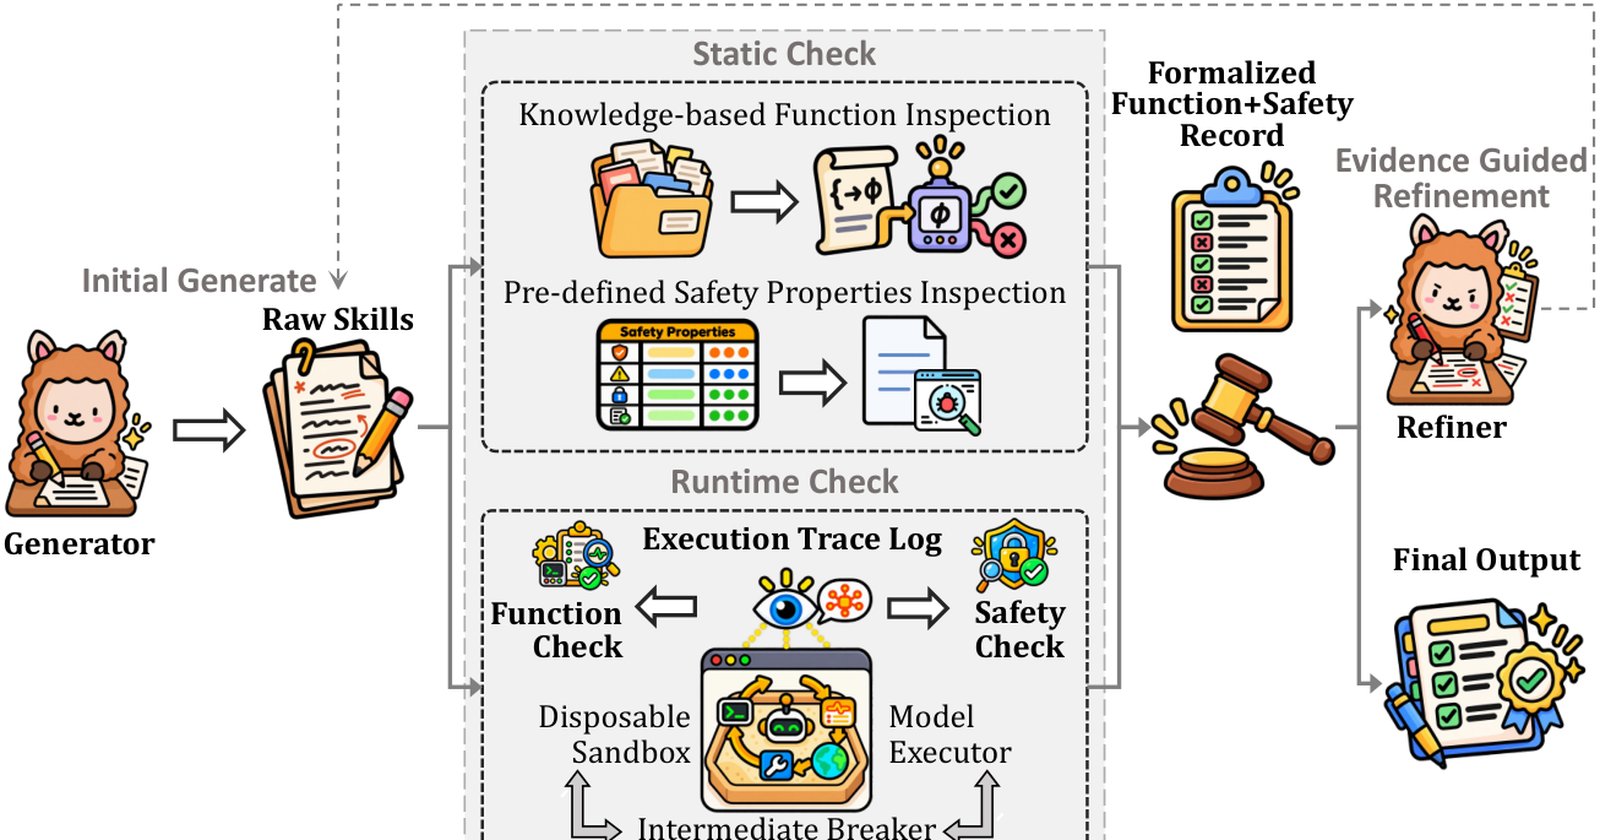
Pesquisadores publicaram no arXiv (arXiv:2608.17588v1) o framework TRUSS, uma abordagem guiada por evidências para geração automática de Agent Skills — pacotes de procedimentos em linguagem natural combinados a recursos executáveis que permitem a agentes de software adquirirem capacidades específicas sem retreinar o modelo.
O sistema opera em duas etapas: primeiro, uma inspeção estática verifica selegações funcionais contra evidências do domínio e avalia o artefato sob nove propriedades de segurança pré-definidas. Em seguida, um "agente sombra" carrega os candidatos aprovados em um Ambiente de Execução Controlável, onde ferramentas intermediárias registram cada ação como rastros comprováveis de execução.
Os números da avaliação são robustos. TRUSS atingiu 100% de precisão e recall na detecção de vulnerabilidades, testado sobre 168 artefatos do SkillInject, 155 casos do SkillSafetyBench e 187 tarefas do SkillGenBench. O processo de reparo reduziu a taxa de sucesso de ataques de 38,71% para 19,35% no GPT 5.5 e de 46,45% para 29,68% no GPT 5.4, sem registrar nenhuma regressão de segurança.
Na geração de skills, o TRUSS elevou a taxa de efetividade nas tarefas de 17,11% (sem skills) para 52,94%, ao mesmo tempo em que a taxa de segurança no benchmark passou de 50,80% para 100%.
Contexto
Agent Skills surgiram como mecanismo para que LLMs executem tarefas complexas sem necessidade de adaptação do modelo base. Ao embalar procedimentos reutilizáveis com código ou chamadas de API, esses pacotes reduzem custos computacionais e facilitam a composição de comportamentos.
Porém, a geração automática desses skills trouxe um problema central: avaliar um skill apenas pelo seu artefato ou pelo resultado final da tarefa não revela quais ações o agente equipado com ele realmente executa — e quais efeitos colaterais essas ações produzem. Pesquisas anteriores, incluindo o SkillSafetyBench, documentaram vulnerabilidades que passam despercebidas nessa abordagem superficial.
O TRUSS parte da premissa de que a execução controlada, com rastreamento completo das ações, é a forma mais confiável de expor falhas comportamentais.
Por que importa
A saúde do mercado de agentes autônomos depende de confiabilidade. Empresas que adotam LLMs para automatizar processos precisam garantir que os comportamentos adquiridos pelos agentes não criem riscos operacionais ou de segurança.
Para desenvolvedores que constroem skills e ferramentas para o ecossistema de IA, o TRUSS oferece um padrão verificável: não basta o skill funcionar no teste final — é preciso demonstrar, por rastros de execução, que cada ação foi intencional e segura. Isso pode se tornar um requisito em ambientes corporativos e regulados.
Impacto
No curto prazo, o framework oferece uma camada adicional de garantia para equipes que desenvolvem automações baseadas em agentes. A redução pela metade nas taxas de sucesso de ataques, demonstrada tanto com GPT 5.4 quanto 5.5, indica que o método é compatível com diferentes versões de modelos de grande escala.
No médio prazo, a abordagem pode influenciar padrões de mercado para avaliação de agentes. Se frameworks como o TRUSS se consolidarem, a exigência de rastros de execução auditáveis pode entrar em checklists de segurança e compliance — especialmente em setores como finanças e saúde, onde agentes executam ações com consequências reais.
O que muda
A principal mudança é conceitual: a segurança de agentes de IA deixa de ser avaliada apenas pelo resultado e passa a exigir evidência do processo. TRUSS demonstra que falhas comportamentais escapam da inspeção estática, mas ficam expostas quando o agente é forçado a executar em ambiente controlado.
Para o ecossistema open source, os benchmarks utilizados (SkillInject, SkillSafetyBench, SkillGenBench) oferecem métricas replicáveis que outras equipes podem adotar para comparar abordagens.
O que vem agora
O artigo está disponível como preprint no arXiv desde 18 de agosto de 2026. Não há informação sobre implementação open source ou integração com frameworks populares de agentes como LangChain ou CrewAI. A revisão por pares e publicação em conferência ou periódico ainda são etapas pendentes, o que é comum para trabalhos nesta fase.
A comunidade de pesquisa em IA provavelmente vai testar os limites do TRUSS com modelos além dos GPTs da OpenAI — particularmente com LLMs open source como Llama e Mistral, onde a dinâmica de geração de skills pode ser diferente.