
UniCAR-RL separa percepção e raciocínio em IA visual
Publicado no arXiv, método dispensa anotação humana e treina três ramos independentes para conter alucinações visuais
O que aconteceu
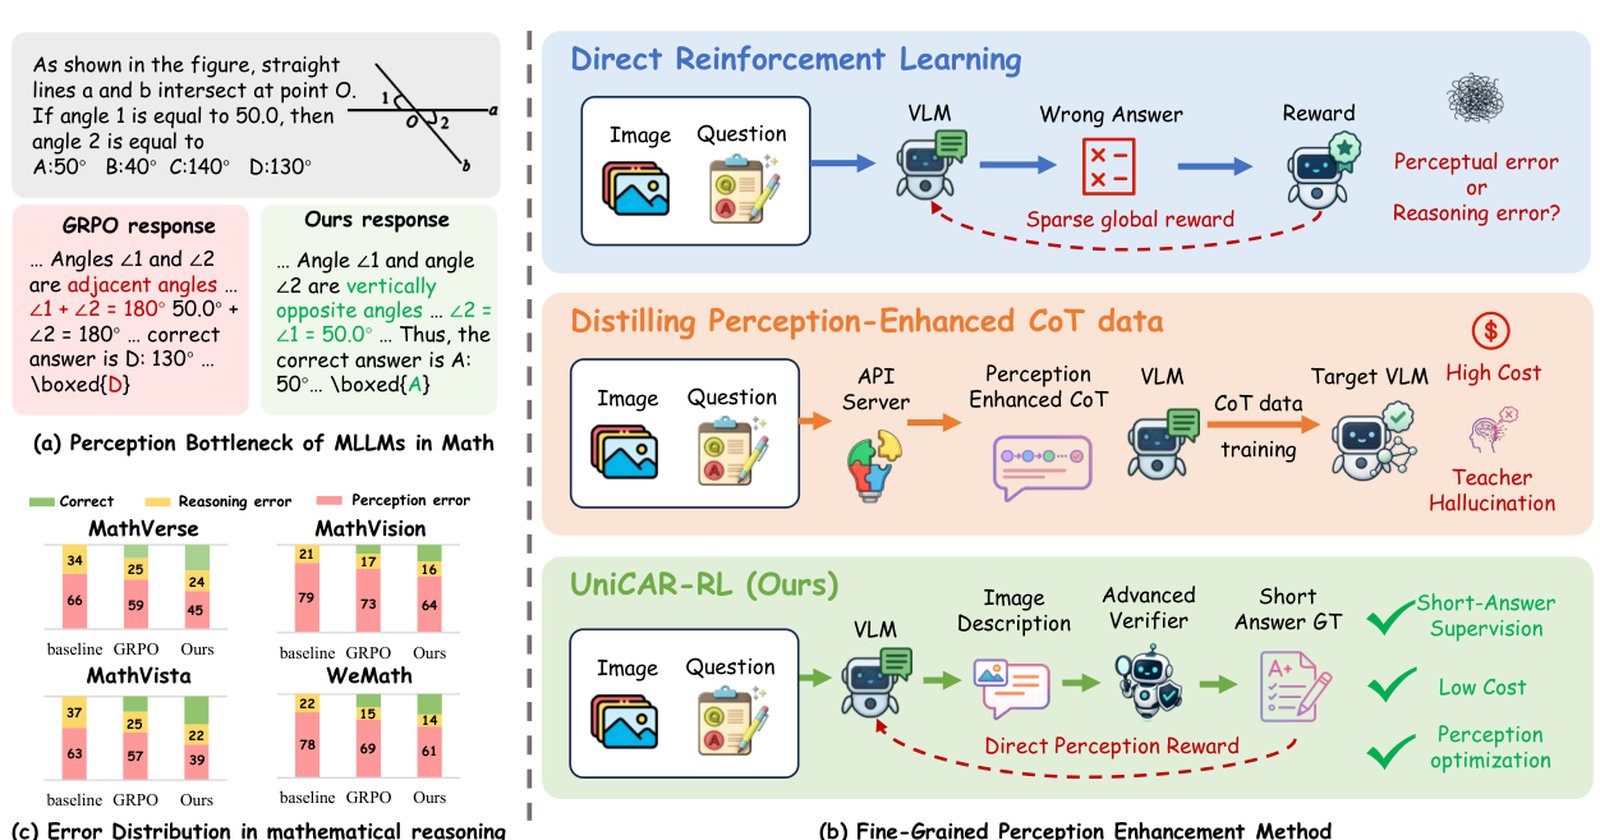
O UniCAR-RL é um framework de aprendizado por reforço, o RL, apresentado no artigo "UniCAR-RL: Seeing Better before Thinking Deeper in Visual Mathematics". O trabalho foi submetido ao arXiv em 12 de setembro de 2026 e está identificado como arXiv:2609.13849v1, na área de Computer Science > Artificial Intelligence. A proposta do UniCAR-RL é explícita: desacoplar, durante o treinamento, a otimização da percepção visual e a otimização do raciocínio lógico.
O framework é descrito como "annotation-free", ou seja, não depende de anotação humana. Ele opera com três ramos sinérgicos. O primeiro, Caption-RL, otimiza a capacidade de percepção por meio de validação de raciocínio guiada por verificador. O segundo, Reasoning-RL, executa o raciocínio lógico a partir de uma descrição de imagem considerada correta, a "gold image description", para interromper erros em cascata. O terceiro, QA-RL, preserva o alinhamento ponta a ponta nativo do modelo para manter o desempenho robusto de perguntas e respostas.
Segundo o artigo, o UniCAR-RL melhora de forma substancial o raciocínio matemático e visual de MLLMs usando apenas dados brutos de resposta curta. O mesmo artigo afirma que o método generaliza bem entre arquiteturas e escalas diferentes.
Contexto
Modelos de linguagem multimodais, os MLLMs, processam texto e imagem ao mesmo tempo. O artigo parte de um diagnóstico específico: esses modelos têm dificuldade com raciocínio matemático visual complexo sobretudo por falta de percepção fina. Uma alucinação visual no início do processo dispara uma cascata de falhas de raciocínio.
O texto descreve dois caminhos já conhecidos e aponta limites em ambos. No aprendizado por reforço ponta a ponta tradicional, as recompensas são esparsas e não conseguem separar alucinação de percepção de erro lógico, o que impede otimizar a percepção de forma direcionada. A alternativa, o ajuste fino com dados de cadeia de pensamento, o CoT, enriquecidos por percepção, tem custo alto e ainda carrega alucinações.
O UniCAR-RL se apresenta como resposta a esse impasse. Em vez de treinar o modelo inteiro com um sinal único de recompensa, o framework isola as duas capacidades. A percepção é treinada no ramo Caption-RL. O raciocínio é treinado no ramo Reasoning-RL, ancorado em uma descrição de imagem correta. E o comportamento final de resposta é preservado no ramo QA-RL.
Por que importa
A separação tem consequência prática direta. Se a falha de percepção é o gatilho da cascata de erros, corrigir a percepção antes de cobrar raciocínio deveria reduzir erros que hoje parecem problemas de lógica, mas começam na leitura da imagem. É essa a tese do título: ver melhor antes de pensar mais fundo.
O ganho declarado é de eficiência de dados. O UniCAR-RL funciona com dados brutos de resposta curta, o tipo de dado mais barato de obter e o mais comum em conjuntos de questões matemáticas. Isso elimina a necessidade de anotações caras de percepção, que eram justamente o custo apontado no ajuste fino com CoT enriquecido.
Para quem desenvolve modelos multimodais, o recado é que o gargalo pode não estar no motor de raciocínio. Pode estar na entrada visual. O UniCAR-RL trata essa entrada como um alvo de otimização próprio, com verificador dedicado, em vez de esperar que o modelo aprenda a ver corretamente como efeito colateral do treino de resposta.
Impacto
O impacto mais concreto está no custo de treinamento. Um framework sem anotação e alimentado por respostas curtas reduz a barreira para times que não têm orçamento para montar bases de dados de percepção anotadas manualmente. O UniCAR-RL, segundo o artigo, atinge esse resultado apenas com dados brutos de resposta curta.
O segundo impacto é a portabilidade. O artigo relata generalização entre arquiteturas e escalas diversas, o que sugere que o método não está preso a um modelo específico. Se a generalização se confirmar em replicações independentes, o UniCAR-RL pode virar uma camada de treino aplicável a diferentes famílias de MLLMs.
O terceiro ponto é o efeito sobre a confiança. Alucinação visual em tarefa matemática é um erro verificável, porque a resposta certa existe e pode ser checada. Reduzir a cascata nesse domínio cria um ambiente controlado para medir avanço real de percepção, diferente de tarefas abertas em que o erro é difícil de isolar.
O que muda
A mudança de método é a substituição de um sinal de recompensa único por três ramos com papéis definidos. O Caption-RL cuida da percepção com validação guiada por verificador. O Reasoning-RL treina lógica sobre uma descrição de imagem correta. O QA-RL mantém o alinhamento ponta a ponta. Nenhum dos três depende de anotação humana.
O UniCAR-RL também desloca a discussão sobre CoT. Em vez de gerar dados de cadeia de pensamento enriquecidos por percepção, com custo alto e risco de alucinação, o framework trata percepção e raciocínio como capacidades otimizadas em separado e depois integradas pelo ramo de perguntas e respostas.
O que vem agora
O artigo afirma generalização entre arquiteturas e escalas, mas o material disponível não detalha os modelos testados, os conjuntos de dados usados nem os números absolutos de ganho. Também não informa liberação de código, cronograma de publicação em conferência ou replicações por outros grupos.
O próximo passo natural é a verificação independente. Como o UniCAR-RL usa apenas dados brutos de resposta curta, o custo de reprodução tende a ser menor do que em métodos que exigem bases anotadas, o que facilita a checagem por terceiros. Até lá, o que existe é a alegação do artigo: um framework de RL sem anotação que melhora raciocínio matemático e visual de MLLMs ao desacoplar percepção e raciocínio no treino.
FONTES
- arXiv cs.AI: UniCAR-RL: Seeing Better before Thinking Deeper in Visual Mathematics (arXiv:2609.13849v1) https://arxiv.org/abs/2609.13849