
A resposta não é o argumento: limite do monitoramento de IA
Estudo do arXiv mostra que dar a resposta correta a monitores melhora a checagem da conclusão, não a verificação dos passos.
O que aconteceu
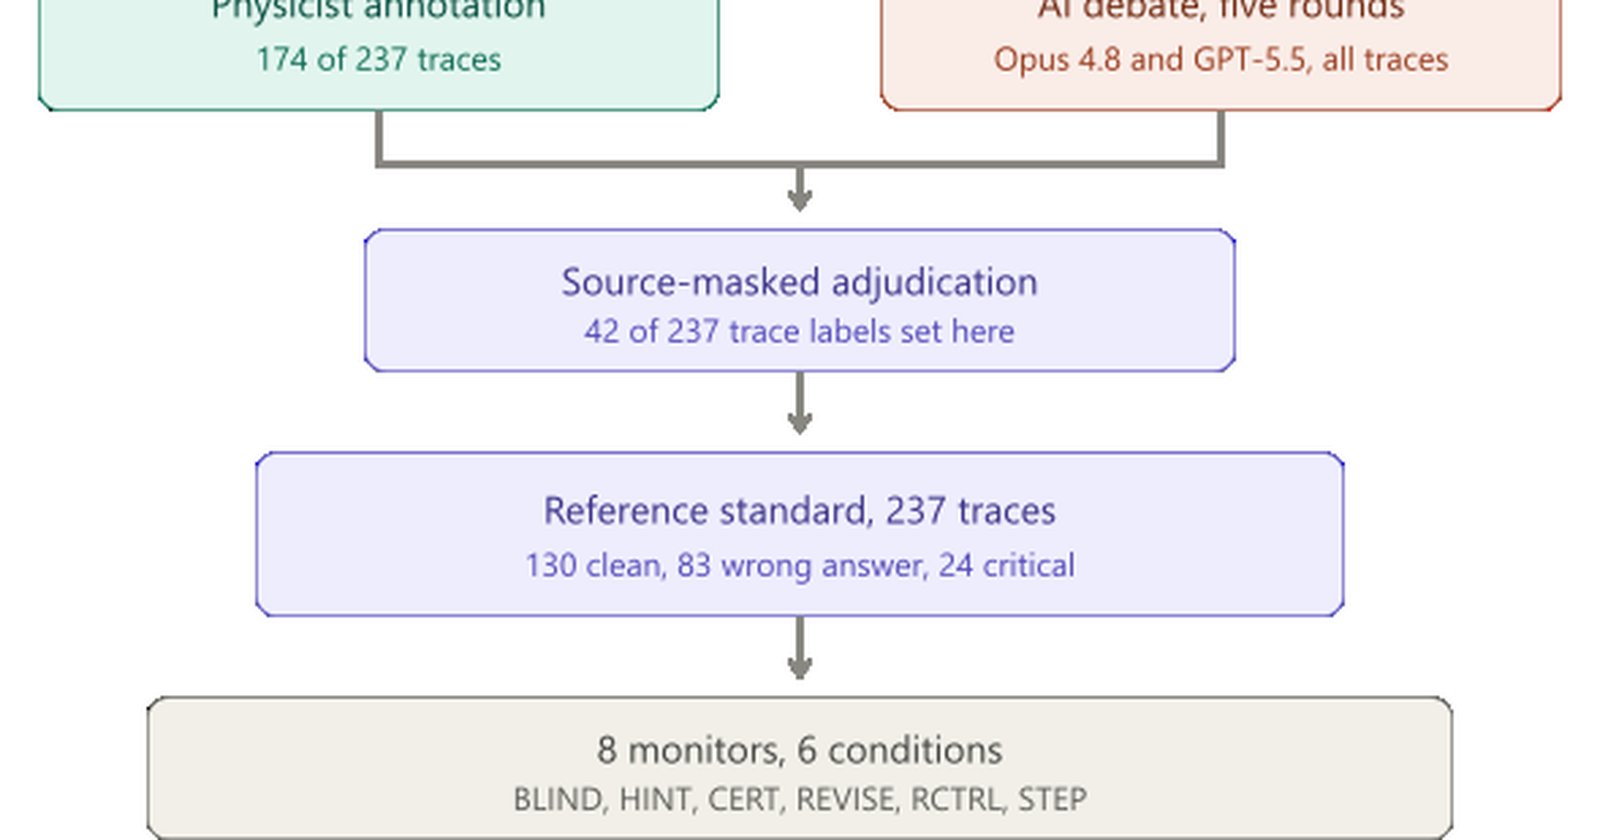
O estudo "The Answer Is Not the Argument", disponível no arXiv sob o identificador 2609.00264, foi submetido em 31 de agosto de 2026. Os pesquisadores coletaram 237 soluções numeradas passo a passo para 79 questões de física do conjunto Humanity's Last Exam, geradas por três modelos de fronteira, sem inserir erros artificialmente. Cada solução foi rotulada independentemente quanto à correção da resposta final e à localização do primeiro passo falso. O padrão de referência combinou anotações de físicos, um debate com um LLM independente e uma adjudicação com fonte mascarada.
Esse processo identificou 24 traces críticos, nos quais a resposta final estava correta, mas a cadeia de raciocínio continha um erro genuíno. Oito monitores LLM avaliaram as traces em três condições: sem resposta, com resposta certificada e após um compromisso cego. A certificação elevou a precisão balanceada média de 0,637 para 0,796, e a localização exata do primeiro erro subiu de 0,261 para 0,379. No entanto, o recall, que mede a fração de traces com erro sinalizadas como erradas, teve comportamentos opostos: subiu de 0,653 para 0,951 nas traces com resposta errada, mas caiu de 0,521 para 0,438 nas traces críticas. A direção do contraste foi a mesma para todos os oito monitores, com intervalo de confiança bootstrap de 95% entre +0,256 e +0,506.
Após o compromisso cego, os monitores que tiveram acesso à resposta sinalizaram como errôneas 93,8% das traces com resposta errada que haviam aprovado anteriormente, mas apenas 18,0% das traces críticas.
Contexto
O monitoramento de cadeia de raciocínio (chain-of-thought monitoring) é proposto como uma técnica de supervisão de IA, na qual um modelo avalia os passos intermediários de outro. Avaliações desse tipo costumam fornecer ao monitor uma resposta de referência confiável. A questão central do estudo é se esse acesso à resposta melhora a verificação do raciocínio ou apenas expõe conclusões incorretas. A resposta, segundo os autores, é a segunda opção. O acesso à resposta melhora a checagem de consistência com a conclusão, mas não a verificação independente dos argumentos.
Por que importa
Para a segurança de IA, o resultado é um análogo benigno do que se chama reward hacking: uma saída aceitável não estabelece que o processo que a produziu era sólido. Em avaliações que usam uma resposta confiável, a capacidade de monitoramento pode ser superestimada quando saídas aceitáveis escondem raciocínios insound. Os erros estudados são comuns e majoritariamente não essenciais, não adversariais, o que torna o problema ainda mais relevante para cenários reais.
Impacto
No curto prazo, o estudo sugere que métricas de precisão baseadas em resposta podem inflar o desempenho percebido dos monitores. Sistemas de supervisão que dependem apenas da comparação com a resposta correta podem falhar justamente nos casos mais perigosos: quando o modelo acerta a resposta por sorte ou por um caminho errado. Para empresas que usam monitoramento de cadeia de raciocínio em produção, a lição é que é preciso verificar os passos intermediários de forma independente, e não apenas a conclusão final.
O que muda
A principal mudança é metodológica. Avaliações de monitores devem separar a verificação da conclusão da verificação do argumento. O estudo propõe que a localização do primeiro erro, e não apenas a correção da resposta, seja o alvo das métricas. Além disso, o contraste entre o recall em traces erradas e críticas indica que a certificação pode mascarar a verdadeira capacidade de detectar raciocínios falhos.
O que vem agora
Os pesquisadores não anunciaram próximos passos no resumo. Mas o resultado abre caminho para o desenvolvimento de monitores que não dependam de uma resposta certificada, ou que usem o compromisso cego para forçar uma decisão antes de ver a resposta. O conjunto de 237 traces, incluindo os 24 críticos, pode servir como benchmark público para testar novos métodos de verificação de raciocínio.