
AffectOmni: raciocínio afetivo verificável com aprendizado por reforço
Framework usa recompensas focadas em pessoas e evidências de pixel para verificar raciocínio afetivo
O que aconteceu
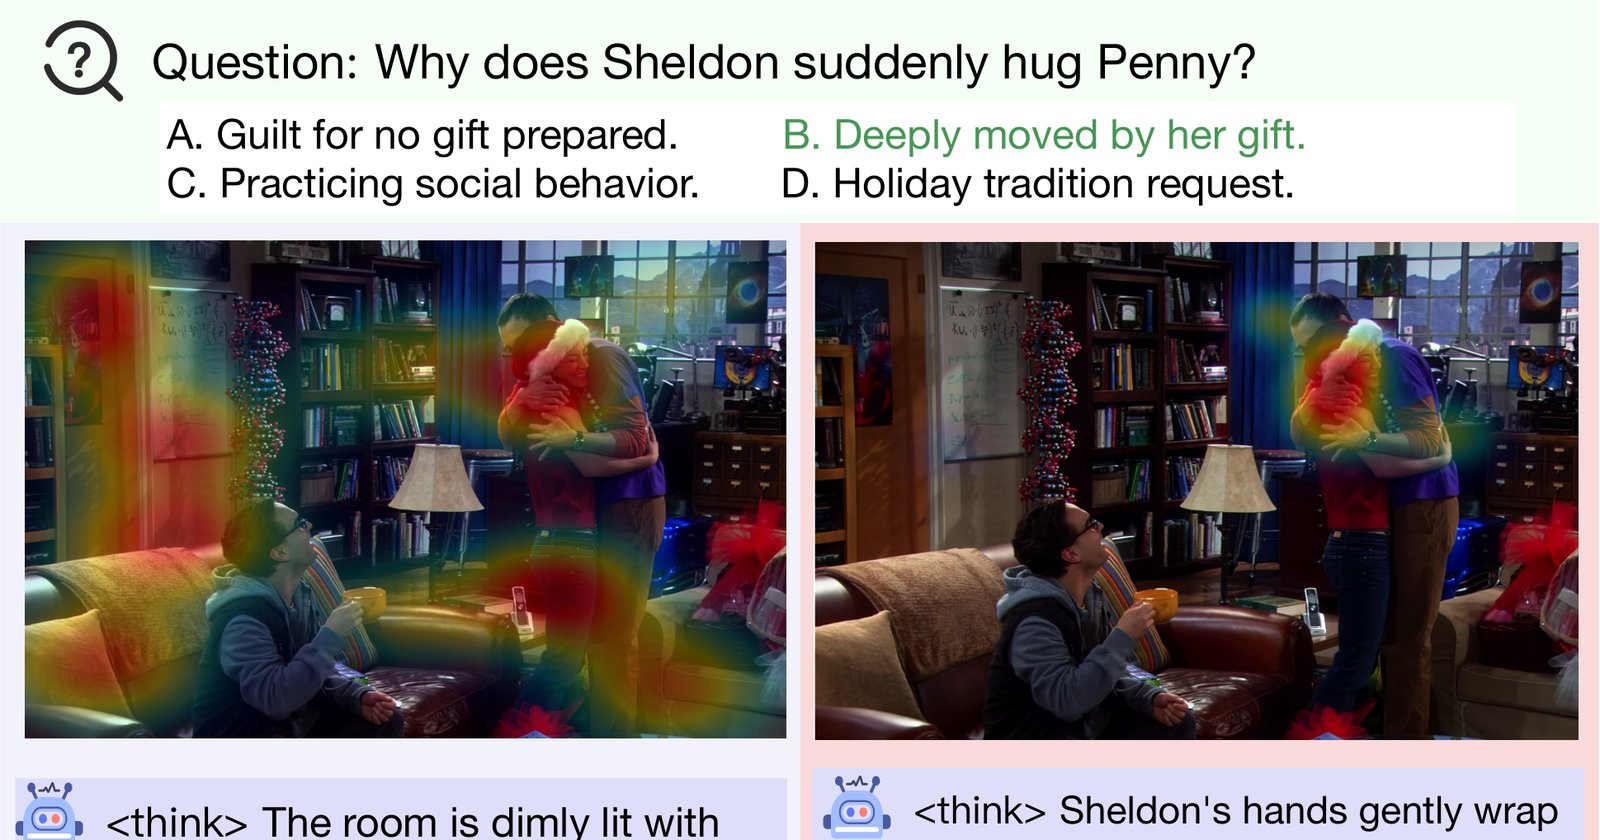
Em 24 de agosto de 2026, pesquisadores submeteram ao arXiv (identificador 2608.26193v1) o artigo que descreve o AffectOmni, um framework de raciocínio afetivo treinado com o algoritmo GRPO (Group Relative Policy Optimization). O AffectOmni foi projetado para resolver um problema específico: modelos multimodais de linguagem (MLLMs) acertam respostas sobre emoções sem prestar atenção nas pistas humanas, como microexpressões e linguagem corporal.
Nos testes em três benchmarks públicos, IntentBench, Daily Omni e WorldSense, o AffectOmni superou baselines open source de escala 7B. O ganho no reconhecimento de emoções foi de 4,66%, e em tarefas temporalmente sensíveis o aumento chegou a 14,29%.
O ganho de 14,29% em tarefas temporalmente sensíveis foi registrado pelo AffectOmni em comparação às linhas de base open source. O framework também adota uma técnica chamada within-group comparative scoring, que compara respostas dentro de grupos pequenos para gerar sinais de recompensa mais estáveis.
O código está disponível em um repositório público no GitHub, no endereço github.com/eliot127825-rgb/AffectOmni_nobody.
Contexto
O problema de atalhos (shortcut behavior) é conhecido na visão computacional. Um modelo pode responder corretamente a uma pergunta sobre emoção ao identificar padrões de cena, como ambiente ou objetos, sem detectar o que a pessoa está expressando. Isso enfraquece a rastreabilidade e dificulta a verificação externa.
Abordagens anteriores de aprendizado por reforço nesse domínio recompensavam principalmente a coerência do contexto ou da lógica, sem obrigar o modelo a se apoiar em evidências humanas. Além disso, o uso de um LLM como juiz (LLM as a Judge) sofre com agrupamento de notas, chamado de score clustering. Quando todos os candidatos recebem notas próximas, a recompensa perde poder de discriminação, e o treinamento fica menos eficaz.
O AffectOmni ataca esses dois pontos. A recompensa People Focus força o modelo a selecionar evidências centradas nas pessoas. A recompensa Temporal Order exige raciocínio estruturado no tempo, útil para entender sequências de ações e reações.
Por que importa
O raciocínio afetivo verificável tem aplicações práticas. Assistentes de IA que lidam com atendimento ao cliente precisam detectar frustração. Ferramentas de moderação de conteúdo em redes sociais precisam distinguir humor de ameaça. Sistemas de análise de obras de arte e vídeos precisam explicar por que classificaram uma cena como triste ou hostil.
Sem verificação, um modelo pode dar a resposta certa pelo motivo errado. O Thinking Summarizer, componente do AffectOmni, converte o raciocínio livre do modelo em instruções executáveis de evidência. Essas instruções são ancoradas em regiões de pixel por meio do SAM3, o segmentador da geração mais recente. Com isso, o sistema oferece uma interface auditável fora do loop de treinamento. O usuário pode ver quais pixels sustentaram a decisão.
Impacto
Os números dos experimentos mostram onde o framework é mais forte. Nas tarefas sensíveis ao tempo, o ganho de 14,29% indica que a recompensa Temporal Order ajudou o modelo a acompanhar mudanças de expressão e postura ao longo de uma sequência. No reconhecimento de emoções isoladas, o avanço de 4,66% é menor, porém consistente nos três conjuntos de dados.
A adoção de comparative scoring dentro de grupos é uma resposta prática ao problema de clustering. Em vez de depender de notas absolutas do LLM juiz, o método compara respostas de um mesmo grupo, gerando ranking relativo. Isso reduz a sensibilidade a viés de escala e melhora a estabilidade do treinamento.
O que muda
Para equipes que desenvolvem MLLMs, o AffectOmni oferece um caminho para alinhar recompensas a evidências humanas. A combinação de duas recompensas explícitas, People Focus e Temporal Order, muda o incentivo do modelo. Ele não é mais premiado apenas por respostas corretas, mas por raciocínios que citam pistas das pessoas e respeitam a ordem temporal dos eventos.
A auditoria externa via SAM3 também muda a forma de depurar modelos. Em vez de inspecionar apenas o texto de saída, o desenvolvedor pode inspecionar a região da imagem que fundamentou a resposta. Isso facilita encontrar casos em que o modelo usa atalhos de cena.
O que vem agora
O código aberto no GitHub permite que outros grupos reproduzam os experimentos e adaptem as recompensas a novos domínios. Ainda não há informações sobre versões maiores do que 7B ou sobre aplicação comercial. Os próximos passos prováveis incluem testar o framework em cenas sociais mais complexas e em conjuntos de dados de arte, que é o foco declarado do artigo.
Os autores também devem explorar o comportamento do within-group comparative scoring em cenários com mais variação de qualidade, além de medir o custo computacional do Thinking Summarizer em grande escala.
Fonte
- arXiv: AffectOmni: RL-Verifiable People-Centric Grounded Affective Reasoning for Social and Art-Related Scenes (arXiv:2608.26193v1). https://arxiv.org/abs/2608.26193