
ARAC-Bench: novo benchmark avalia qualidade da pesquisa autônoma de IA
Framework mede alinhamento do processo de pesquisa com o comportamento humano e revela lacuna significativa
O que aconteceu
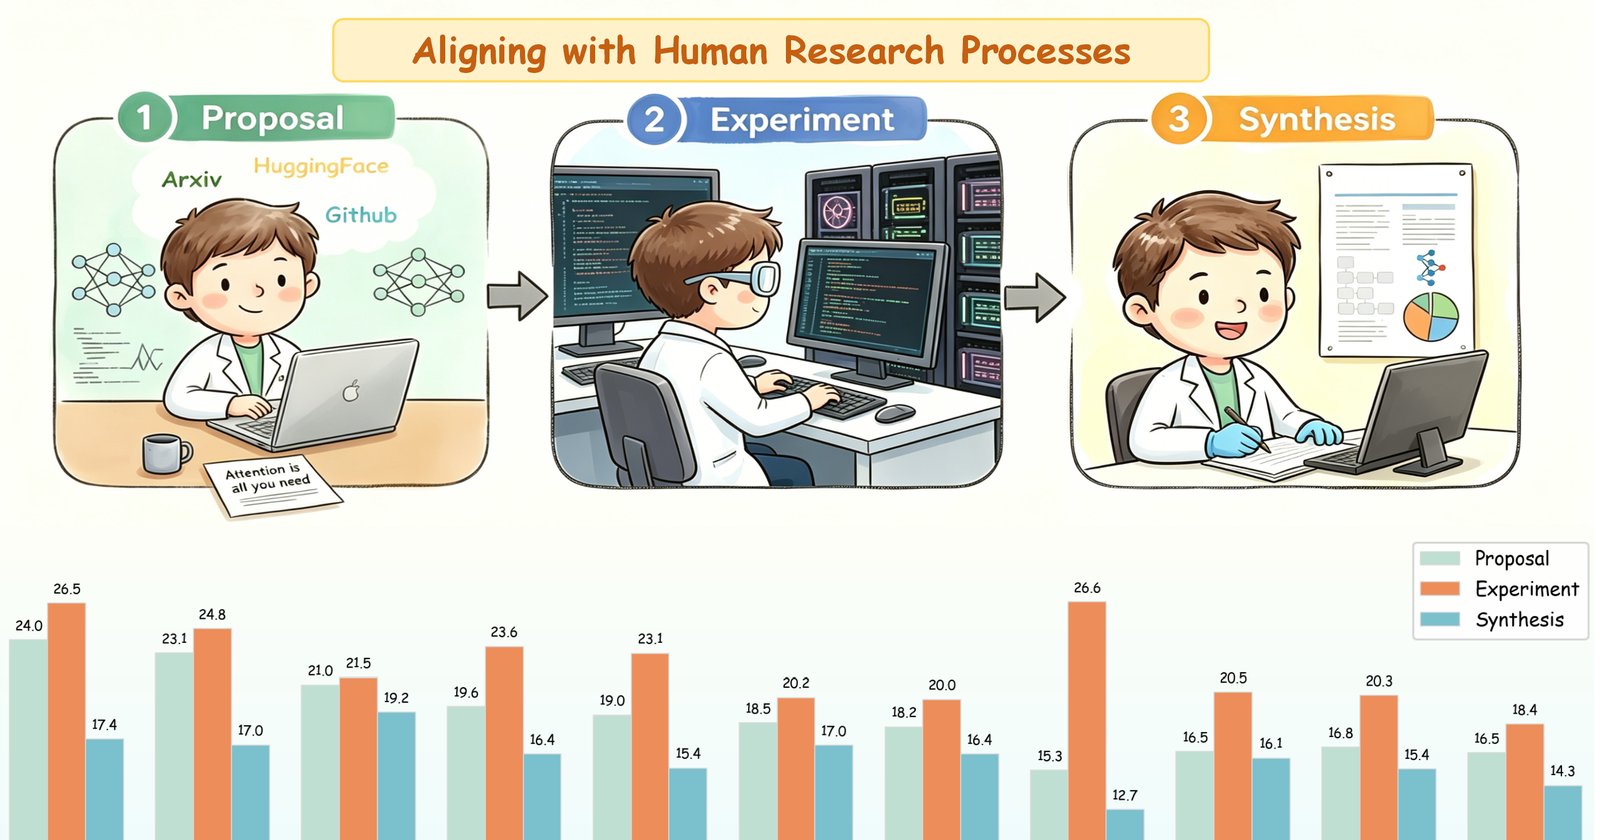
Um grupo de pesquisadores publicou no arXiv (arXiv:2608.12788) o ARAC-Bench (Auto-Research's Alignment and Completeness), um framework de avaliação que muda o foco da comparação de respostas finais para a reprodução de processos de pesquisa humanos de alta qualidade. O sistema é composto por dois componentes: o Academic Cognition Skills, que transforma a expertise implícita de revisores em rubricas quantificáveis e calibradas por etapa, e um protocolo de diagnóstico de três estágios que decompõe o processo de pesquisa em dimensões independentes: Proposta, Experimento e Síntese.
A avaliação sistemática de 11 frameworks state-of-the-art (SOTA) resultou em uma pontuação máxima de alinhamento de apenas 67,9 de 100. A validação contra rankings de candidatos a PhD mostrou uma correlação forte de 0,8141, confirmando que o ARAC-Bench reflete de forma confiável as dimensões que pesquisadores realmente valorizam.
Contexto
O avanço rápido da área de Auto-Research — sistemas que conduzem pesquisas científicas de forma autônoma — trouxe um desafio fundamental de avaliação. Métricas tradicionais focam apenas no resultado final, ignorando a qualidade do processo. O ARAC-Bench surge como uma alternativa que prioriza o processo, inspirada no comportamento de pesquisadores humanos.
A proposta foi submetida em 13 de agosto de 2026 e está disponível na categoria Computer Science > Artificial Intelligence do arXiv.
Por que importa
Para empresas e instituições que desenvolvem ou utilizam sistemas de pesquisa autônoma, ter uma métrica confiável de avaliação de processo é essencial. A pontuação máxima de 67,9 indica que nenhum sistema atual consegue simular adequadamente a metodologia humana, o que limita a confiança em resultados gerados por IA em contextos científicos.
A correlação de 0,8141 com rankings de candidatos a PhD sugere que o benchmark captura dimensões que especialistas consideram relevantes, tornando-o uma ferramenta útil para diagnóstico fino e para treinamento de novos modelos.
Impacto
No curto prazo, o ARAC-Bench oferece uma ferramenta de diagnóstico granular para identificar pontos fracos em sistemas de Auto-Research. No médio prazo, pode servir como sinal de recompensa escalável para treinar a próxima geração de sistemas autônomos, incentivando a melhoria do processo como um todo.
A lacuna de 32,1 pontos entre o melhor sistema e a pontuação máxima sugere que há espaço considerável para avanços, especialmente na simulação de rigor metodológico humano.
O que muda
A principal mudança é a forma de avaliar IA em pesquisa: em vez de comparar apenas respostas finais, o ARAC-Bench introduz uma métrica de processo. Isso pode influenciar o desenvolvimento de novos benchmarks e a adoção de padrões de avaliação mais alinhados com a prática científica.
O que vem agora
Os pesquisadores devem disponibilizar o código e os dados do benchmark para a comunidade, permitindo que outros grupos validem e utilizem o framework. Espera-se que o ARAC-Bench seja adotado como referência em futuras pesquisas sobre Auto-Research, tanto para avaliação quanto para treinamento de sistemas mais robustos.