
Auditoria de peso-delta questiona como medir especialização de LLMs médicos
Estudo do arXiv propõe analisar a diferença de pesos entre modelo generalista e especialista, não apenas os resultados finais.
O que aconteceu
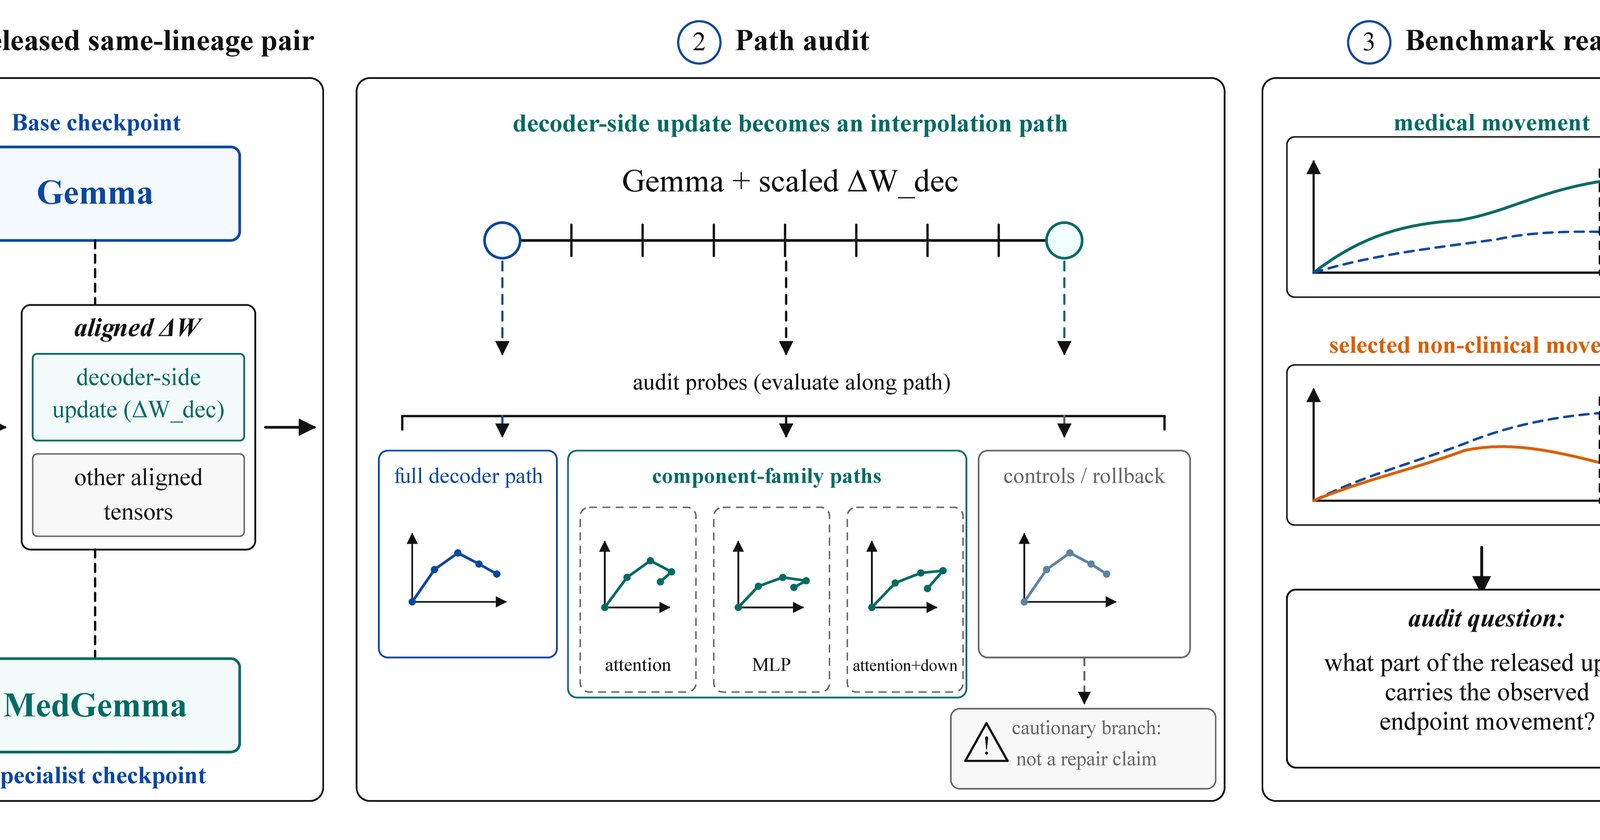
O preprint Beyond Endpoint Gains: A Weight-Delta Audit of Medical Specialization, disponível no arXiv sob o identificador 2608.20768, foi submetido em 21 de agosto de 2026 e anunciado no serviço em 24 de agosto. O trabalho audita dois pares públicos de checkpoints alinhados, cada um formado por um modelo generalista e sua versão especializada em medicina: de Gemma-3-4B-IT para MedGemma-4B-IT e de Qwen2.5-7B-Instruct para HuatuoGPT-o1-7B.
A metodologia central é a chamada paired weight-delta path audit. Em vez de examinar apenas o desempenho final de cada modelo (o endpoint), os autores analisam a atualização de pesos liberada, ou seja, a diferença entre os parâmetros do especialista e os do generalista. Os números indicam que essa diferença, aplicada ao lado decoder do modelo, reconstruiu com força o movimento medido nos benchmarks médicos. A retenção normalizada por endpoint ficou em 0,974 para o par Gemma-MedGemma e 1,183 para o par Qwen-HuatuoGPT. Isso torna cada delta de decoder um substrato apropriado para a auditoria, segundo o resumo.
Contexto
Modelos especialistas em medicina, como MedGemma e HuatuoGPT-o1, costumam ser avaliados pelo ganho de endpoint: o generalista pontua menos, o especialista pontua mais, e essa diferença é tratada como evidência de especialização. O problema, apontam os autores, é que essa visão deixa a atualização em si, o conjunto de pesos que foi alterado, praticamente sem exame. O novo estudo propõe inverter a pergunta: não apenas quanto o modelo melhorou, mas o que mudou internamente para produzir essa melhora.
O trabalho aplica a auditoria aos dois pares citados, que são públicos e já alinhados. A escolha de dois pares diferentes, um baseado em Gemma da Google e outro em Qwen da Alibaba, tem o objetivo de testar se o padrão encontrado se repete entre arquiteturas e famílias distintas.
Por que importa
A descoberta central é que a melhora em benchmarks médicos não está limpa e localizada em um único tipo de componente do modelo. Nas palavras do resumo, o MLP (multilayer perceptron) aparece como a família de componentes mais forte em ambos os pares, mas movimentos fora do domínio, controles pareados com 10 seeds e rollbacks ancorados no endpoint impedem uma explicação única de família grosseira. Em outras palavras, o delta de pesos reconstroi o resultado, mas não conta uma história simples sobre onde a especialização acontece.
Para empresas e pesquisadores que desenvolvem modelos médicos, isso tem uma consequência prática: ajustar um componente isolado, como apenas as camadas MLP, pode não bastar para transferir a especialização de um modelo para outro. O estudo separa explicitamente a reconstrução no nível da atualização, que funciona, da explicação no nível do componente, que não é única.
Impacto
Os autores são cuidadosos ao delimitar o alcance do estudo. As afirmações concernem apenas o movimento de benchmarks de múltipla escolha baseados em texto. Não há validação clínica, reparo de modelo ou mecanismo em nível de circuito. Isso impede que o trabalho seja lido como uma receita para melhorar modelos médicos no mundo real, mas oferece uma ferramenta de diagnóstico.
O impacto imediato está no campo da interpretabilidade. A auditoria de peso-delta pode ser usada por outros grupos para comparar pares de modelos especialistas, não apenas em medicina, mas em qualquer domínio com checkpoints públicos alinhados. A técnica fornece uma métrica objetiva para responder se uma atualização de pesos é um bom substrato de análise, antes de tentar extrair explicações causais.
O que muda
A principal mudança de abordagem é metodológica. A avaliação de modelos especialistas deixa de ser apenas uma comparação de escores e passa a incluir uma inspeção da atualização regida pelo delta de pesos. No caso concreto dos dois pares analisados, o decoder delta se mostrou um bom substrato, com retenção de 0,974 e 1,183. Mas a ausência de uma localização limpa indica que interpretações baseadas apenas em famílias amplas de componentes, como dizer que a especialização está nas camadas MLP, precisam ser vistas com ceticismo.
O que vem agora
O preprint está em fase de revisão pela comunidade, como indica o status de novo anúncio no arXiv em 24 de agosto de 2026. Os próximos passos naturais, apesar de não explicitados no resumo, incluem a aplicação da auditoria a outros pares de modelos médicos, a verificação dos resultados com conjuntos de dados clínicos e a investigação de quebra do delta em subcomponentes mais finos que MLP ou atenção. O estudo deixa claro que a separação entre reconstrução da atualização e explicação do componente é o ponto de partida, não a conclusão, desse tipo de análise.
A pesquisa também chama atenção para a necessidade de os desenvolvedores de modelos médicos publicarem não apenas os pesos finais, mas também registros das atualizações intermediárias, para que auditorias como essa possam ser reproduzidas.