
Auditoria XAI revela explicações enganosas mesmo em modelos com AUC acima de 0,99
Estudo publicado no arXiv propõe framework para auditar robustez e fidelidade de explicadores como SHAP e LIME, testado em dados de segurança alimentar em Madagascar.
O que aconteceu
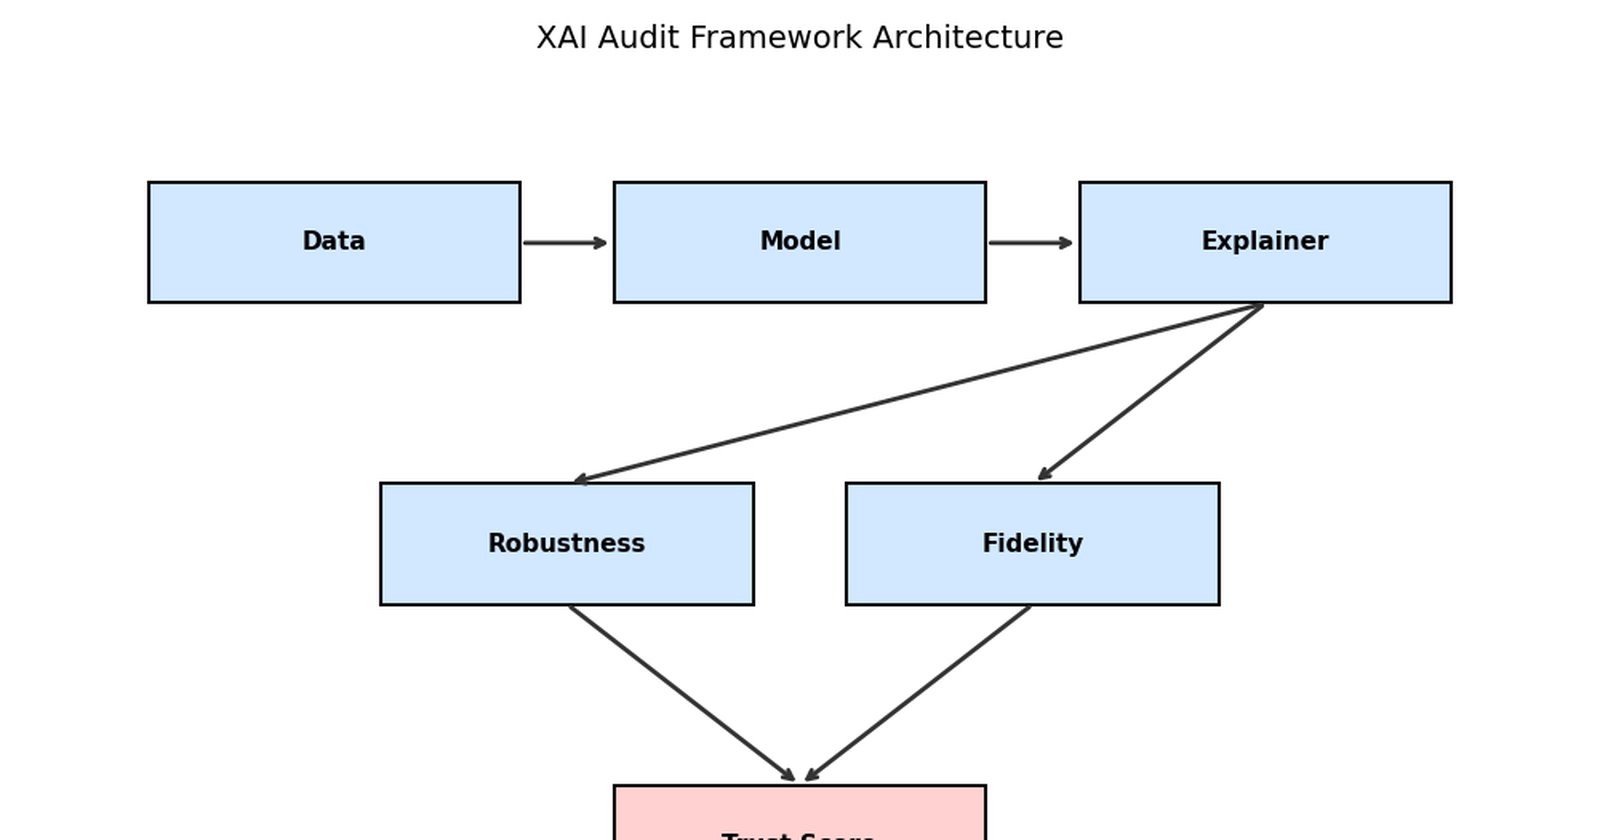
O artigo "A Formal Methodological Framework for Auditing Robustness and Fidelity in Explainable AI: From Application to Trust Certification" foi submetido ao arXiv em 24 de agosto de 2026 e anunciado oficialmente em 26 de agosto de 2026. A autora é Rosa Elysabeth Ralinirina, que desenvolveu o trabalho com base em observações da vida real em segurança alimentar em Madagascar. O estudo propõe um protocolo de auditoria que mede duas propriedades de qualquer explicador pós-hoc: robustez (estabilidade da explicação sob perturbação de entrada) e fidelidade (se as features consideradas importantes realmente impulsionam a previsão do modelo). Ambas as métricas são combinadas em um único Trust Score. O protocolo foi testado em um conjunto de dados multi-setorial de Madagascar com 83 features, 253 registros e 4 classes de desnutrição, utilizando três classificadores e dois explicadores, além de suas versões regularizadas.
Contexto
SHAP e LIME são amplamente utilizados para interpretar previsões de modelos black-box, mas sua saída pode variar significativamente quando a entrada é perturbada por pequenas quantidades de ruído. Esse problema foi observado diretamente pelos autores em seu trabalho anterior sobre segurança alimentar em Madagascar (Ralinirina et al., 2025). A variabilidade levanta a questão de se essas explicações podem ser confiáveis. O trabalho de Ralinirina introduz um framework formal para auditar XAI, combinando robustez e fidelidade em um Trust Score. A autora Rosa Elysabeth Ralinirina submeteu o artigo ao arXiv em 24 de agosto de 2026.
Por que importa
O estudo mostra que modelos com AUC acima de 0,99 podem produzir explicações numericamente degeneradas ou completamente desinformadas. Além disante, as pontuações de fidelidade perdem seu poder discriminativo quando o modelo está sobreajustado. Esses achados indicam que auditar saídas de XAI não é opcional, mas necessário, especialmente quando elas informam decisões em domínios sensíveis como segurança alimentar e saúde pública.
Impacto
Os resultados têm implicações diretas para aplicações de IA em domínios críticos. Em Madagascar, onde o estudo foi aplicado, decisões baseadas em modelos de desnutrição podem ser afetadas se as explicações forem enganosas. O Trust Score proposto oferece uma métrica quantitativa para validar explicadores antes de seu uso em decisões reais. A autora Rosa Elysabeth Ralinirina demonstra que a fidelidade perde poder discriminativo em modelos sobreajustados.
O que muda
O framework introduzido por Ralinirina estabeleele um padrão formal para auditoria de XAI. A combinação de robustez e fidelidade em um Trust Score oferece uma abordagem quantitativa para validar explicadores. Isso pode influenciar futuras pesquisas e aplicações práticas de IA explicável.
O que vem agora
O autor Rosa Elysabeth Ralinirina submeteu o artigo ao arXiv em 24 de agosto de 2026, com anúncio oficial em 26 de agosto de 2026. Próximos passos provavelmente incluem ampliação do estudo para outros domínios e integração do Trust Score em pipelines de validação de XAI. A autora Ralinirina planeja aplicar o framework em novos conjuntos de dados e cenários reais.