
AutoData: agente busca dados de pré-treinamento sozinho
Paper no arXiv descreve agente que busca algoritmos de seleção de dados e transfere o resultado para escalas maiores
O que aconteceu
O AutoData é um agente que opera sobre algoritmos executáveis de seleção de dados, e não sobre pesos de mistura. A distinção é o coração do paper. Métodos anteriores de data mixture otimizam pesos sobre um conjunto fixo de domínios. O AutoData, agente descrito no arXiv em 17 de setembro de 2026 (arXiv:2609.19754), amplia esse espaço e busca em um programa mais rico, composto por regras de scoring, estratificação e seleção estocástica.
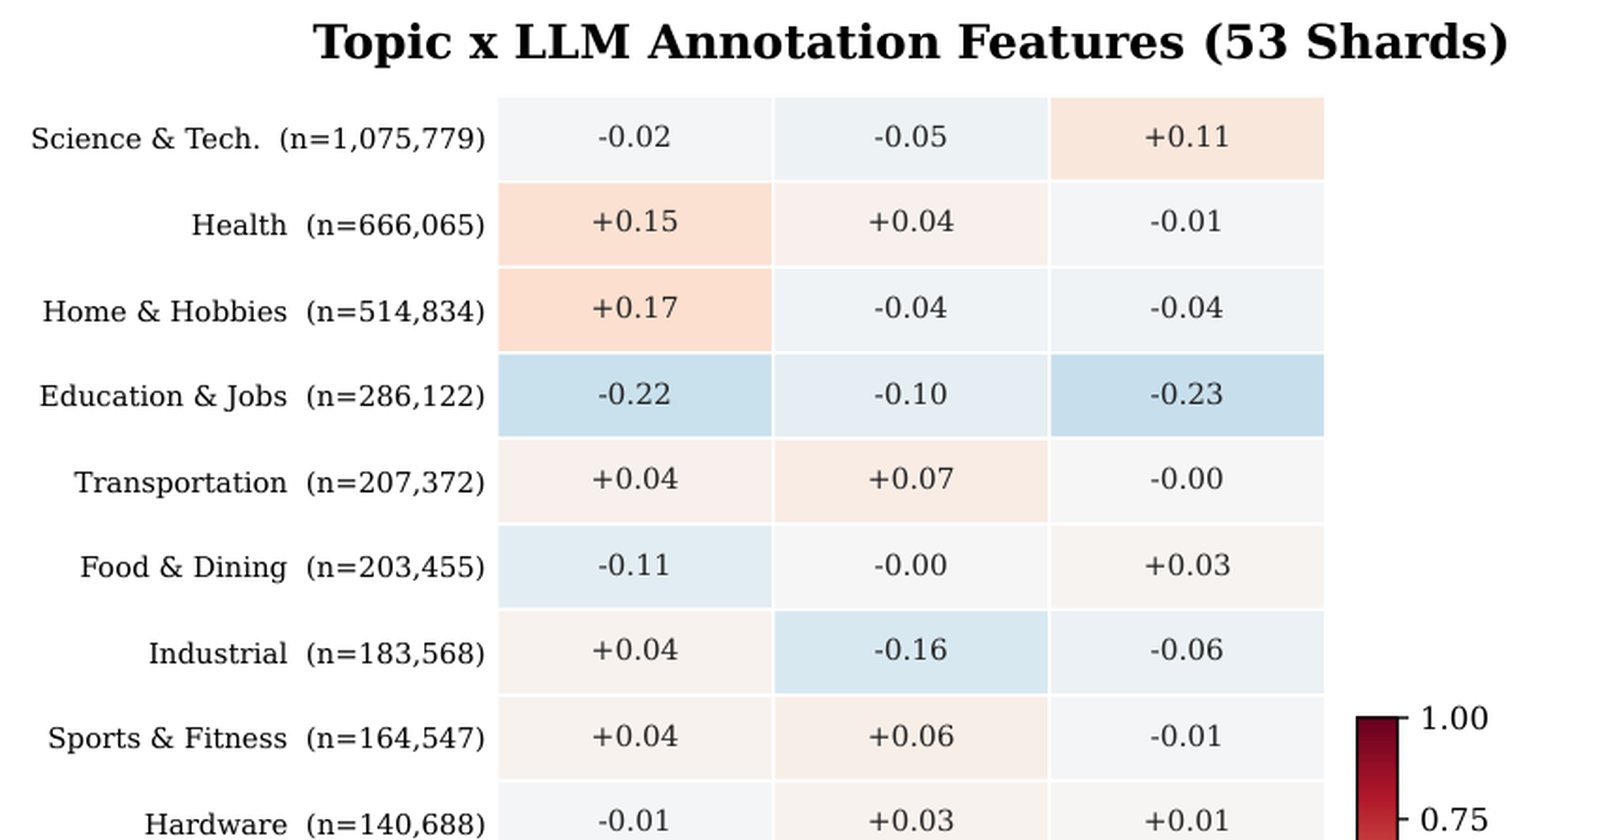
O agente trata a seleção de dados de pré-treinamento como engenharia heurística sobre features por documento: estatísticas lexicais, rótulos categóricos e perplexidade. O AutoData descobre interações entre essas features de forma automática, refinando algoritmos de maneira iterativa a partir de feedback de validação fornecido por um modelo proxy.
O resultado central: dentro de uma busca noturna, o AutoData encontra um algoritmo de seleção que supera pipelines de curadoria existentes, todos desenhados por humanos. A receita descoberta pelo AutoData foi buscada apenas nesse proxy pequeno, mas transferiu para escalas maiores e melhorou a métrica downstream CORE.
Contexto
Agentes baseados em LLM vinham mostrando capacidade de automatizar engenharia de machine learning ao editar código de modelo e de treino sob feedback de execução. Os dados, porém, ficaram fora desse loop de otimização agêntica. A curadoria de dados de pré-treinamento continuou sendo, na prática, trabalho humano de tentativa e erro sobre heurísticas.
O AutoData ataca exatamente essa lacuna. Em vez de otimizar pesos sobre domínios já definidos por pessoas, o agente procura o próprio algoritmo de seleção. É a diferença entre ajustar o volume de cada ingrediente de uma receita fixa e inventar a receita.
Por que importa
Quem treina modelos de linguagem gasta tempo e compute decidindo quais documentos entram no pré-treinamento. Essa decisão costuma ser tomada por heurísticas escritas à mão, difíceis de escalar e de auditar. O AutoData propõe substituir parte desse trabalho por busca automatizada, com validação medida em um modelo proxy.
O ganho prático aparece em duas frentes. A primeira é velocidade: uma busca noturna substitui ciclos longos de experimentação humana. A segunda é transferência: a receita achada pelo AutoData em um proxy pequeno funcionou em escalas maiores, o que reduz o custo de testar ideias de curadoria em modelos grandes.
Impacto
O paper sugere que a engenharia de dados pode ser tratada como um problema de machine learning agêntico. Isso estende a pesquisa autônoma para além da otimização de modelo e de código de treino e alcança a camada de dados. Para equipes que montam pipelines de pré-treinamento, a implicação é direta: parte do trabalho de definir regras de scoring, estratificação e seleção passa a ser candidata a automação.
A métrica citada como beneficiada é a CORE, usada como medida downstream no estudo. O AutoData melhorou a CORE depois que a receita descoberta no proxy foi aplicada em escala maior. O material não informa o tamanho exato do proxy nem os valores numéricos do ganho.
O que muda
Antes, o loop agêntico cobria código de modelo e de treino. Agora, o AutoData mostra que a seleção de dados pode entrar no mesmo loop. Os dados deixam de ser apenas insumo e passam a ser objeto de busca automatizada.
A mudança também afeta como se pensa em curadoria. Pipelines humanos continuam servindo de linha de base, mas o paper relata que o algoritmo achado pelo AutoData superou esses pipelines. A referência de qualidade deixa de ser apenas a heurística escrita por especialistas e passa a incluir algoritmos descobertos por busca.
O que vem agora
O paper é um preprint no arXiv, submetido em 17 de setembro de 2026, e ainda não passou por revisão por pares. O material não traz nomes de autores nem instituições responsáveis, nem detalha os valores exatos de ganho na métrica CORE ou o tamanho do modelo proxy usado na busca.
O caminho natural de verificação é a reprodução por outros grupos, com testes em escalas ainda maiores e em conjuntos de dados variados. Se a transferência do proxy pequeno para modelos grandes se confirmar de forma ampla, a busca agêntica de algoritmos de seleção tende a virar parte do fluxo padrão de quem treina LLMs.
Fontes
- arXiv cs.AI: AutoData: Agentic Search for Pre-training Data Selection (arXiv:2609.19754) https://arxiv.org/abs/2609.19754