
AutoTuring testa se agentes de IA entendem arquitetura de computadores
AutoTuring dá ao mesmo agente o mesmo espaço de 15 dimensões duas vezes: uma com nomes de arquitetura, outra com variáveis anônimas
O que aconteceu
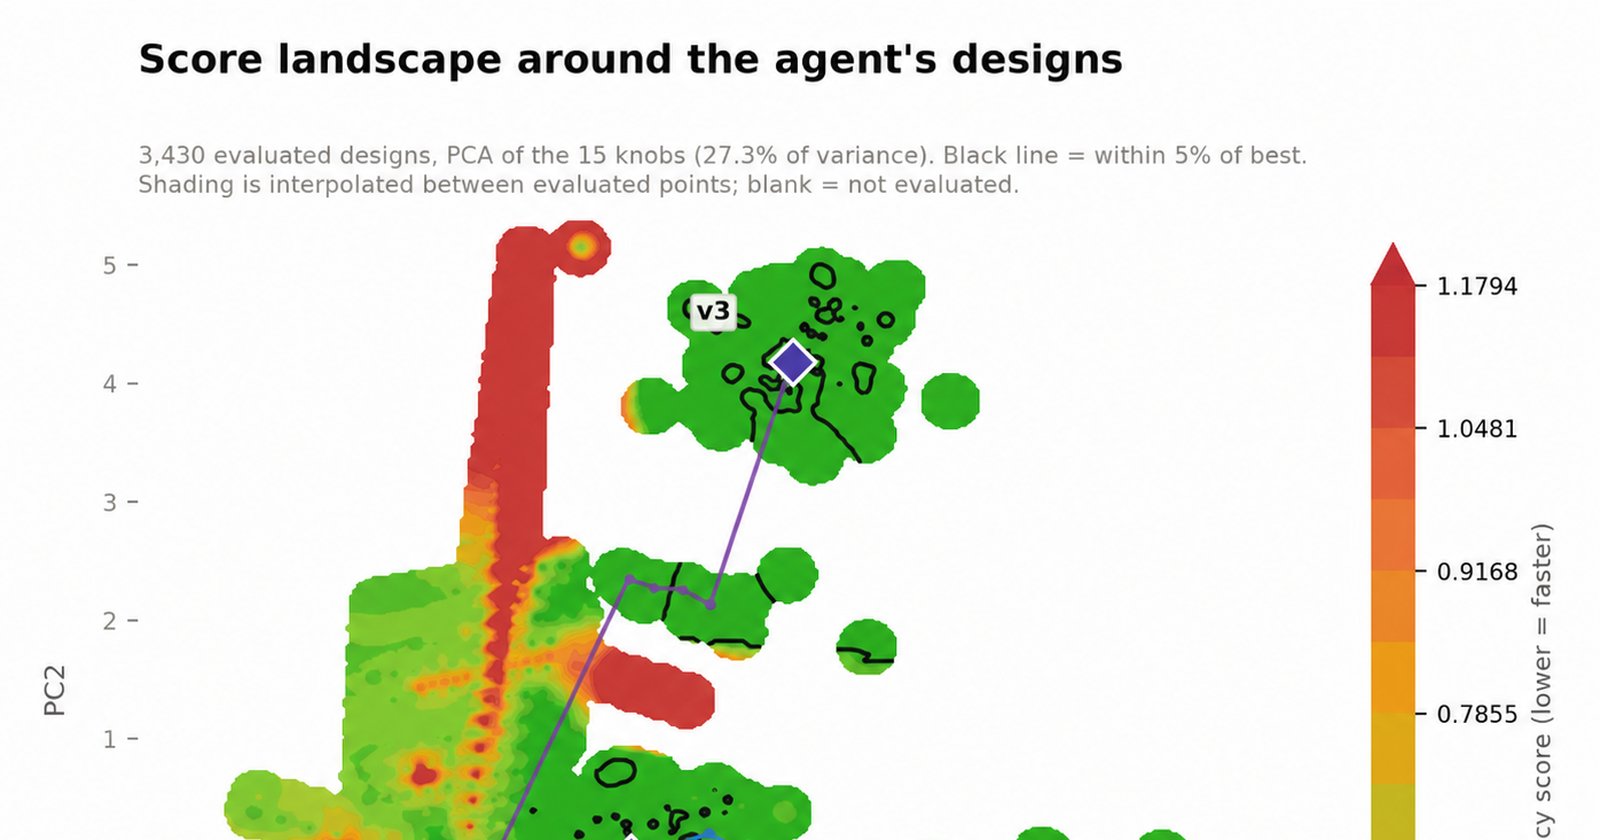
O paper "Do AI Agents Understand Computer Architecture?" foi submetido ao arXiv em 16 de setembro de 2026 e propõe uma forma diferente de avaliar agentes que projetam hardware. O AutoTuring, framework descrito pelos autores, entrega ao mesmo agente o mesmo espaço de 15 dimensões de um acelerador em duas condições. Na primeira, os parâmetros aparecem como knobs arquiteturais nomeados, acompanhados de contadores do simulador. Na segunda, os mesmos parâmetros viram variáveis anônimas no intervalo [0,1].
O avaliador, o espaço legal de busca e os ótimos alcançáveis são mantidos idênticos nas duas rodadas. O que varia é apenas se o problema tem significado. A diferença entre os dois resultados é a medida que o estudo propõe.
Em uma cesta de nove kernels FP16 GEMM, o significado compensa. O agente com acesso aos nomes de arquitetura supera um H200 modelado em 5,4% e bate sua versão cega em 12,3%, em média, usando 70,1% menos chamadas ao simulador.
O ganho não é exclusivo do conhecimento arquitetural. Um loop de crítica recupera a maior parte dessa diferença para o agente cego e não acrescenta nada ao agente que enxerga os nomes. Conhecimento de arquitetura e crítica estruturada se comportam como substitutos, não como complementos.
Contexto
Avaliações existentes de agentes que projetam hardware variam o agente e mantêm fixo o enquadramento do problema. O AutoTuring faz o oposto. Ao congelar o agente, o avaliador e o espaço de busca, o estudo isola uma variável que normalmente fica escondida.
O problema que o paper aponta é simples de enunciar. Quando um agente melhora um acelerador, os relatórios registram que o design ficou melhor, mas não conseguem dizer por quê. O agente pode estar raciocinando sobre a máquina. Ou pode estar percorrendo com competência um conjunto de botões cujo significado nunca recupera. Só o primeiro caso transfere para a próxima arquitetura.
O AutoTuring, portanto, não é um novo acelerador. É um teste de significado. Os próprios autores classificam a comparação, e não o hardware resultante, como a contribuição do trabalho.
Por que importa
A distinção entre raciocínio e busca cega define o valor prático de um agente de design de hardware. Um sistema que só sabe girar botões precisa ser reavaliado do zero a cada nova arquitetura. Um sistema que entende a máquina carrega o aprendizado adiante.
Os números dão dimensão a essa diferença. O agente arquiteto do AutoTuring ficou 5,4% acima de um H200 modelado e 12,3% acima do agente cego, com 70,1% menos chamadas ao simulador. Menos chamadas significa menos tempo de computação gasto por tentativa, o que pesa no custo de qualquer fluxo de projeto automatizado.
O achado sobre o loop de crítica também muda a conta. Se crítica estruturada entrega quase o mesmo resultado que conhecimento arquitetural, equipes podem compensar a falta de um com o outro. As duas capacidades, no experimento, funcionam como substitutas.
Impacto
Para quem avalia agentes de IA aplicados a hardware, o AutoTuring desloca a pergunta central. Em vez de perguntar se o design melhorou, passa a perguntar se a melhora veio de compreensão ou de varredura.
A consequência prática é que benchmarks que só medem o resultado final podem estar inflando a percepção de capacidade dos agentes. O mesmo desempenho pode esconder dois perfis muito diferentes de sistema, com implicações distintas para transferência de conhecimento entre arquiteturas.
O resultado também sugere que investir em mecanismos de crítica dentro do agente pode render mais do que expor vocabulário técnico a um modelo cego. No experimento, o loop de crítica fechou a maior parte da distância sem custo para o agente que já tinha os nomes à disposição.
O que muda
Os autores são explícitos sobre o estágio do trabalho. Os números são preliminares: cinco a seis execuções por condição, em um único acelerador modelado. O paper não reivindica generalização para outras arquiteturas nem para outros agentes.
O que fica estabelecido é o método. O AutoTuring transforma a diferença entre problema nomeado e problema anônimo em uma métrica replicável, com avaliador, espaço legal e ótimos alcançáveis sob controle.
O estudo também reposiciona o debate sobre o que significa um agente "entender" arquitetura de computadores. A resposta do paper não vem de inspeção interna do modelo, e sim de um experimento comportamental com duas condições espelhadas.
O que vem agora
O caminho natural é replicar o desenho em mais aceleradores e com mais execuções por condição, já que o próprio paper trata o resultado como preliminar. A validade do método depende de ele se sustentar fora do cenário único testado.
A outra frente em aberto é a relação entre conhecimento arquitetural e crítica estruturada. Se os dois realmente se comportam como substitutos, o desenho de agentes de projeto de hardware pode priorizar um ou outro conforme o custo de cada abordagem.
Fontes
- arXiv cs.AI: Do AI Agents Understand Computer Architecture? (arXiv:2609.19387) https://arxiv.org/abs/2609.19387