
Benchmark Radar: banco vivo mapeia benchmarks de IA
Sistema reúne descoberta diária, catálogo pesquisável e histórico de scores para avaliações de LLMs e agentes
O que aconteceu
O Benchmark Radar, banco de dados vivo e motor de busca para benchmarks de inteligência artificial, foi apresentado em artigo publicado no arXiv em 10 de setembro de 2026, com o identificador arXiv:2609.11115v1. O sistema cobre avaliação de LLMs, benchmarks agênticos e de uso de ferramentas, programação, raciocínio, segurança e avaliações específicas de domínio.
Um banco de dados vivo dedicado a benchmarks de IA, o Benchmark Radar combina três camadas. A primeira é a descoberta diária de artigos, repositórios, datasets e lançamentos de benchmarks. A segunda é um catálogo pesquisável. A terceira é um histórico de scores vinculado a cada avaliação. O catálogo contém 1.283 registros de fontes, extraídos de 4 catálogos de benchmarks, além de 12.916 observações numéricas distribuídas em 790 registros.
A coleta diária do Benchmark Radar se apoia em 37 fontes, sendo 13 conectores diretos e 24 feeds próprios de pesquisa e engenharia. O sistema também rastreia menções a benchmarks em model cards e relatórios técnicos. Cada registro mantém a identidade da fonte e as citações originais, para que o leitor inspecione o benchmark candidato e a evidência por trás de cada score.
Os autores descrevem o processo de coleta e recuperação, auditam o catálogo completo e analisam saturação de benchmarks, tendências de adoção e os limites das comparações de score. O artigo traz ainda um exemplo completo de busca de prior art, mostrando como consultar o catálogo e examinar evidências ao desenhar uma nova avaliação.
Contexto
O problema que o Benchmark Radar ataca é conhecido por quem trabalha com modelos de linguagem. Pesquisadores de benchmark e desenvolvedores de LLMs precisam localizar avaliações relevantes, encontrar os datasets e o código por trás delas e entender as configurações usadas para produzir os números divulgados. Sem essas três peças, comparar scores entre modelos vira exercício de adivinhação.
O catálogo do Benchmark Radar, um sistema de recuperação e descoberta de benchmarks de IA, parte dessa necessidade declarada no próprio artigo. As menções em model cards e relatórios técnicos funcionam como rastro de adoção: mostram quais avaliações estão sendo usadas de fato, e não apenas publicadas. O histórico de scores permite ver a evolução de um mesmo benchmark ao longo do tempo.
A auditoria do catálogo completo e a análise de saturação tratam de um fenômeno recorrente na área. Quando modelos topam a métrica de um benchmark, o poder de discriminação da avaliação cai e os scores deixam de separar sistemas diferentes. O artigo examina esse limite e o que ele significa para comparações entre modelos.
Por que importa
Para quem desenvolve LLMs, o custo de escolher o benchmark errado é alto. Uma avaliação mal especificada pode favorecer um modelo por conta de configuração, não de capacidade. O Benchmark Radar guarda as citações e a identidade da fonte justamente para permitir essa verificação.
Para empresas que compram ou integram modelos de IA, o impacto é direto no processo de seleção. Um catálogo pesquisável com histórico de scores reduz a dependência de números soltos divulgados em anúncios. A visão de saturação ajuda a identificar quais benchmarks ainda separam modelos e quais já perderam utilidade prática.
Para pesquisadores que vão criar uma nova avaliação, o exemplo de busca de prior art mostra o caminho: consultar o catálogo, checar o que já existe e inspecionar a evidência antes de propor mais um benchmark.
Impacto
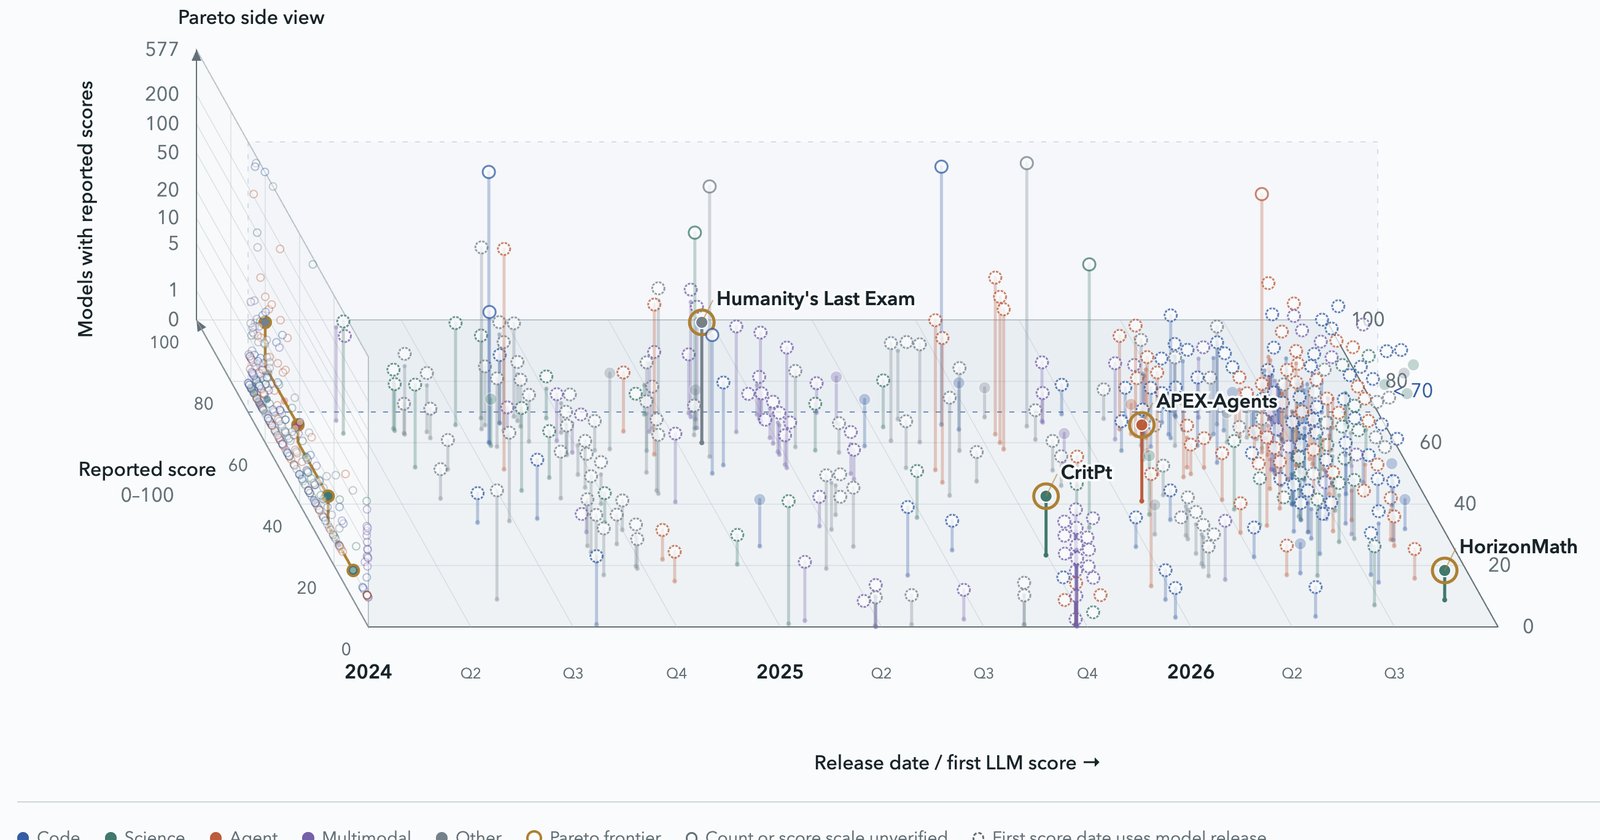
O artigo acompanha o lançamento de um dashboard web com cinco componentes principais. Um leaderboard de benchmarks, uma visão de fronteira de Pareto que cruza score com uso medido, visões de saturação e de tendências, feeds diários e evidência baixável. Há também uma interface de linha de comando (CLI) para consultas offline e análise reproduzível.
A fronteira de Pareto é o componente mais ambicioso do ponto de vista analítico. Ao cruzar desempenho com uso medido, o Benchmark Radar tenta responder uma pergunta que scores isolados não respondem: um benchmark é difícil, ou apenas pouco adotado? Benchmarks saturados aparecem na visão de saturação, e as tendências mostram quais avaliações ganham ou perdem tração ao longo do tempo.
O que muda
O Benchmark Radar muda o ponto de partida de quem avalia modelos de IA. Em vez de garimpar avaliações em repositórios dispersos, o pesquisador passa a consultar um catálogo único com 1.283 registros de fontes e 12.916 observações numéricas, atualizado diariamente a partir de 37 fontes.
O que vem agora
O artigo é aberto, e o dashboard do Benchmark Radar foi liberado com leaderboard, visão de fronteira de Pareto, visões de saturação e tendências, feeds diários, evidência baixável, CLI para consultas offline e análise reproduzível. A descoberta de papers, repositórios, datasets e lançamentos de benchmarks segue em ciclo diário, alimentada pelos 13 conectores diretos e pelos 24 feeds de pesquisa e engenharia.
Fontes
- arXiv cs.AI: Benchmark Radar: A Living Database and Search Engine for AI Benchmarks and Evaluation (arXiv:2609.11115v1) | https://arxiv.org/abs/2609.11115