
Benchmark Unwritten expõe limite de IA multimodal em raciocínio abstrato
Novo benchmark desafia modelos a decifrar palavras pelo som da caneta e vídeo da mão, sem ver a tinta
O que aconteceu
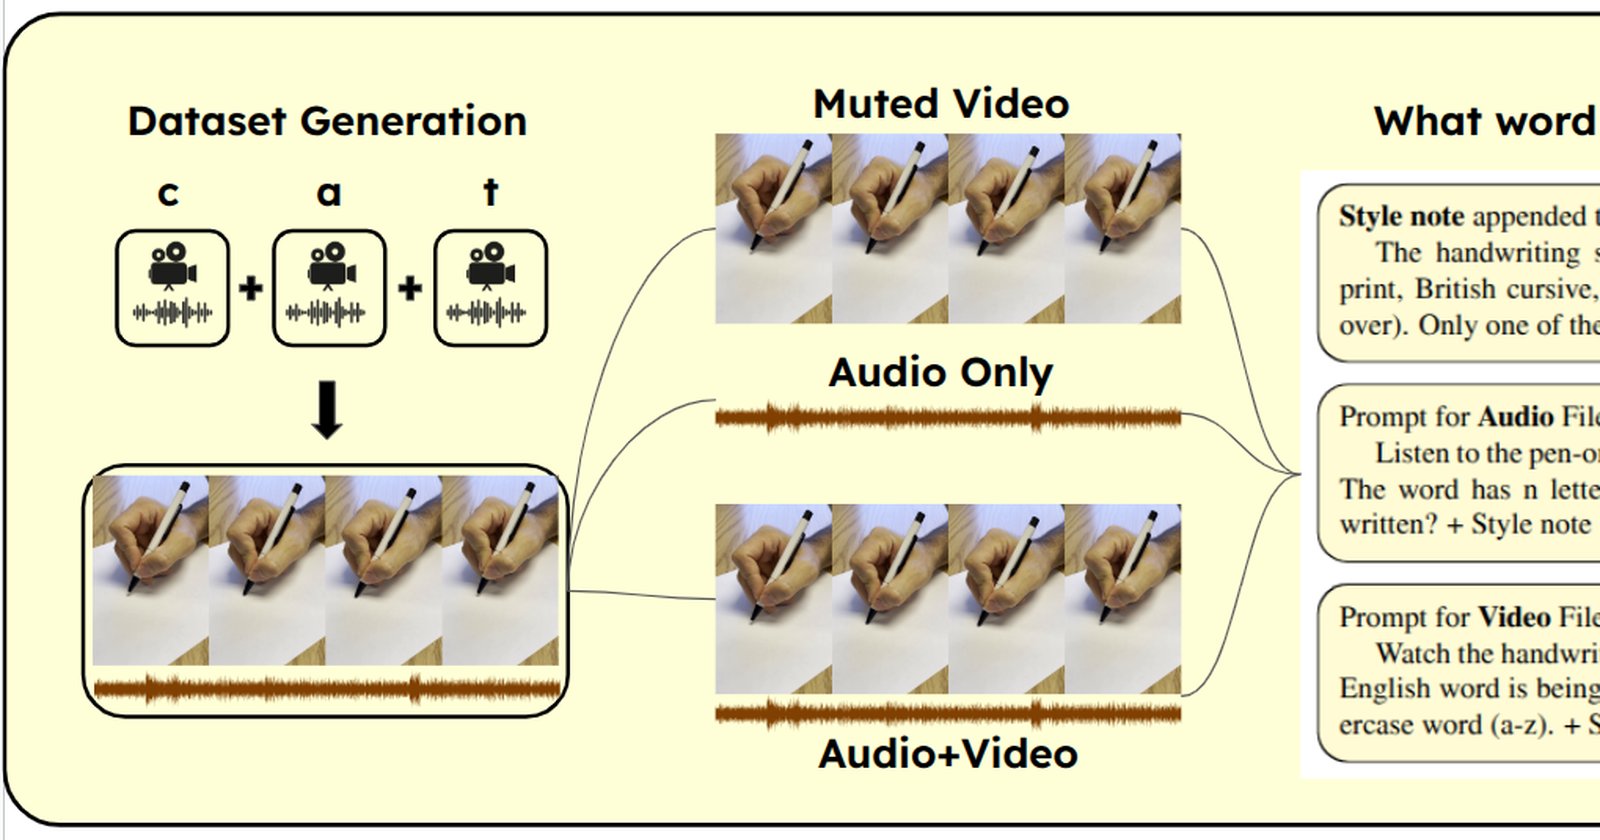
Um estudo submetido ao arXiv (ID 2608.14558) introduz o The Unwritten Benchmark, uma nova avaliação que testa a capacidade de modelos multimodais de realizar inferências a partir de processos dinâmicos e generativos – algo além do reconhecimento estático de imagens e áudio. A tarefa central, chamada de "inferência de palavras acústico-cinemática", exige que o modelo decifre palavras sendo escritas em três estilos caligráficos diferentes, com base apenas no áudio do rastro da caneta e no vídeo do movimento da mão, sem qualquer traço de tinta visível.
O resultado é contundente: participantes humanos alcançam mais de 80% de precisão na ordem das letras, enquanto os principais modelos multimodais atuais – incluindo GPT-4o e Gemini 2.5-Pro – não ultrapassam 10%. Além disso, o estudo identificou um "efeito de fusão paradoxal": quando ambos os modos (áudio e vídeo) são fornecidos juntos, o desempenho dos modelos frequentemente piora em vez de melhorar. Isso indica uma falha estrutural na síntese de pistas perceptuais complementares.
Contexto
O avanço dos modelos multimodais tem sido notável em tarefas como reconhecimento de objetos, legendagem de imagens e transcrição de fala. No entanto, a capacidade de raciocínio abstrato – inferir informações não visíveis a partir de pistas indiretas e processos gerativos – permanece pouco explorada. O benchmark foi criado para preencher essa lacuna, propondo uma tarefa que imita uma habilidade humana cotidiana: entender o que está sendo escrito apenas pelo som e pelo movimento, sem ver o resultado.
A escolha de testar GPT-4o e Gemini 2.5-Pro não é aleatória: são dois dos modelos mais avançados disponíveis publicamente. A queda para menos de 10% de acerto os coloca no mesmo nível de um palpite aleatório, evidenciando que a compreensão de microcinemática e de causalidade entre modalidades ainda está longe do alcance das máquinas.
Por que importa
Esses resultados têm implicações diretas para aplicações em que a interpretação de pistas sutis é crítica. Sistemas de assistência a pessoas com deficiência visual, por exemplo, poderiam se beneficiar de modelos capazes de "ler" gestos e sons ambientes. Também afetam áreas como robótica, onde entender ações humanas a partir de áudio e vídeo é essencial para interação física segura.
No Brasil, o debate sobre regulação de IA e o uso de modelos em educação, saúde e indústria ganha um novo argumento: as ferramentas atuais ainda não são confiáveis para tarefas que exigem julgamento perceptual e raciocínio causal. Empresas que planejam implementar IA multimodal em processos que dependem de leitura de contexto não verbalizado precisam considerar essas limitações.
Impacto
A curto prazo, o benchmark deve se tornar uma referência para avaliar próxima geração de modelos. A descoberta do "efeito de fusão paradoxal" – onde adicionar informação degrada o desempenho – é um alerta para arquiteturas que simplesmente concatenam entradas de diferentes modalidades sem uma verdadeira integração semântica.
A médio prazo, os resultados podem impulsionar novas linhas de pesquisa em aprendizado causacional, atenção cruzada e modelagem de processos físicos. Também podem acelerar o desenvolvimento de modelos especializados em tarefas de raciocínio espacial e cinestésico, em vez de depender apenas de escala.
O que muda
Para a comunidade de IA, a lição é que a multimodalidade não é apenas soma de canais. A falta de compreensão de micro-kinematics – os movimentos mínimos que comunicam intenção – expõe que os modelos não constroem modelos internos do mundo físico. Isso questiona abordagens que priorizam dados estáticos e rotulados em massa.
Para usuários e desenvolvedores, o estudo reforça a necessidade de avaliações mais próximas de tarefas humanas e de métricas que vão além de benchmarks triviais de reconhecimento.
O que vem agora
O artigo, enviado em 15 de maio de 2026, ainda está em revisão e não traz código ou dados publicamente disponíveis. Espera-se que os autores liberem o dataset e as instruções para reprodução, permitindo que outros grupos validem os resultados. Também é provável que o benchmark inspire novas versões com mais estilos de escrita e idiomas, além de testes com modelos futuros.
A pergunta que fica é se a próxima geração de modelos – que deve trazer integração mais profunda entre visão, áudio e linguagem – conseguirá diminuir a distância de 70 pontos percentuais. Até lá, humanos seguem imbatíveis no que mais fazem naturalmente: inferir o invisível.
FONTES
- arXiv cs.AI | RESEARCH | The Unwritten Benchmark: A New Challenge for Multimodal Machine Learning in Abstract Perceptual Reasoning — arXiv:2608.14558 (https://arxiv.org/abs/2608.14558)