
Cal-OPD calibra destilação entre professor e aluno em IA
Novo método separa a lacuna real de capacidade do aluno do desvio próprio do professor
O que aconteceu
Um artigo submetido ao arXiv em 18 de setembro de 2026 propõe o Calibrated On-Policy Distillation, abreviado como Cal-OPD. O Cal-OPD é um método para treinar modelos de raciocínio que corrige uma falha conhecida da destilação on-policy (OPD). O trabalho está registrado no arXiv sob o identificador 2609.21619v1, com título "Calibrating Teacher-Student Discrepancy for On-Policy Distillation".
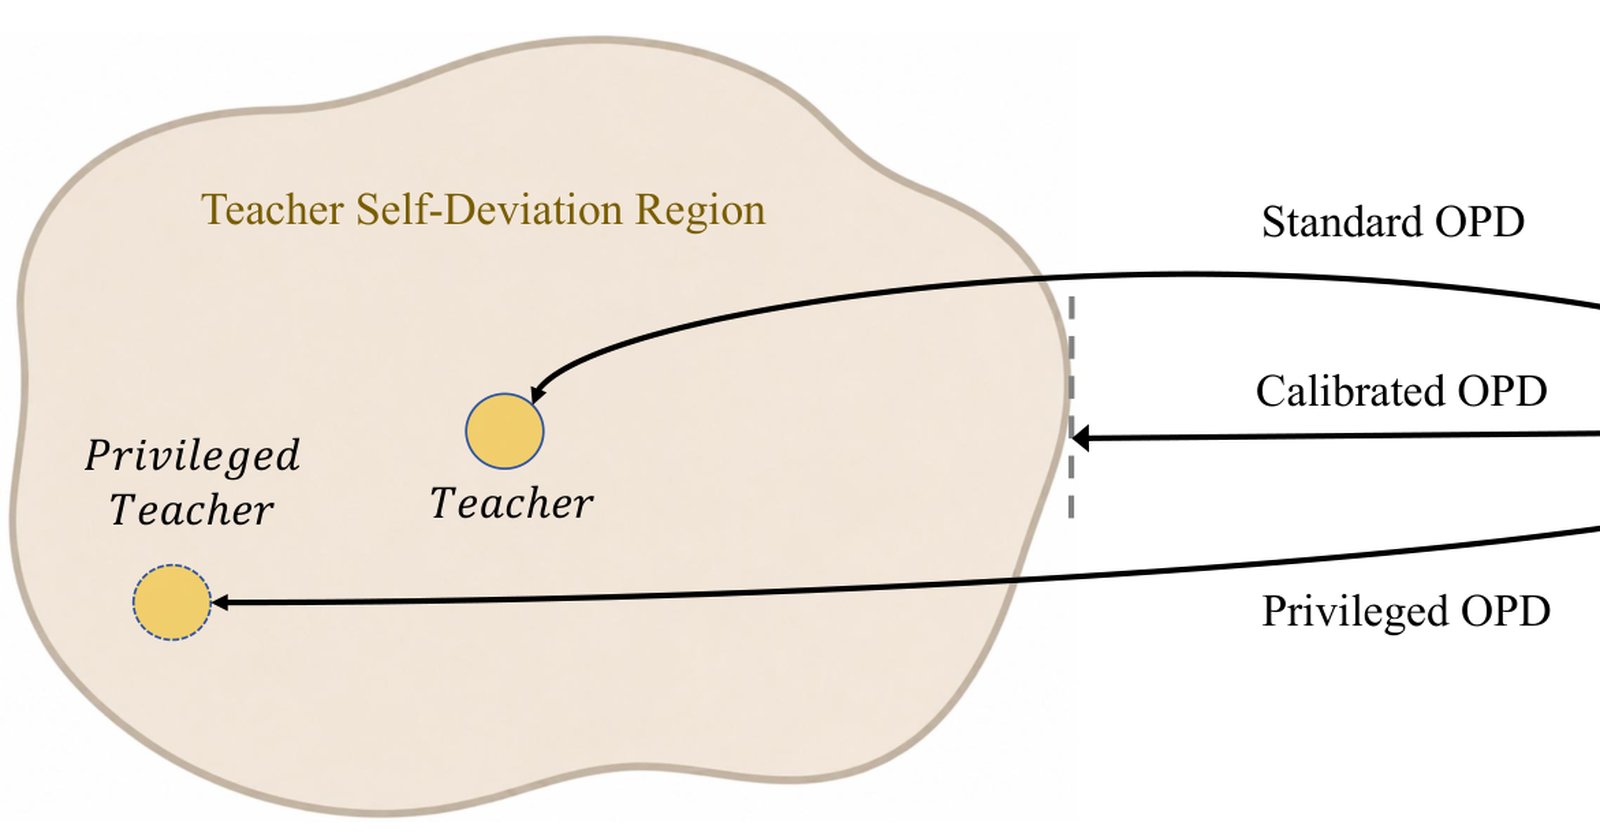
A destilação on-policy (OPD) treina um modelo aluno aprendendo a discrepância em nível de token entre um professor mais forte e o aluno durante a própria geração deste. O artigo afirma que essa discrepância não reflete puramente a diferença de capacidade entre professor e aluno. Segundo os autores, ela carrega também desvios originados no próprio professor, que o OPD padrão aprende de forma indiscriminada durante o treinamento.
O Cal-OPD, método descrito no artigo arXiv:2609.21619v1, estima a região de autodesvio do professor por meio de intervenções privilegiadas positivas e negativas. A partir dessa estimativa, o Cal-OPD calibra a discrepância original entre professor e aluno e retém apenas o componente que fica além dessa região.
Nos experimentos com benchmarks de raciocínio matemático, o método manteve cerca de 52% a 65% da discrepância original como sinal de otimização. Mesmo descartando boa parte do sinal, o Cal-OPD superou o OPD padrão e suas variantes em diferentes escalas de modelo.
Contexto
A destilação on-policy ganhou espaço porque permite que o aluno aprenda no próprio caminho de geração, em vez de imitar uma base de dados fixa produzida antes do treino. O ganho vem do sinal token a token entre professor e aluno.
O artigo aponta uma variante chamada privileged OPD. Nessa configuração, informação privilegiada induz deslocamentos maiores de verossimilhança no lado do professor. O efeito é justamente o que os autores querem evitar: o aluno é empurrado a aprender mais do desvio do próprio professor, e não apenas o que separa um modelo forte de um modelo fraco.
A privileged OPD, portanto, agrava o problema que o Cal-OPD tenta resolver. O OPD padrão mistura as duas coisas no mesmo sinal, e é essa mistura que o novo método ataca.
Por que importa
Destilação é uma das formas mais usadas de baratear inferência: um modelo grande ensina um modelo menor, que passa a rodar mais rápido e mais barato. Se o sinal de treinamento carrega ruído do professor, o aluno aprende a copiar defeitos que não têm relação com a tarefa.
O resultado do Cal-OPD sugere que quase metade do sinal usado hoje em OPD pode ser descartada sem perda, e com ganho. O artigo relata que, retendo entre 52% e 65% da discrepância original, o desempenho melhora de forma consistente em relação ao OPD padrão e às suas variantes, em todas as escalas de modelo testadas.
O material não informa quais modelos foram usados nem quem são os autores, e o artigo é um preprint, sem revisão por pares concluída. Isso limita a leitura dos números por enquanto.
Impacto
Para equipes que treinam modelos de raciocínio com destilação, a mensagem prática é contraintuitiva: menos sinal pode render mais. Filtrar o autodesvio do professor funciona como uma etapa de calibração antes da otimização, e não como um corte de escopo.
O Cal-OPD, método proposto no artigo arXiv:2609.21619v1, mira um problema estrutural da destilação on-policy. A destilação on-policy, por sua vez, é a base de boa parte dos pipelines de modelos pequenos voltados a matemática e lógica.
Se os resultados se sustentarem em replicações independentes, o custo de treinar um aluno tende a cair, porque menos sinal precisa ser processado e o aluno deixa de perseguir um alvo contaminado.
O que muda
O artigo reposiciona a pergunta central da destilação. Em vez de perguntar quanto o professor sabe a mais que o aluno, o Cal-OPD pergunta quanto do erro observado pertence ao professor.
A medição vem das intervenções privilegiadas, positivas e negativas, que delimitam a região de autodesvio. Só o que ultrapassa essa fronteira entra como sinal de otimização.
O que vem agora
O próximo passo natural é a replicação fora do grupo que escreveu o artigo, em outras tarefas além de raciocínio matemático. O material não menciona disponibilização de código, dados ou pesos treinados.
O artigo também não indica prazo para submissão a conferência ou revisão por pares. Até que isso ocorra, o número de 52% a 65% deve ser lido como resultado de preprint, a ser confirmado por terceiros.
Fontes
arXiv cs.AI: Calibrating Teacher-Student Discrepancy for On-Policy Distillation (https://arxiv.org/abs/2609.21619)