
CAMA: framework combate viés em memórias de sistemas multi-agente
Pesquisadores desenvolvem método para garantir evidências independentes em sistemas de agentes autônomos.
O que aconteceu
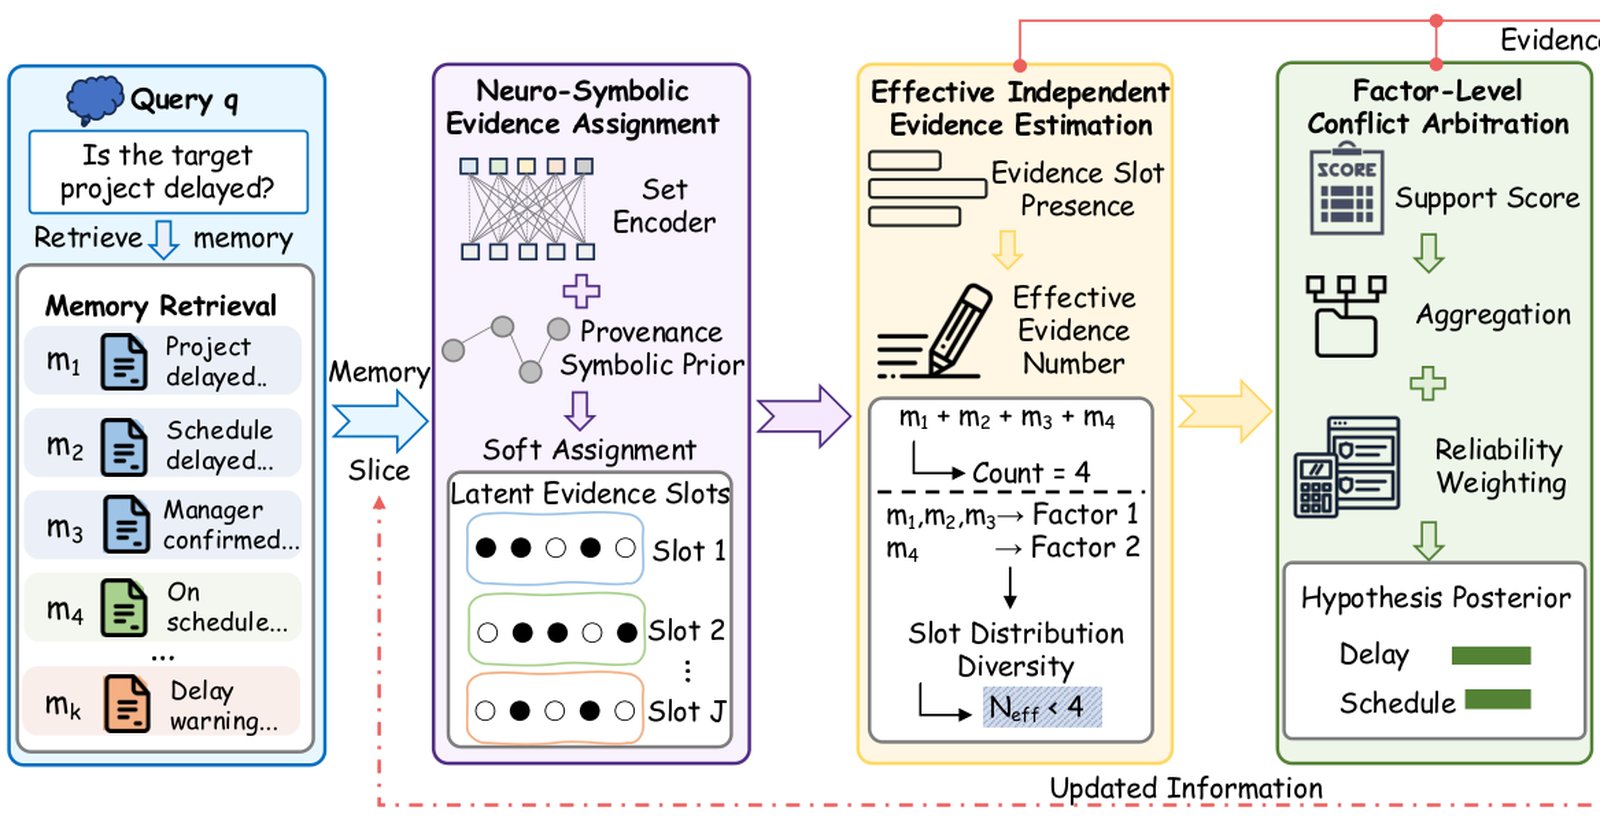
Em 20 de agosto de 2026, um novo estudo foi divulgado no arXiv, introduzindo o framework Correlation-Aware Memory Arbitration (CAMA). O trabalho, intitulado "Beyond Memory Majority: Latent-Source Reasoning for Multi-Agent Memory Arbitration", aborda um problema crítico em sistemas de inteligência artificial multi-agente: o viés de correlação em memórias.
Contexto
Sistemas de IA multi-agente de longo prazo acumulam memórias geradas por diferentes agentes. Métodos existentes tratam essas memórias como evidências independentes e as combinam por votação ou ponderação. No entanto, essa suposição de independência falha frequentemente em cenários multi-agente, pois memórias podem herdar a mesma fonte upstream ou vieses compartilhados. Isso cria evidências correlacionadas que são contadas repetidamente, formando uma maioria falsa. Os autores denominam essa falha "Memory Correlation Bias".
Por que importa
O viés de correlação pode distorcer a tomada de decisão em sistemas de IA, afetando áreas como agentes autônomos, plataformas colaborativas e sistemas de suporte. Para empresas e desenvolvedores, isso significa risco de decisões baseadas em informações redundantes, comprometendo eficiência e confiabilidade. O CAMA propõe uma solução para garantir que evidências independentes sejam consideradas, melhorando a precisão das arbitragens de memória.
Impacto
A curto prazo, o framework pode ser integrado em sistemas existentes para suprimir maiorias falsas induzidas por memórias correlacionadas. A médio prazo, pode impulsionar o design de agentes de IA mais robustos, com aplicações em campos como pesquisa, finanças e operações complexas. Exemplos em benchmarks demonstram superioridade sobre métodos state-of-the-art, validando a eficácia do CAMA.
O que muda
O CAMA altera a abordagem padrão de arbitragem de memória ao decuplar evidências recuperadas e recuperar evidências independentes ausentes. Ele modela memórias como grupos de evidências condicionados a consultas e combina inferência de dependência neural com priors simbólicos baseados em procedência. Isso permite estimar o número efetivo de fontes independentes, prevenindo maiorias falsas.
O que vem agora
Os próximos passos incluem a validação do CAMA em mais benchmarks e a exploração de sua aplicação em sistemas reais. Pesquisadores planejam expandir os estudos de caso e integrar o framework com outras técnicas de IA para aprimorar a recuperação sequencial de evidências e minimizar custos de recuperação.
Fontes
- arXiv: Beyond Memory Majority: Latent-Source Reasoning for Multi-Agent Memory Arbitration (https://arxiv.org/abs/2608.19701)