
CEDAR-GRPO melhora raciocínio abdutivo em LLMs com reforço process-aware
Framework combina recompensas por cobertura de evidências e direcionalidade para melhorar capacidade de inferir a melhor explicação
O que aconteceu
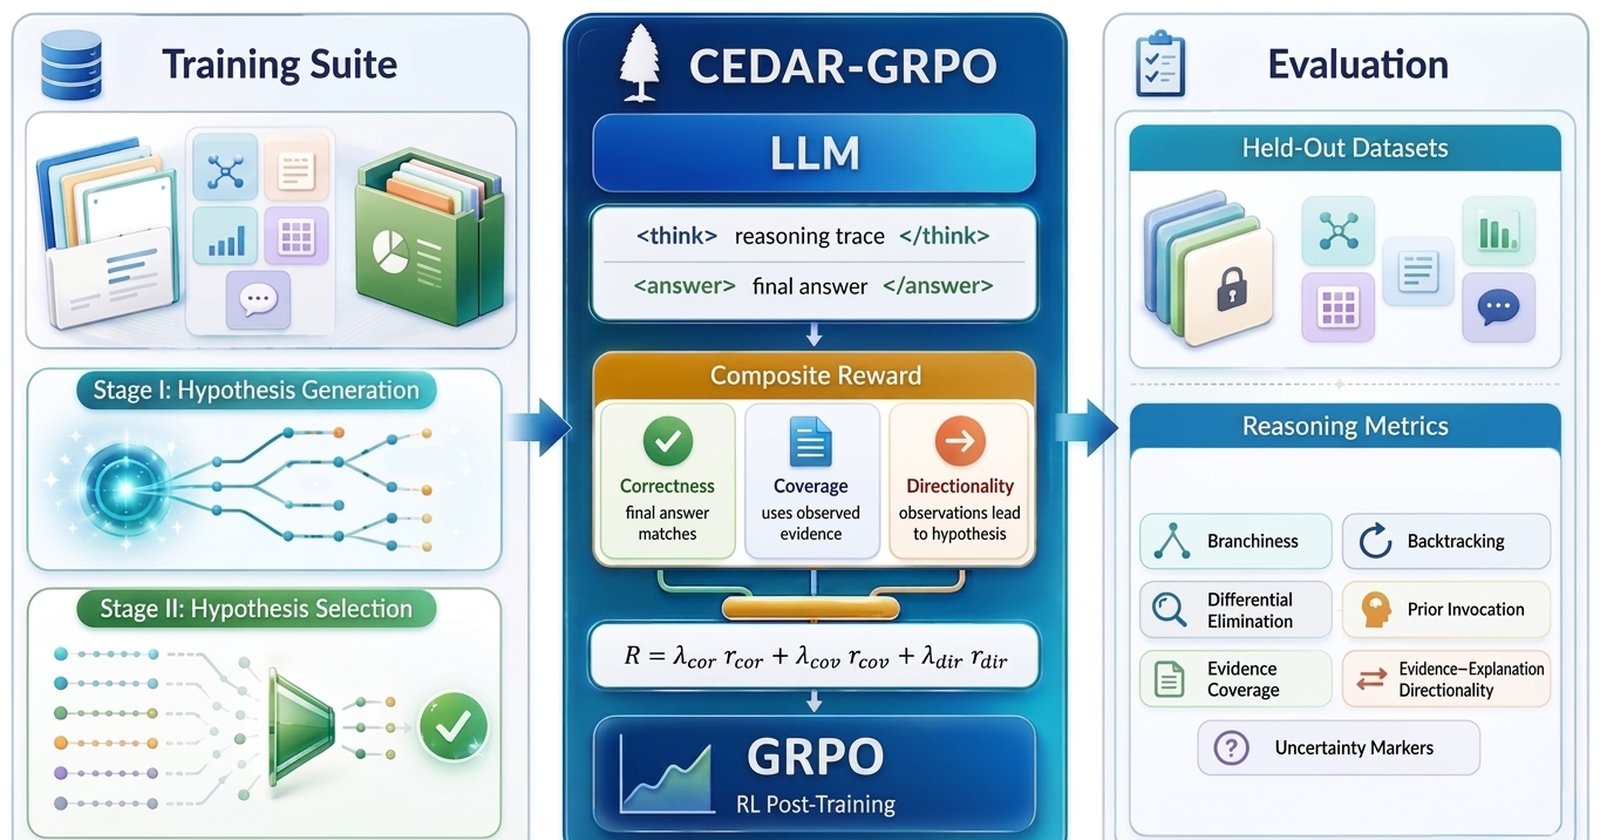
O paper "CEDAR-GRPO: Process-Aware Reinforcement Learning for General Abductive Reasoning in LLMs" foi submetido ao arXiv em 14 de agosto de 2026. O estudo introduz um framework que combina a correção da resposta final com recompensas específicas para raciocínio abdutivo: cobertura das evidências e direcionalidade da evidência para a explicação. Quatro LLMs open-weight foram pós-treinadas com uma mistura controlada e neutra de domínio de tarefas de geração e seleção de hipóteses abdutivas.
Os modelos foram avaliados em 11 tarefas "não vistas" (held-out), incluindo seleção de hipóteses, geração de fatos ausentes, inferência refutável, investigação de contexto longo, raciocínio clínico, depuração de código e controles não-abdutivos. O CEDAR-GRPO melhorou o desempenho de cada modelo em cada tarefa, tanto em relação aos modelos base quanto a um método de RL apenas baseado em correção (GRPO). Os ganhos médios foram de 7,4 e 2,7 pontos, respectivamente, com um ganho máximo de 30,8 pontos em uma única tarefa.
Contexto
O raciocínio abdutivo – inferir a melhor explicação a partir de evidências incompletas – é fundamental para o raciocínio humano sob incerteza. Até então, a pesquisa com LLMs o estudava mainly através de benchmarks específicos e estreitos, levantando a questão de se os ganhos observados se transfeririam para além das tarefas de treino. O estudo busca responder se o RL pós-treinamento pode melhorar a abdução como uma capacidade de raciocínio transferível.
Por que importa
O trabalho ataca diretamente o problema da transferência de habilidades de raciocínio em IA. Demonstra que é possível treinar LLMs para raciocinar melhor em situações abertas e de incerteza, algo crucial para aplicações do mundo real onde as respostas não são simplesmente "corretas" ou "incorretas", mas dependem de quão bem o raciocínio se sustenta nas evidências disponíveis. Isso tem implicações diretas para ferramentas de assistência à decisão em áreas como diagnóstico clínico, análise de segurança de software e investigação.
Impacto
No curto prazo, o framework fornece uma metodologia mais robusta para treinar modelos com capacidade de raciocínio processual. No médio prazo, pode contribuir para o desenvolvimento de LLMs que são mais confiáveis em tarefas complexas que exigem explicação e justificativa, e não apenas classificação ou geração de texto. A ablação do estudo confirma que o RL, o design de recompensas abdutivas e a diversidade de tarefas são fatores-chave para essa transferência.
O que muda
A pesquisa muda o foco de benchmarks de resposta final para a análise do processo de raciocínio. Métricas processuais usadas no estudo, como exploração de alternativas, eliminação de rivais, backtracking e marcação de incerteza, mostraram comportamento abdutivo mais forte. Isso abre caminho para avaliar e melhorar a "qualidade" do pensamento das IAs, não apenas a acurácia final.
O que vem agora
Os autores indicam que trabalhos futuros podem explorar a aplicação do CEDAR-GRPO a outras famílias de modelos e expandir o conjunto de recompensas processuais. O framework também pode ser integrado a pipelines de desenvolvimento de modelos para melhorar o desempenho em tarefas que requerem explicação e raciocínio sob incerteza.