
CGM-Rec: memória de grafos contínua melhora recomendação sob mudança de intenção
Framework trata o grafo de conhecimento como memória gravável e se adapta sem retreinar os parâmetros do modelo
O que aconteceu
O arXiv publicou em 4 de setembro de 2026 o artigo "Continual Graph Memory for Adaptive Recommendation under Intent Drift" (arXiv:2609.04651v1), que propõe o CGM-Rec, um framework de memória de grafos contínua para recomendação adaptativa. O problema atacado é o chamado intent drift: a intenção do usuário muda ao longo do tempo, e o feedback de cada recomendação revela se a evidência relacional usada no ranking é útil, ausente ou enganosa.
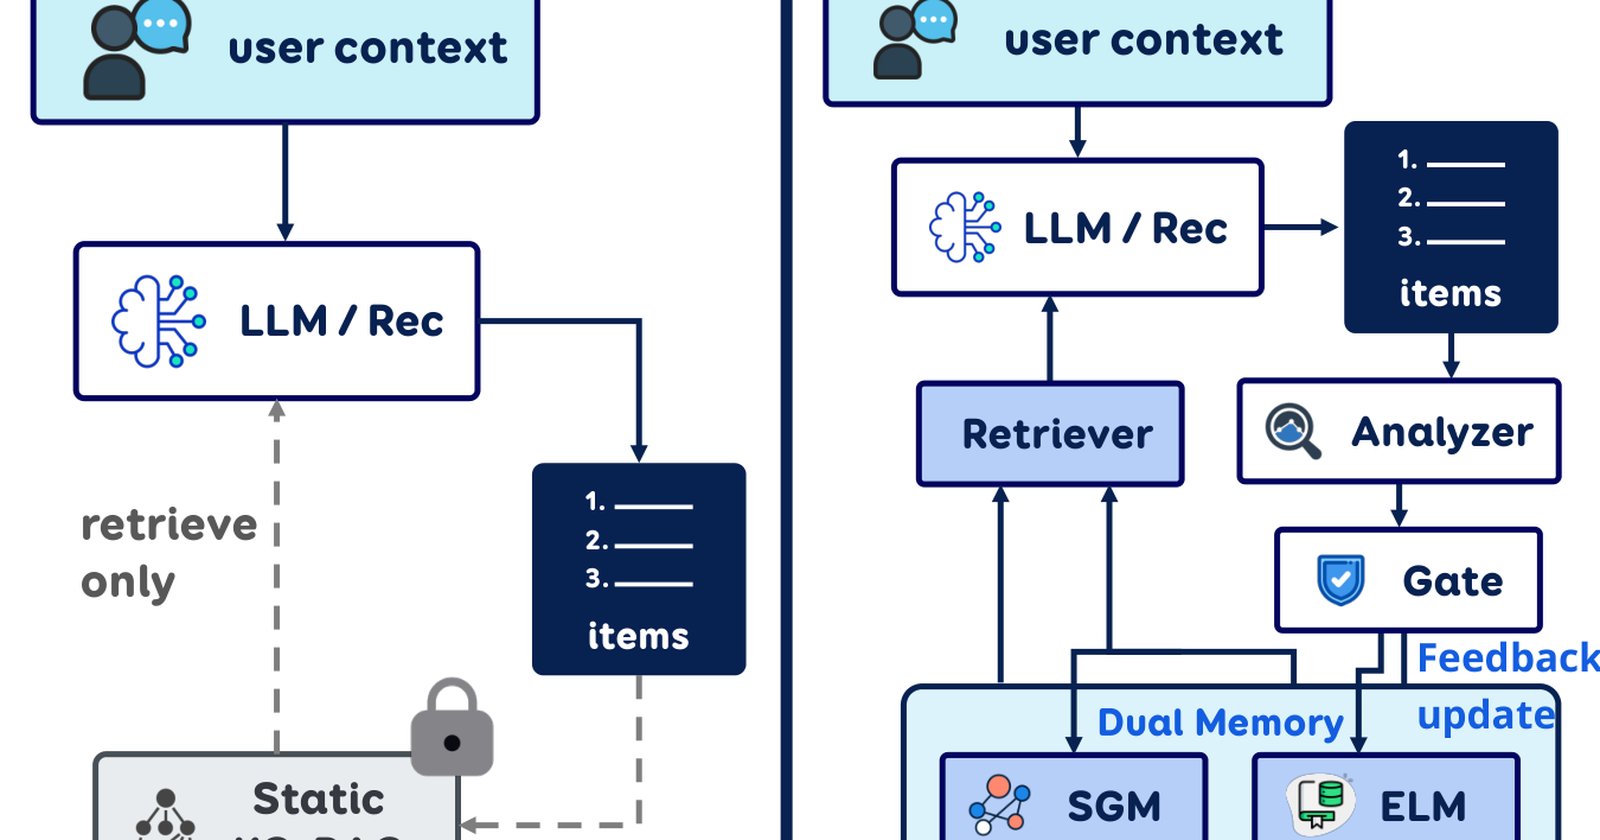
O CGM-Rec trata o estado do grafo como uma memória gravável e mantém dois componentes complementares. A Semantic Graph Memory é atualizada de forma conservadora, por meio de operações tipadas com controle de qualidade, para armazenar conhecimento relacional estável e de alta confiança. Já a Episodic Lesson Memory funciona como uma memória reativa rápida, que aprende com resultados recentes, casos de falha e dicas corretivas.
O detalhe técnico central: durante o teste, os parâmetros do modelo permanecem congelados. A adaptação ocorre apenas por escritas na memória, num protocolo de reranking em uma passada (one-pass reranking) em que encoders e prompts ficam fixos.
Contexto
Sistemas de recomendação aprimorados por Knowledge Graphs (KGs) usam a estrutura semântica do grafo para lidar com mudanças de comportamento. O artigo aponta, porém, que os sistemas tradicionais tratam o grafo como um substrato estático de recuperação. Essa abordagem estática torna o sistema frágil diante de intenções em evolução, metadados ruidosos e padrões de falha recorrentes.
O CGM-Rec inverte essa lógica. Em vez de um grafo fixo que apenas alimenta o ranking, o framework do CGM-Rec permite escrever no grafo continuamente, separando o que merece virar conhecimento duradouro (memória semântica conservadora) do que é aprendizado imediato de erros (memória episódica reativa).
Por que importa
Os números dos experimentos sustentam a proposta. Em cenários de reranking com candidatos amostrados, o CGM-Rec melhora o HR@1 em até 29,58% sobre o baseline de LLM mais forte no dataset Bundle. No ML-100K, dataset rico em metadados, o framework supera o K-RagRec com HR@5 de 0,5941 contra 0,4746. Em múltiplos cenários de recomendação, o CGM-Rec superou os baselines neurais e baseados em LLM avaliados na maioria das métricas.
A implicação prática é econômica: como os parâmetros ficam congelados e a adaptação acontece só por escritas na memória, não é preciso retreinar o modelo nem ajustar encoders quando o comportamento do usuário muda. Isso reduz custo de infraestrutura e o tempo de reação a mudanças de intenção.
Impacto
Para plataformas de e-commerce, streaming e marketplaces, a arquitetura proposta pelo CGM-Rec sugere um caminho para recomendações que corrigem falhas recorrentes em tempo real. A Episodic Lesson Memory registra casos de falha e dicas corretivas, enquanto a Semantic Graph Memory filtra o que é confiável antes de consolidar. A separação entre memória conservadora e reativa reduz o risco de o sistema aprender com metadados ruidosos.
Para a área de pesquisa, o protocolo de avaliação com parâmetros congelados e reranking em uma passada oferece um padrão comparável para medir adaptação sem retreino, um ponto cego de boa parte dos benchmarks atuais.
O que muda
O que muda na prática é o papel do grafo de conhecimento. O grafo deixa de ser estrutura estática de consulta e passa a ser memória ativa do sistema. O CGM-Rec, framework de memória de grafos contínua, demonstra que essa memória gravável, combinada a parâmetros congelados, é suficiente para superar baselines de LLM em métricas como HR@1 e HR@5.
O que vem agora
O trabalho está na fase de preprint no arXiv, com submissão em 4 de setembro de 2026, e ainda precisa passar por revisão por pares. Os próximos passos naturais envolvem reprodução independente dos resultados em Bundle e ML-100K, comparações com novos baselines de LLM e, eventualmente, testes em produção por plataformas de recomendação. O artigo não anuncia código público nem parcerias; a página do arXiv indica ferramentas de citação e repositórios associados ainda em carregamento.