
Compressão Adaptativa em RAG Pode Reduzir Consumo de GPU em 53% em Dispositivos Edge
Pesquisa da arXiv propõe ajuste dinâmico da compressão de contexto para otimizar IA em hardware limitado.
O que aconteceu
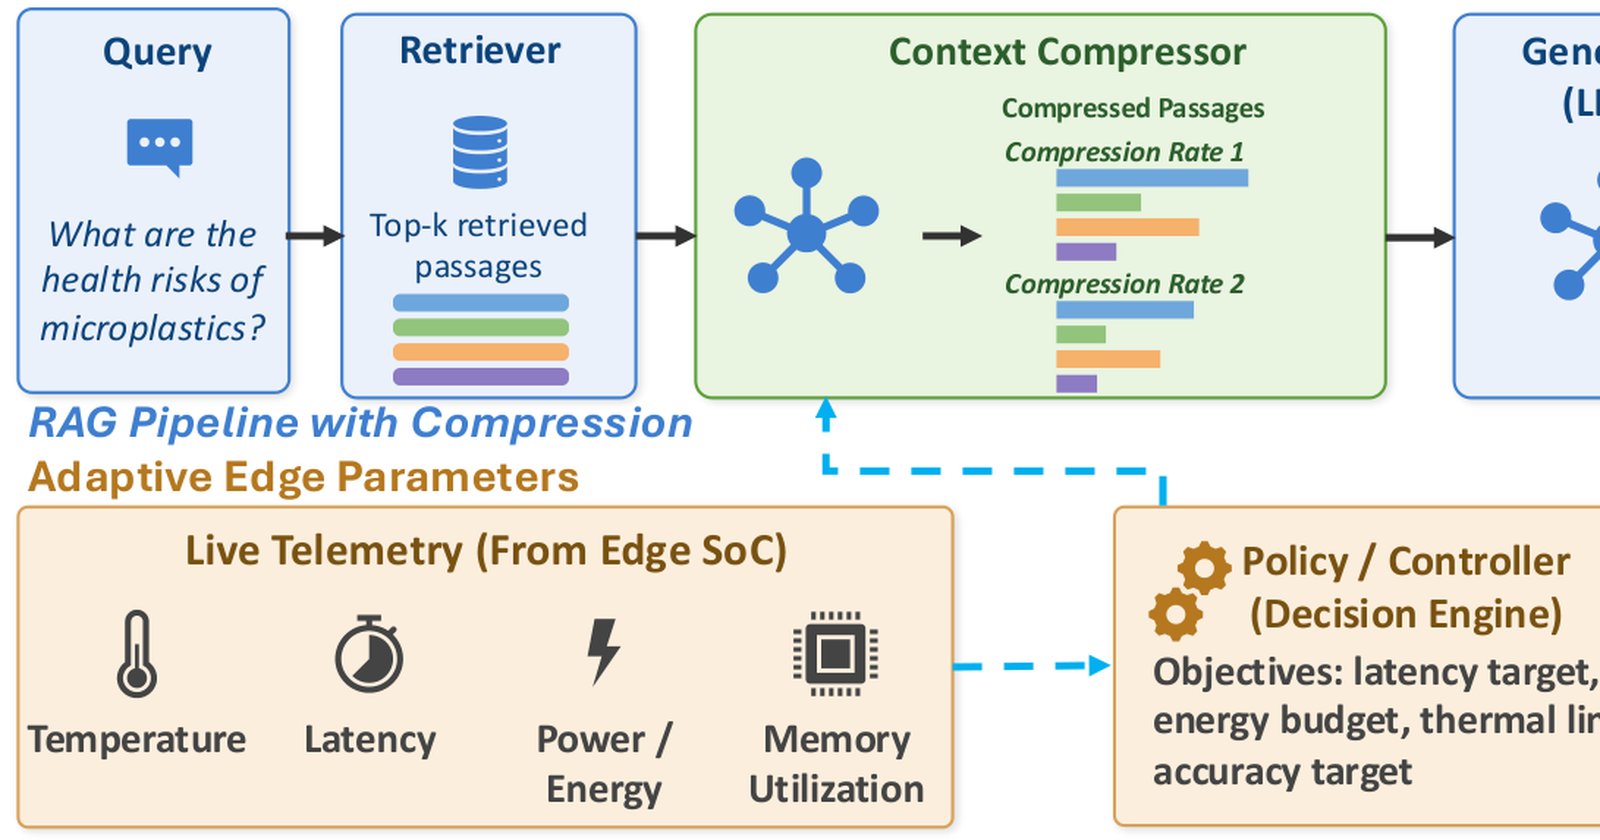
Pesquisadores publicaram um artigo na arXiv (arXiv:2608.19535v1) propondo uma nova abordagem para a compressão de contexto em sistemas RAG que operam em dispositivos de borda. O estudo caracterizou o trade-off entre compressão e desempenho usando geradores Llama e Qwen, os datasets Natural Questions e HotpotQA, e o algoritmo LLMLingua-2. Os dados experimentais foram coletados em uma placa NVIDIA Jetson AGX Thor.
Os resultados mostraram que, para modelos maiores (7-8B de parâmetros), a geração de texto domina o orçamento de RAG, correspondendo a cerca de 90% da latência por consulta e 91% do consumo de energia da GPU. A pesquisa identificou uma "região operacional adaptativa": uma compressão muito leve perde oportunidades de economia, enquanto uma compressão agressiva prejudica a qualidade. A compressão em um nível intermediário, no entanto, conseguiu reduzir o consumo de energia da GPU em até 53,2% e do SoC (System on a Chip) em até 48,2%, com perda de qualidade considerada desprezível.
Contexto
O RAG é uma técnica que melhora respostas de LLMs buscando informações em fontes externas. Esse processo, porém, aumenta o tamanho do prompt de entrada, elevando trabalho de pré-processamento (prefill), consumo de memória, latência e custo energético. A compressão de contexto — o ato de resumir os trechos recuperados antes da geração — é uma solução comum.
O problema apontado pelo estudo é que métodos estáticos aplicam uma taxa de compressão fixa, escolhida offline. Isso ignora variações na carga de trabalho e o estado em tempo real do dispositivo de borda, onde o compressor também roda no mesmo chip e consome latência e energia que podem anular as economias da geração.
Por que importa
A pesquisa impacta diretamente a viabilidade de executar modelos de IA generativa avançada em dispositivos de borda com recursos limitados — como smartphones, veículos autônomos, câmeras inteligentes ou gateways industriais. A obtenção de ganhos de eficiência de até 53% em energia de GPU é significativa para reduzir custos operacionais, prolongar a autonomia de bateria e diminuir a necessidade de resfriamento ativo em edge computing.
A abordagem adaptativa baseada em telemetria do dispositivo oferece um caminho mais inteligente que o uso de taxas fixas, potencializando o uso de hardware como o Jetson AGX Thor para aplicações de IA em tempo real e com restrições de energia.
Impacto
No curto prazo, o estudo fornece evidências experimentais que podem guiar engenheiros e desenvolvedores na otimização de stacks RAG para edge. A identificação de uma "zona intermediária" ótima de compressão simplifica a implementação prática.
No médio prazo, a adoção de políticas de compressão adaptativa pode se tornar um padrão para eficiência energética em IA edge, influenciando o design de próximos SoCs e frameworks de inferência. Empresas que desenvolvem soluções de IA para dispositivos locais podem usar esses dados para otimizar seus custos de nuvem ou tornar viáveis operações 100% no dispositivo.
O que muda
A pesquisa muda o paradigma da compressão de contexto de um controle estático e off-line para um dinâmico e em tempo real (runtime). Em vez de um "tamanho único", o sistema pode reagir a fatores como a complexidade da pergunta, a carga atual do chip e a qualidade dos trechos recuperados. Isso exige instrumentação mais sofisticada do hardware e softwares de inferência, mas promete um retorno energético mensurável.
O que vem agora
O próximo passo, conforme argumentado no paper, é o desenvolvimento e teste de políticas de runtime que gerenciem a compressão de forma adaptativa. Trabalhos futuros precisarão validar essas políticas em um espectro mais amplo de modelos, datasets e condições de hardware edge. A integração dessas técnicas em frameworks de inferência populares será crucial para sua adoção generalizada.