
Decodificação especulativa multimodal: arXiv testa drafting paralelo por difusão
Survey e estudo empírico do arXiv avaliam se técnicas como DFlash e DSpark saem dos LLMs de texto
O que aconteceu
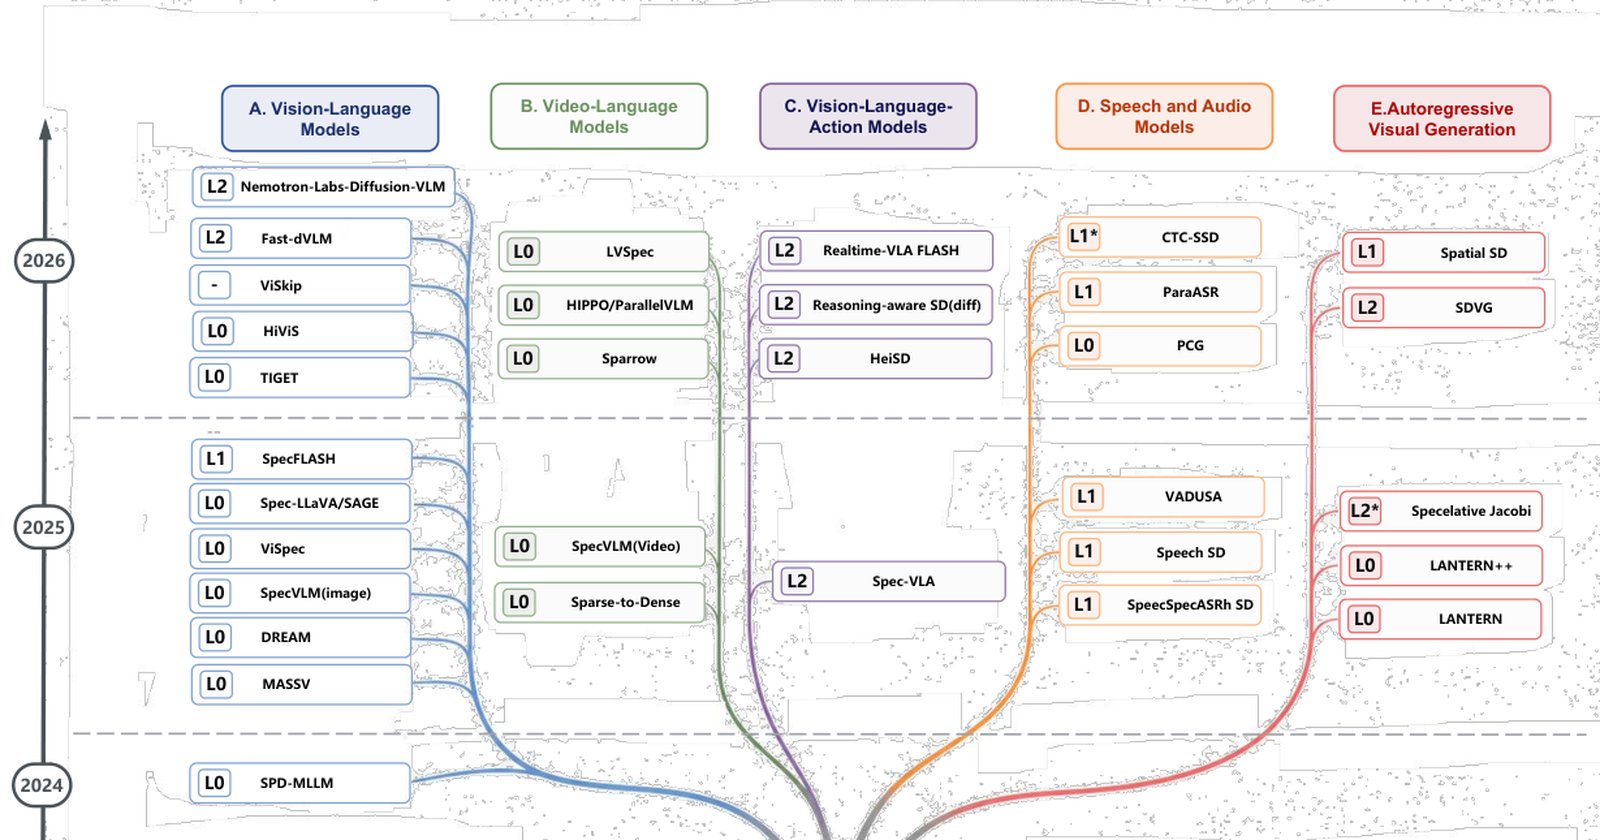
O paper "Is Multimodal Speculative Decoding Ready for Diffusion-Based Parallel Drafting? A Survey and Empirical Diagnosis" foi submetido ao arXiv em 21 de agosto de 2026, sob o identificador arXiv:2608.20743. A pesquisa combina um survey centrado em modalidade com um estudo empírico transversal para testar se técnicas de drafting paralelo baseado em difusão funcionam em modelos multimodais. DFlash e DSpark, exemplos dessa abordagem, atingem até 3,6x de aceleração em tarefas comuns de chat diário. A decodificação especulativa acelera a geração autoregressiva ao deixar um drafter leve propor tokens futuros enquanto o modelo alvo verifica em paralelo, com garantia de não perder qualidade.
Contexto
A decodificação especulativa tradicional depende de um drafter que propõe tokens e um modelo maior que valida. Em LLMs de texto, essa transição para geração paralela já é bem estudada. O paradigma mais recente é o block-parallel generative drafting, que inclui os métodos baseados em difusão. Porém, quando o alvo são modelos multimodais, a literatura se concentrou em outras frentes: compressão da entrada, alinhamento de adaptadores, cobertura de candidatos e verificação específica de modalidade. O drafting generativo em bloco, aplicado a visão-linguagem, vídeo-linguagem, áudio e visão-linguagem-ação (VLA), permanece praticamente inexplorado. É exatamente essa lacuna que o estudo do arXiv tenta medir.
Por que importa
Modelos multimodais são caros de rodar em produção. Se a aceleração de 3,6x vista em tarefas textuais não se transfere para esses sistemas, o custo de inferência e a latência continuam altos para empresas que usam OCR, resposta a perguntas visuais (VQA), raciocínio visual e geração de legendas de imagem. O paper propõe uma taxonomia unificada que separa o paralelismo do lado do drafter de escolhas ortogonais, como construção de árvore de candidatos e estratégias de verificação. Essa distinção ajuda a identificar onde exatamente o ganho de velocidade ocorre e o que falta para destravar o multimodal.
Impacto
No curto prazo, a pesquisa mostra que métodos como DFlash e DSpark não foram validados nas arquiteturas multimodais cobertas pelo estudo, que inclui OCR, VQA, raciocínio visual e image captioning. Isso significa que os ganhos teóricos ainda não têm comprovação empírica nesses cenários. No médio prazo, se os desafios abertos forem resolvidos, a indústria pode ver redução de custo e latência em sistemas que integram visão e linguagem, como assistentes com câmera ou robôs controlados por instruções (VLA). O estudo também sistematiza as limitações atuais, o que serve de roteiro para novos trabalhos.
O que vem agora
Os autores encerram com uma discussão de dificuldades e direções futuras, mas o paper não define prazos. A próxima etapa natural é validar o drafting por difusão em benchmarks multimodais padronizados e comparar os métodos existentes sob diferentes graus de paralelismo. Como o trabalho está em versão inicial no arXiv, revisões e experimentos adicionais podem surgir antes da publicação final em conferência.