
DS-Lighting padroniza automação de ciência de dados com agentes de IA
Toolkit da HKUST divide o harness em quatro camadas e integra benchmarks para comparar agentes
O que aconteceu
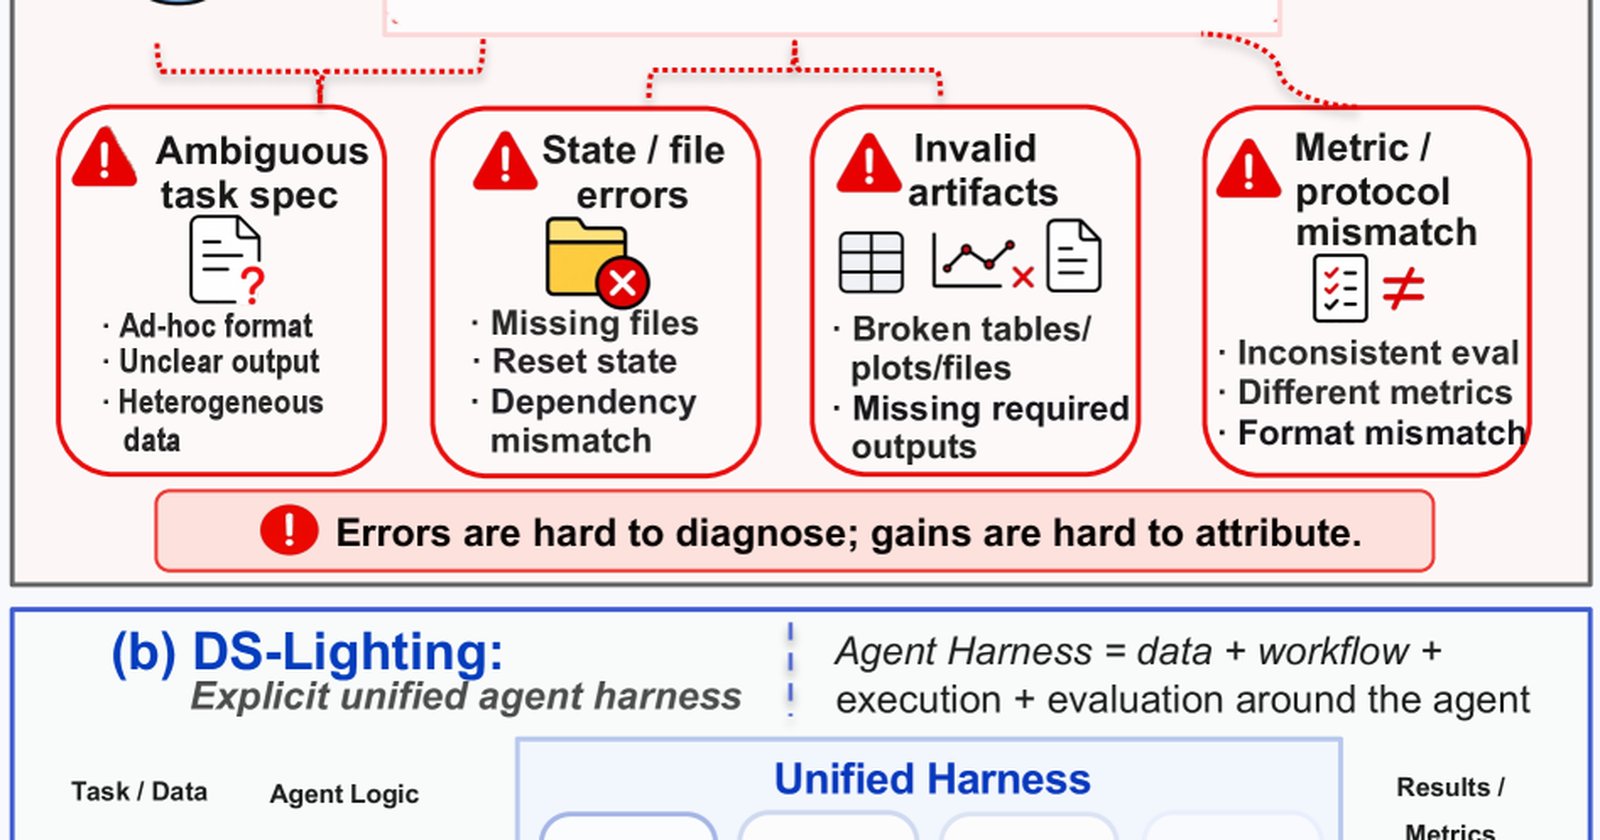
Um grupo de pesquisadores da Hong Kong University of Science and Technology (HKUST) divulgou na arXiv, em 1º de junho de 2026, o artigo DS-Lighting: Making Agent Harnesses Explicit for Data-Science Automation. O trabalho apresenta o DS-Lighting, um toolkit unificado de harness que separa o desenho em quatro camadas reutilizáveis: dados (data), fluxo de trabalho (workflow), execução (execution) e avaliação (evaluation). O código do DS-Lighting foi publicado no GitHub, no repositório usail-hkust/dslighting.
O DS-Lighting representa agentes diversos como programas operadores executáveis, que suportam tanto pipelines predefinidos quanto busca adaptativa. O toolkit também integra múltiplos benchmarks de ciência de dados em um formato de tarefa inspirado no MLE-Bench, permitindo comparação controlada sob uma interface de tarefa compartilhada, runtime em sandbox e protocolo de métricas.
O artigo, classificado como cs.AI, foi submetido à seção Computer Science > Artificial Intelligence do arXiv. De acordo com o resumo, os experimentos realizados com o DS-Lighting abrangeram agentes, harnesses, modelos e ablações, mostrando que o design explícito de harness melhora a reprodutibilidade, a comparabilidade e a confiabilidade, além de reduzir falhas sistêmicas evitáveis em fluxos de ciência de dados de ponta a ponta.
Contexto
Agentes baseados em grandes modelos de linguagem (LLMs) vêm sendo usados para automatizar tarefas de ciência de dados, mas seu desempenho de ponta a ponta depende criticamente do harness, ou seja, da camada que representa as tarefas, gerencia o estado da execução, restringe artefatos de saída e fornece feedback de avaliação. Em muitos agentes de ciência de dados existentes, o harness fica implícito, o que dificulta a reprodução, a comparação e a atribuição de resultados entre tarefas heterogêneas.
Esse problema é comum em ferramentas de automação de dados que operam como caixas-pretas. O DS-Lighting surge como uma resposta para tornar o harness explícito, permitindo que pesquisadores e engenheiros entendam exatamente como cada agente representa o problema e como as decisões de execução são tomadas.
Por que importa
Para empresas que usam IA em pipelines de dados, a falta de reprodutibilidade é um custo real. Sem um harness bem definido, dois experimentos com o mesmo agente podem produzir resultados diferentes, dificultando auditorias e validações. O DS-Lighting padroniza o ciclo de tarefa, execução e avaliação em uma única interface, o que permite comparar agentes distintos sob as mesmas condições.
Isso afeta diretamente setores como análise de mercado, pesquisa científica e engenharia de dados, onde confiabilidade e rastreabilidade são obrigatórias. A disponibilização em código aberto no GitHub reduz a barreira para adoção, já que qualquer equipe pode adaptar o toolkit ao seu fluxo.
O formato MLE-Bench-style, integrado ao DS-Lighting, segue a referência criada pela OpenAI para avaliar agentes em machine learning engineering. Ao unificar múltiplos benchmarks nesse padrão, o toolkit viabiliza comparações justas entre modelos e agentes, algo que antes exigia esforço manual de configuração.
Impacto
Em curto prazo, o DS-Lighting deve ajudar pesquisadores a identificar onde agentes falham em tarefas de dados, isolando problemas de harness de problemas de modelo. Por exemplo, ao rodar um agente de limpeza de dados com o DS-Lighting, é possível ver se o erro vem da representação da tarefa ou do mecanismo de busca.
No médio prazo, o toolkit pode se tornar um padrão de facto para avaliação de agentes de ciência de dados, similar ao que o MLE-Bench representa para ML engineering. A integração com benchmarks abertos, como os citados no artigo, também facilita a criação de leaderboards públicos e auditáveis.
A redução de falhas sistêmicas, destacada na pesquisa, tem impacto direto em ambientes de produção, onde erros de execução podem interromper pipelines inteiros. Com o harness explícito, equipes de plataforma conseguem antecipar comportamentos e estabelecer guardrails mais precisos.
O que muda
Para desenvolvedores de agentes, a principal mudança é a separação clara entre o agente em si e o harness. Em vez de embutir lógica de estado e avaliação dentro do agente, o DS-Lighting fornece essas camadas de forma plugável. Isso significa que novos agentes podem ser testados sem reescrever o harness, e vice-versa.
Para usuários finais de ferramentas de data science automatizada, a mudança aparece na forma de resultados mais confiáveis e comparáveis. Se uma empresa adotar o DS-Lighting como camada de orquestração, ela poderá trocar o modelo subjacente sem afetar a estrutura de avaliação, ou testar diferentes estratégias de busca mantendo a mesma base de dados.
O formato de "programas operadores executáveis" é outro ponto de inflexão. Ele permite que fluxos predefinidos, como um pipeline clássico de transformação, convivam com busca adaptativa, onde o agente decide o próximo passo com base em feedback parcial. Essa flexibilidade é essencial para tarefas de ciência de dados que exigem etapas não lineares.
O que vem agora
O código está disponível no repositório GitHub usail-hkust/dslighting, mas o artigo não indica uma data para lançamento de uma versão estável ou publicação em conferência. A expectativa é que o grupo continue expandindo a integração de benchmarks e publicando resultados detalhados de experimentos em domínios específicos.
Próximos passos prováveis incluem a documentação da API, exemplos de uso com agentes populares e possivelmente um pacote pip ou container Docker para facilitar a instalação. Além disso, a comunidade de pesquisa pode adotar o DS-Lighting como base para comparações em papers futuros, o que aceleraria a consolidação de um padrão de harness para ciência de dados.
Por ora, o DS-Lighting se posiciona como uma contribuição relevante para o campo de automação de dados, oferecendo uma camada de infraestrutura que muitos projetos ignoram. Sua eficácia, ainda que demonstrada no artigo, precisará ser validada em aplicações reais fora do ambiente controlado dos benchmarks.