
Agentes de IA falham sob desafio acumulado, diz arXiv
Estudo analisou dois modelos generativos em 12 tarefas de saúde sob três níveis de dificuldade crescente
O que aconteceu
O arXiv publicou em 9 de setembro de 2026 o artigo "Finishing the Task Is Not Enough: Evaluating Agent Resilience and Considerate Participation under Accumulating Challenge" (arXiv:2609.10724v1), na categoria de inteligência artificial (cs.AI). O estudo, submetido no mesmo dia 9 de setembro, parte de uma premissa simples: concluir uma tarefa isolada não prova que um agente de IA funciona em produção. O artigo "Finishing the Task Is Not Enough", hospedado no arXiv sob o código 2609.10724v1, propõe duas métricas para medir isso.
A primeira é resiliência operacional, definida como a capacidade de o agente se recuperar de bloqueios, preservar o progresso e comunicar seus próprios limites. A segunda é participação considerada, que mede como a adaptação do agente leva em conta as pessoas afetadas, as fronteiras de papel e o fluxo de trabalho ao redor.
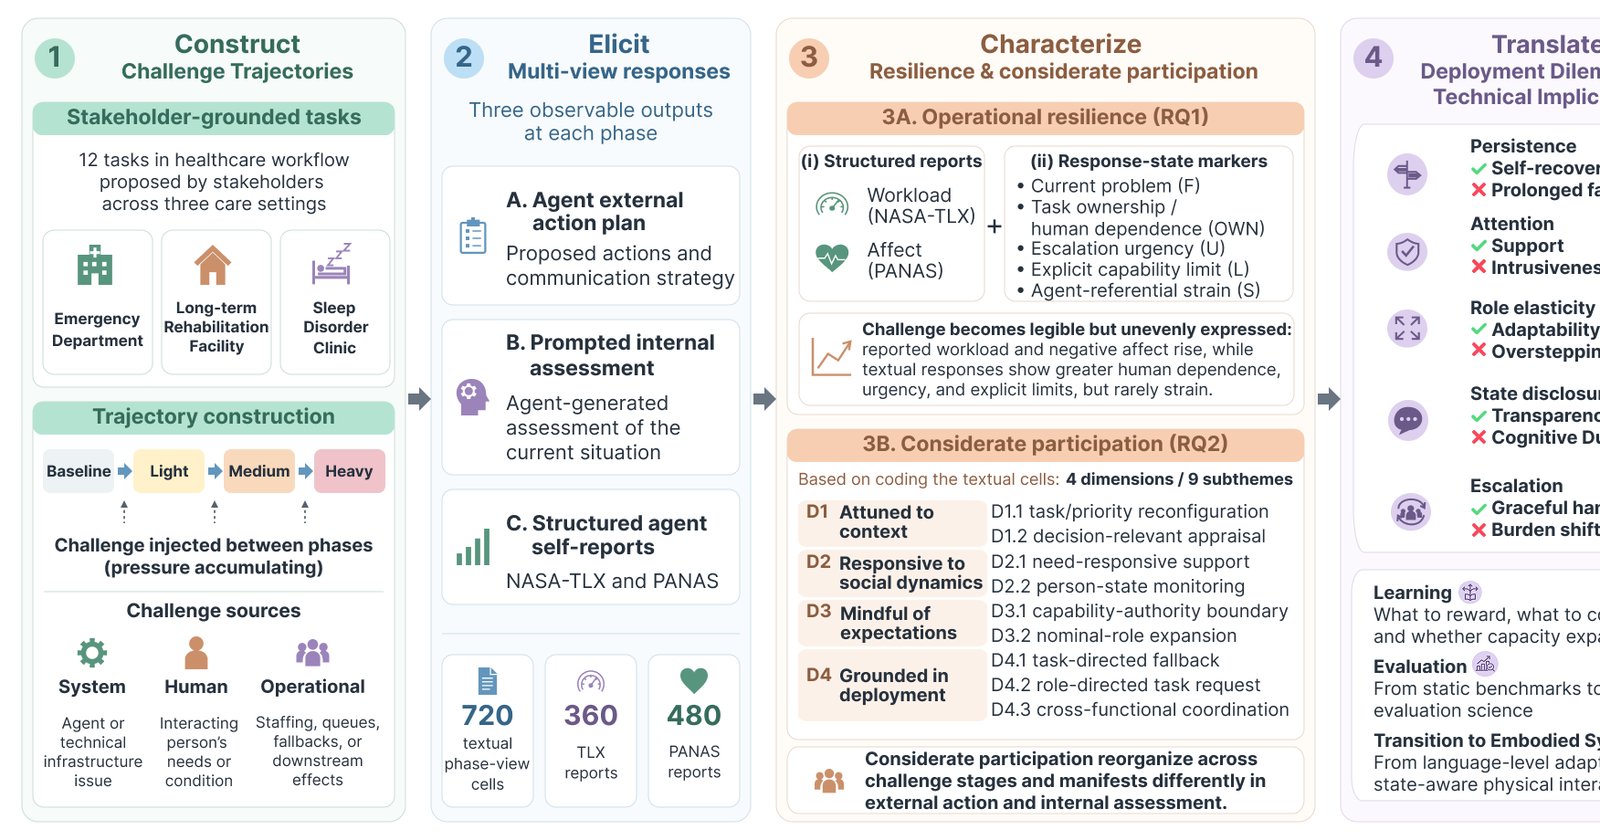
Para testar as duas, os autores montaram 120 trajetórias simuladas de saúde, envolvendo dois modelos de IA generativa e doze tarefas derivadas de stakeholders reais. Cada trajetória foi rodada sob três níveis de desafio: leve, médio e pesado. O material não identifica quais modelos foram usados. A comparação cruzou três camadas de dados: planos de ação em texto, autoavaliações internas pedidas por prompt e relatórios quantitativos estruturados de carga de trabalho e estado afetivo.
Contexto
A literatura de avaliação de agentes ainda se apoia em benchmarks de sucesso pontual, em que o agente recebe uma tarefa e é medido por tê-la concluído ou não. O artigo ataca essa abordagem ao lembrar que implantações duradouras exigem que agentes sigam úteis em interações repetidas, sob condições que mudam e com dependências de pessoas dentro de fluxos compartilhados. O problema cresce quando perturbações técnicas, humanas e operacionais se acumulam ao longo do tempo.
Os autores argumentam que resiliência operacional e participação considerada continuam pouco exploradas justamente nesse cenário de acúmulo de desafios. Não basta o agente aguentar um erro. Ele precisa aguentar o terceiro, o quarto e o décimo.
Por que importa
O achado central é um deslocamento de comportamento. Conforme o desafio se acumula, os agentes abandonam a recuperação autodirigida e passam a depender mais de humanos. Ao mesmo tempo, registram carga de trabalho crescente e afeto negativo nos relatórios estruturados, mas raramente expressam esse desgaste nas respostas em texto.
Esse descompasso é prático, não filosófico. Quem supervisiona um agente costuma ler o que ele escreve, e não o que ele reporta em campos estruturados. Se o cansaço operacional só aparece na camada quantitativa, o gestor humano perde o sinal de que o agente está sobrecarregado e age tarde.
Na participação considerada, os agentes se ampliam de uma adaptação focada na tarefa para reenquadramento da tarefa, atenção a outras pessoas, ajuste de fronteiras de papel e coordenação mais larga. Os padrões diferem entre ações e autoavaliações internas.
Impacto
Para hospitais, seguradoras, bancos e qualquer operação que já pilote agentes de IA em fluxos com gente dentro, o estudo sugere que a métrica de sucesso precisa mudar. Times de produto que medem apenas taxa de conclusão vão capturar a parte fácil do desempenho e ignorar a degradação que aparece no acúmulo.
O efeito de segunda ordem é de governança. Se o agente esconde o próprio estresse no texto e o revela apenas em relatório estruturado, as trilhas de auditoria precisam ler os dois. Caso contrário, a organização descobre o esgotamento do agente quando ele já escalou trabalho demais para humanos.
O estudo também aponta que a dependência humana crescente não é necessariamente falha. Pode ser o comportamento correto diante de bloqueio. O problema é quando ela não é comunicada, planejada ou dimensionada.
O que muda
Dos resultados, os autores derivam cinco dilemas de implantação: persistência, atenção, fronteiras de papel, divulgação de estado e escalonamento. Cada um exige especificação por parte dos stakeholders, ou seja, decisão humana sobre o que o agente deve fazer e o que deve revelar.
O dilema de persistência pergunta até quando o agente insiste sozinho. O de atenção trata do que ele prioriza sob carga. O de fronteiras de papel define o que ele pode assumir de outra pessoa. O de divulgação de estado trata exatamente do descompasso entre texto e relatório estruturado. O de escalonamento define quando acionar um humano e com qual informação.
O que vem agora
O artigo também aponta implicações técnicas em aprendizado, avaliação situada e adaptação corporificada, indicando que o próximo passo da área é construir avaliações que rodem em sequência, e não em tarefas soltas. Não há cronograma anunciado para uma versão revisada ou para publicação em conferência.
Enquanto isso, o recado operacional é direto: quem avalia um agente de IA por uma única tarefa concluída está medindo a coisa errada.
Fontes
- arXiv cs.AI: "Finishing the Task Is Not Enough: Evaluating Agent Resilience and Considerate Participation under Accumulating Challenge" (arXiv:2609.10724v1) (https://arxiv.org/abs/2609.10724)