
τ-Elicitation: benchmark mede extração de dados por agentes de voz
Com 200 tarefas, estudo mostra que o agente de texto acerta tudo e o de voz falha na recuperação de erros
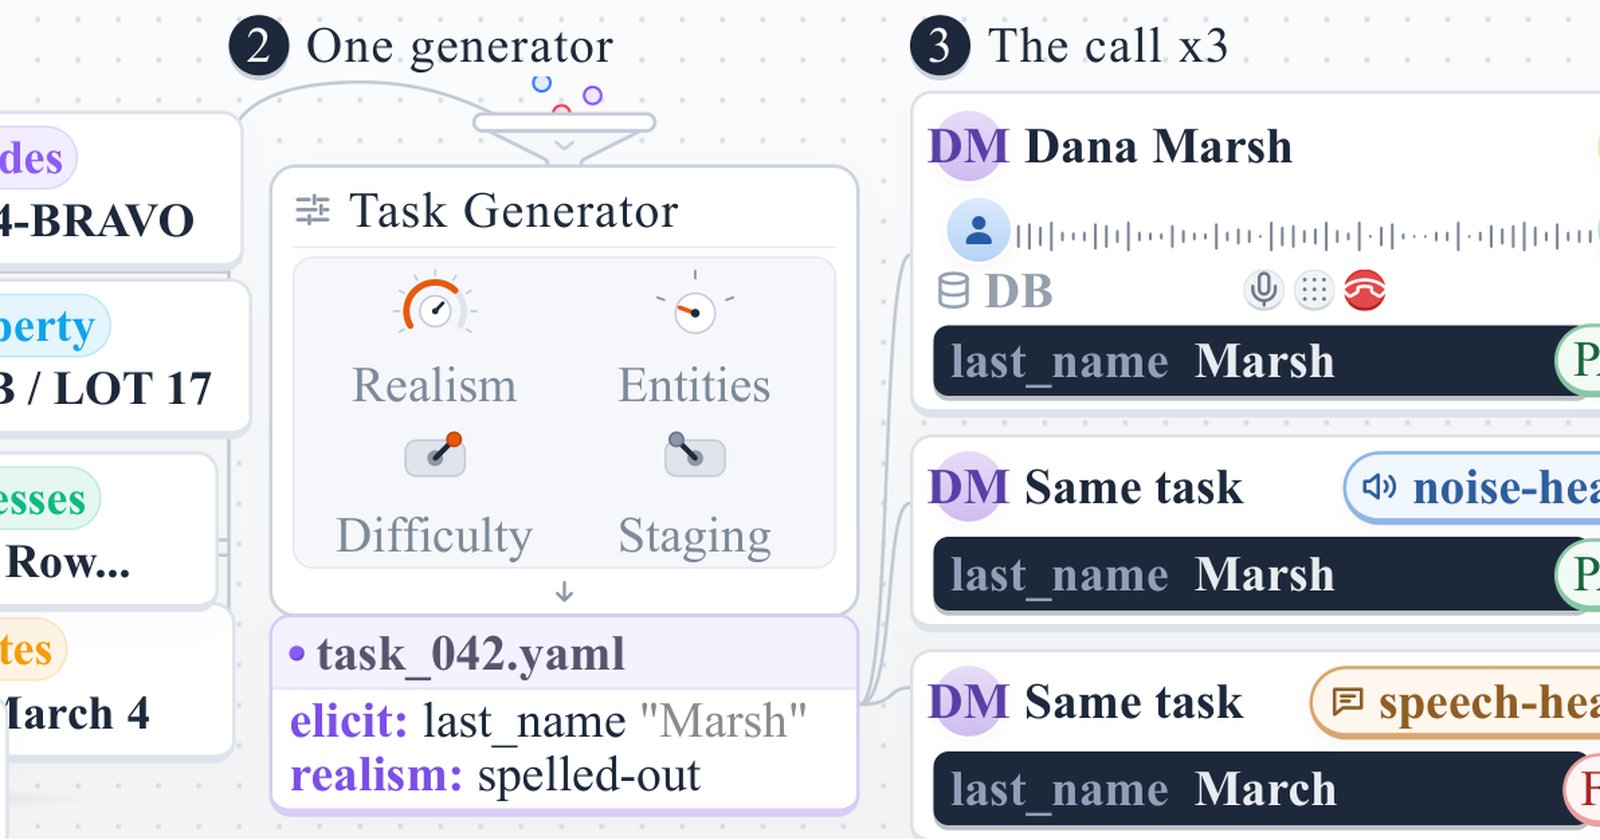
Um novo benchmark de voz mostra que agentes de IA ainda tropeçam no básico: ouvir e registrar corretamente um nome, um endereço ou um horário. O estudo τ-Elicitation, publicado no arXiv em 11 de setembro de 2026 (arXiv:2609.13602v1), mede essa etapa específica da conversa e aponta onde a captura de dados falha.
O que aconteceu
O τ-Elicitation é um benchmark de voz com 200 tarefas que cobre 10 tipos de entidades, dificuldade controlada, realismos de ligação e três ambientes distintos. Os autores do estudo identificado como arXiv:2609.13602v1 construíram o conjunto para isolar uma pergunta simples: em que ponto exato de uma conversa falada um agente perde a informação que o usuário acabou de dizer.
O contraste entre texto e voz é o dado mais duro do trabalho. Um agente de texto emparelhado passa em todas as 200 tarefas do benchmark. Quatro configurações de voz, submetidas ao mesmo conjunto, alcançam sucesso exato robusto entre 0,14 e 0,41. Na melhor das quatro configurações, o agente acerta com precisão menos da metade das vezes.
O benchmark τ-Elicitation, criado para medir extração de entidades em conversas de múltiplos turnos, separa dez tipos de entidade. Entre eles estão nomes, endereços, identificadores, datas e horários, exatamente os campos que precisam sair idênticos do outro lado da linha.
Contexto
A motivação declarada no artigo é metodológica. Benchmarks de ponta a ponta medem se a tarefa terminou bem, mas não mostram em qual turno o dado se perdeu. O τ-Elicitation foi desenhado para abrir essa caixa e localizar a falha de captura.
Para isso, o benchmark distribui as tarefas em três ambientes e injeta realismos de ligação, como variações de soletração, reinícios de fala e pronúncia errada. A ideia é reproduzir o que acontece numa chamada real, quando o interlocutor repete o próprio nome, soletra de forma inesperada ou recomeça a frase no meio.
Por que importa
O comportamento dos agentes durante a verificação é o ponto mais desconfortável do estudo. Os agentes aumentam a checagem quando a entidade é difícil ou desconhecida, e às vezes até quando capturam algo errado. Mas não fazem isso para a voz de chamador que rende o pior resultado. O sistema reforça a verificação onde já vai bem e relaxa justamente onde mais erraria.
E verificar não garante corrigir. Apenas 24% a 37% dos erros verificados são reparados. O reparo de erros verificados, portanto, acontece em no máximo pouco mais de um terço dos casos medidos no benchmark.
Impacto
Um scaffold que prescreve soletração, leitura de volta, correção e confirmação eleva o Pass³ robusto em 14 a 31 pontos. O ganho tem preço medido: de 21 a 28 segundos adicionais por chamada. Em atendimento automatizado de alto volume, esse custo por ligação é a decisão central de projeto.
Nem todo realismo pesa igual. Variações de soletração e reinícios não afetam de forma detectável o sucesso exato no τ-Elicitation. Já a pronúncia errada aumenta o esforço de reparo, o que empurra o problema para a etapa de recuperação e não para a de escuta.
O que muda
Os resultados apontam dois gargalos centrais na coleta exata de entidades faladas: a seleção de estratégia e a recuperação bem-sucedida. Não é a acústica nem a transcrição bruta que derruba o desempenho, segundo o estudo. É a decisão do agente sobre quando pedir confirmação, quando soletrar de volta e o que fazer depois de detectar um erro.
Para quem constrói agentes de voz, isso desloca a métrica. Medir apenas se a ligação terminou não basta. O τ-Elicitation sugere medir por tipo de entidade e por perfil de voz de quem liga, porque o desempenho varia entre configurações de voz e entre chamadores.
O que vem agora
O artigo está publicado no arXiv com PDF e uma versão HTML experimental, sob o identificador arXiv:2609.13602v1, submetido em 11 de setembro de 2026. O benchmark τ-Elicitation fica disponível para que outras equipes reproduzam as 200 tarefas e comparem configurações de voz.
O caminho esperado é a adoção do conjunto como métrica de avaliação de agentes de voz e o ajuste de scaffolds de confirmação, com atenção ao custo de 21 a 28 segundos por chamada. Os próprios resultados indicam onde investir: estratégia e recuperação de erro, não apenas qualidade de transcrição.
Fontes
- arXiv cs.AI: τ-Elicitation: Benchmarking multi-turn entity extraction in voice agents (https://arxiv.org/abs/2609.13602)