
ERPBench: benchmark testa agentes de IA em decisões empresariais
Estudo no arXiv mostra que rankings de agentes de IA mudam conforme a ecologia competitiva do mercado simulado
O que aconteceu
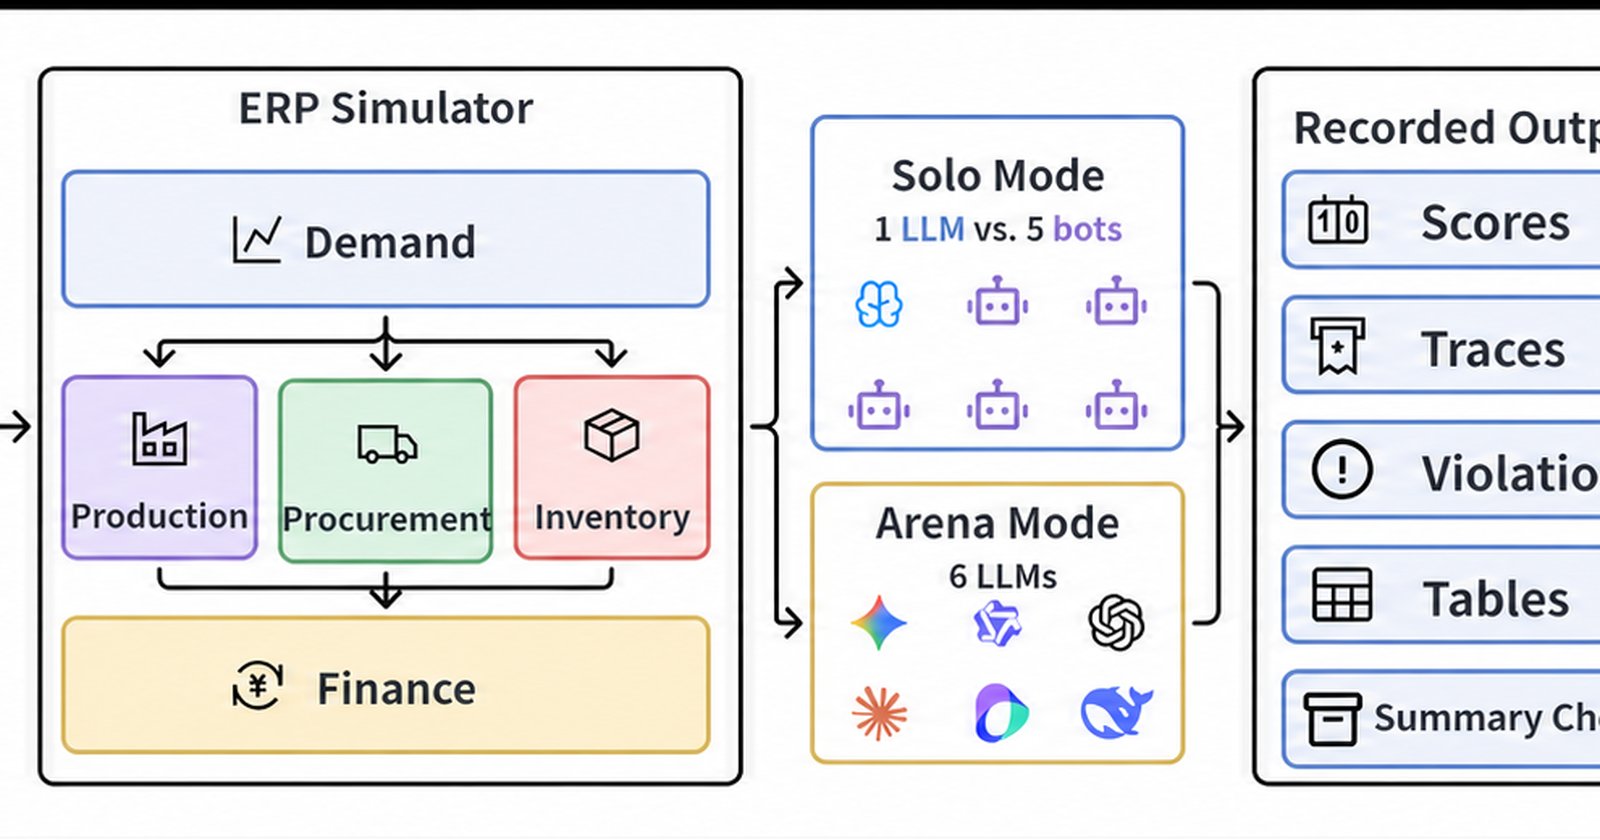
Um grupo de pesquisadores publicou no arXiv, em 4 de setembro de 2026, o artigo "ERPBench: Evaluating LLM Agents for Enterprise Decision-Making Across Competitive Market Ecologies" (arXiv:2609.04667). O ERPBench é um benchmark instrumentado para execução que avalia agentes baseados em LLM (large language model, ou modelo de linguagem de grande porte) em decisões empresariais dentro de uma simulação de Enterprise Resource Planning (ERP) com seis rodadas.
A simulação acopla preços, produção, compras, estoque, finanças e competição em um mercado compartilhado. O ERPBench avalia os mesmos 100 problemas fixos em duas ecologias competitivas equivalentes: Solo, em que cada agente avaliado compete contra oponentes fixos baseados em regras, e Arena, em que seis agentes avaliados por LLM competem entre si no mesmo mercado. O código e os recursos do benchmark estão disponíveis no GitHub, no repositório GAIR-NLP/erp-bench.
Contexto
Agentes de IA baseados em LLM são cada vez mais propostos para fluxos de trabalho corporativos. O problema, segundo os autores, é que as avaliações existentes raramente testam se as conclusões de decisões de negócio se transferem entre ecologias competitivas de mercado diferentes. Ou seja: um agente que parece bom quando testado isolado pode se comportar de outra forma quando disputa o mesmo mercado com outros agentes de IA.
O ERPBench foi desenhado justamente para responder essa pergunta com avaliação pareada. Ao rodar os mesmos 100 problemas nas duas ecologias, o benchmark permite comparar se os rankings de agentes empresariais se mantêm quando o ambiente competitivo muda.
Por que importa
Os números mostram que a resposta é não, os rankings não se transferem. Sob a configuração de serviço observada, o modelo líder muda conforme a ecologia. DeepSeek lidera no Solo, com avaliação média de 252,29 milhões e rank médio de 1,67. Gemini lidera na Arena, com 263,95 milhões e rank médio de 1,76.
O dado mais contundente: as duas ecologias identificam o mesmo vencedor no nível de tarefa em apenas 21 dos 100 problemas. Isso significa que, em quase 80% dos casos, escolher um agente de IA para decisões empresariais com base em um único ambiente de teste pode levar à escolha errada.
Impacto
O comportamento dos modelos varia de forma expressiva conforme a concorrência. A taxa de últimas colocações do Gemini cai de 22% no Solo para 0% na Arena. Em outras palavras, o modelo da Google, que frequentemente fica em último quando disputa contra oponentes baseados em regras, nunca fica em último quando compete contra outros agentes de LLM no mercado compartilhado.
No total, o estudo gerou 1.200 trajetórias no nível de modelo, distribuídas em seis famílias de modelos, cobrindo 7.200 rodadas de decisão. Esse volume permite análises agregadas de intervenção de execução, além da avaliação pareada entre ecologias.
Para empresas, a mensagem é prática: benchmarks tradicionais de LLM, focados em tarefas isoladas, não capturam o desempenho de agentes em mercados competitivos reais, onde o resultado de uma decisão depende do que os concorrentes fazem ao mesmo tempo.
O que muda
O ERPBench estabelece um padrão novo para avaliação de agentes corporativos: testar o mesmo problema em ambientes competitivos distintos e medir se o ranking se mantém. A ecologia Arena, com seis agentes de LLM disputando o mesmo mercado, aproxima a avaliação de condições reais de concorrência entre empresas que adotam IA em suas operações.
O que vem agora
O benchmark e o código estão abertos no GitHub (GAIR-NLP/erp-bench), o que permite que outras equipes repliquem os testes, ampliem a lista de modelos avaliados e explorem as análises de intervenção de execução. A expectativa é que avaliações pareadas como essa se tornem referência para empresas que precisam decidir qual agente de IA adotar em operações de pricing, produção e compras.