
Erro de predição não basta para avaliar estimativas causais, aponta estudo
Pesquisa do arXiv mostra que métrica clássica não reflete viés causal e alerta para uso de cobertura de intervalo de confiança.
O que aconteceu
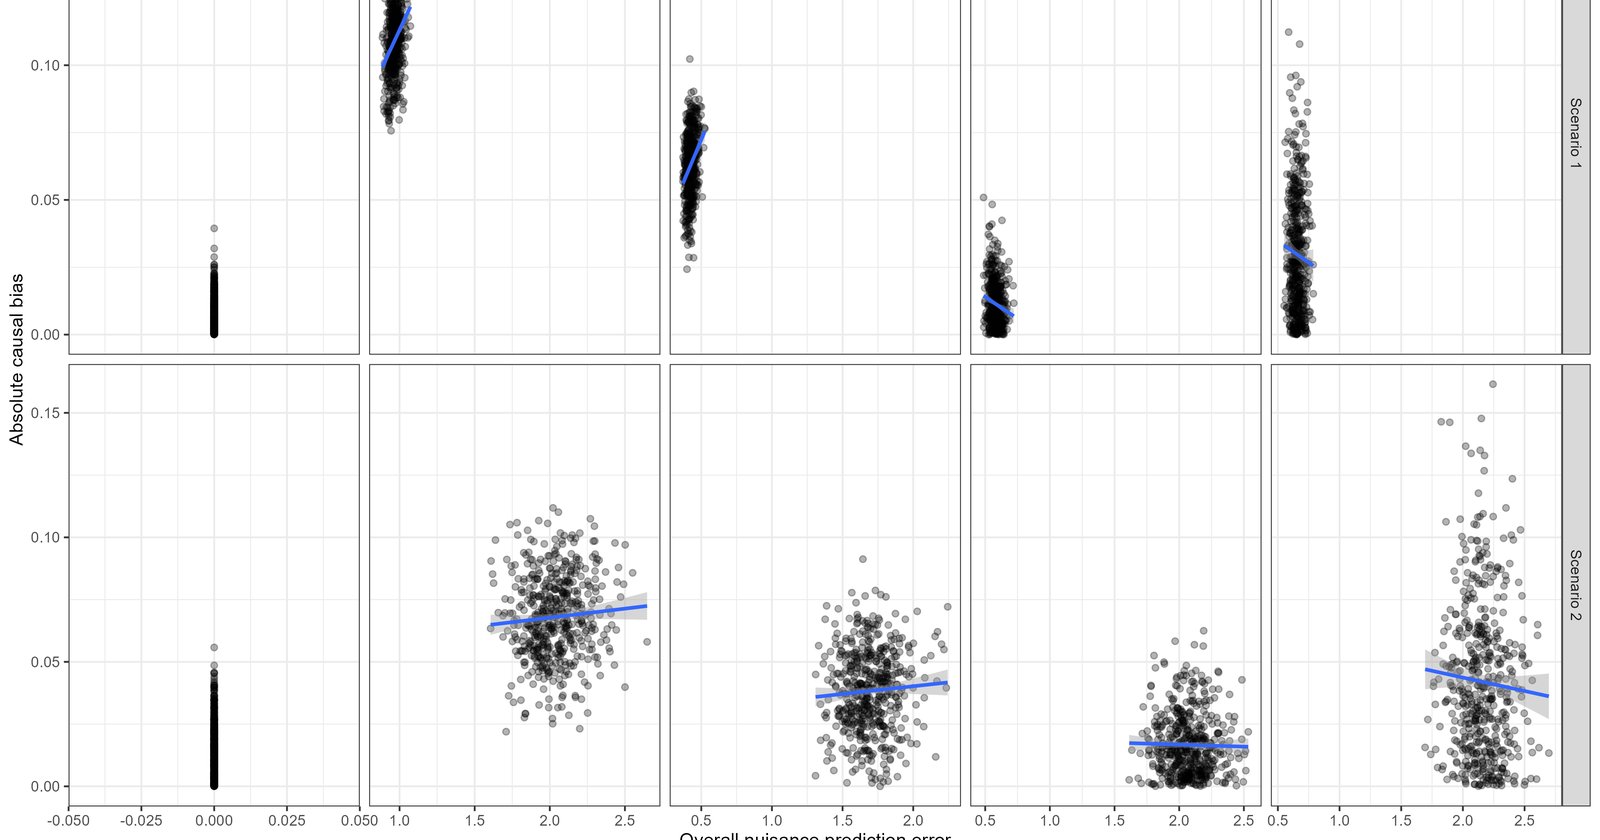
Pesquisadores submetidos ao arXiv (identificador 2609.00071) analisaram se o erro de predição, amplamente usado para avaliar estimadores de funções de perturbação (nuisance functions), realmente reflete a qualidade da estimativa causal final. Por meio de simulações de Monte Carlo em um modelo parcialmente linear, a equipe comparou quatro métodos: mínimos quadrados ordinários (OLS), modelos aditivos generalizados (GAMs), XGBoost e Double Machine Learning com XGBoost (DML-XGBoost). Os resultados, reportados no resumo do artigo, mostram que XGBoost obteve o menor RMSE entre os métodos não-oráculo, enquanto DML-XGBoost apresentou melhor cobertura de intervalo de confiança de 95%. No entanto, o erro de predição não acompanhou consistentemente o viés causal entre os métodos e cenários, e a medida conjunta de erro, baseada no produto cruzado absoluto dos erros das funções de exposição e desfecho, mostrou associação fraca com o viés causal.
Contexto
Na inferência causal, funções de perturbação são modelos auxiliares usados para ajustar variáveis de confusão, como a probabilidade de exposição ou a expectativa do desfecho. Tradicionalmente, pesquisadores avaliam esses modelos por métricas de predição, como erro quadrático médio. Porém, a relação entre esse erro e o desempenho do estimador causal final é pouco compreendida. O estudo, submetido na área de Inteligência Artificial (cs.AI), aborda essa lacuna em um cenário controlado, com simulações que variam as condições de estimação. A escolha de métodos como OLS e GAMs representa abordagens clássicas, enquanto XGBoost e DML-XGBoost são técnicas modernas de aprendizado de máquina, cada uma com propriedades distintas de viés e variância.
Por que importa
Para pesquisadores e profissionais que usam inferência causal em áreas como economia, epidemiologia e ciência de dados, a descoberta tem implicações práticas imediatas. Se o erro de predição não é um bom proxy para o viés causal, decisões baseadas nessa métrica podem levar à escolha de modelos com estimativas pontuais enganosas. O estudo sugere que a cobertura do intervalo de confiança, que indica se o intervalo contém o valor verdadeiro do parâmetro, é uma medida mais confiável, especialmente quando o objetivo é fazer inferência. Isso é particularmente relevante para DML-XGBoost, que, apesar de não ter o menor RMSE, oferece melhor cobertura, um aspecto crítico para a validade estatística de conclusões causais.
Impacto
Em curto prazo, o artigo deve provocar uma revisão de práticas comuns em pipelines de estimação causal. Métodos que otimizam apenas o erro de predição das funções de perturbação, sem considerar a cobertura do intervalo de confiança, podem produzir resultados com viés não detectado. A pesquisa também mostra que a medida conjunta de erro, proposta como alternativa simples, não é suficiente para avaliar o desempenho causal. Isso indica que métricas mais sofisticadas, ou combinações de métricas, são necessárias. No médio prazo, a comunidade de inferência causal pode passar a adotar protocolos de avaliação que incluam múltiplos critérios, como viés, RMSE e cobertura, em vez de confiar em um único número.
O que muda
Na prática, quem desenvolve estimadores causais deve repensar a validação de modelos auxiliares. A recomendação implícita do estudo é que, ao escolher entre métodos como XGBoost e DML-XGBoost, o pesquisador priorize a cobertura do intervalo de confiança quando o objetivo for inferência, mesmo que isso signifique aceitar um RMSE maior. Para cenários onde a precisão pontual é o foco, o RMSE ainda tem valor, mas não deve ser interpretado como garantia de baixo viés causal. O estudo também abre espaço para o desenvolvimento de novas métricas de avaliação que capturem melhor a relação entre funções de perturbação e estimadores causais.
O que vem agora
Os autores não anunciam próximos passos no resumo, mas é esperado que o estudo seja expandido para outros modelos estruturais e cenários de dados reais. A pesquisa pode estimular trabalhos que proponham métodos de seleção de modelos baseados em cobertura de intervalo, ou que desenvolvam medidas de erro conjunto mais eficazes. Além disso, a comunidade de aprendizado de máquina pode integrar essas descobertas em bibliotecas de Double Machine Learning, como o pacote DoubleML, para fornecer métricas de avaliação mais completas. O artigo, disponível no arXiv com o ID 2609.00071, já serve como referência para quem busca entender os limites do erro de predição na estimação causal.