
Estudo: Auto-correção por incerteza piora desempenho de LLMs para código
Nova pesquisa mostrou que métodos baratos para medir 'dúvida' da IA não melhoram código e podem até degradá-lo.
O que aconteceu
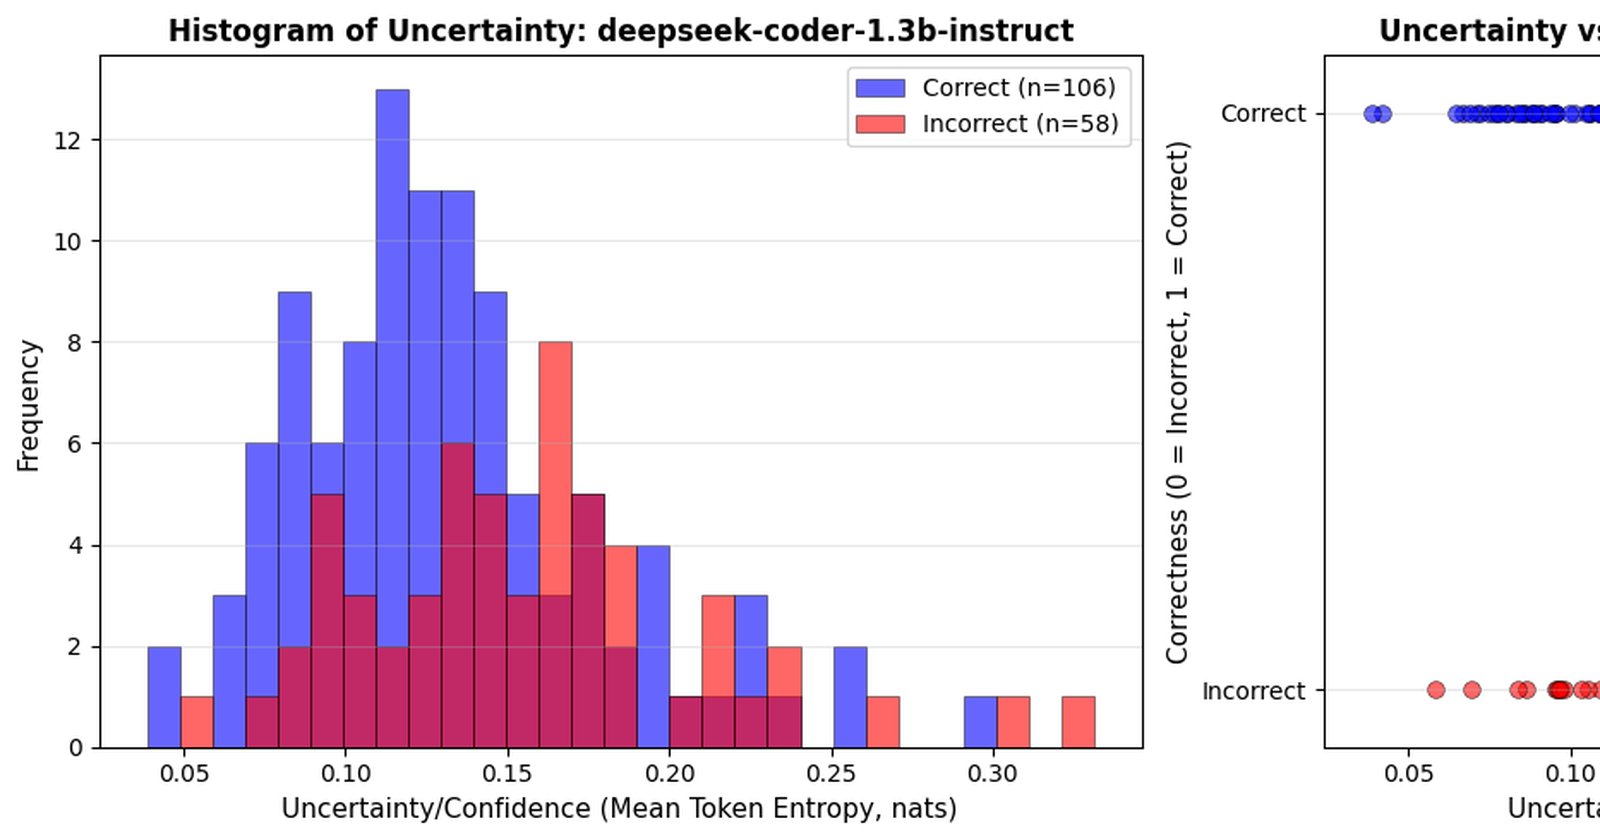
Pesquisadores avaliaram cinco métodos para estimar a incerteza (ou 'dúvida') de LLMs pequenas focadas em geração de código. Os métodos testados incluíram entropia média de tokens, confiança verbalizada, P(True), conjuntos de entropia e sondas de entropia semântica (arXiv, 2026).
Esses sinais de incerteza foram então usados para acionar três políticas de autocorreção: decodificação adaptativa, regeneração baseada em incerteza e regeneração baseada em verificação. Os experimentos foram conduzidos nos benchmarks HumanEval e BigCodeBench.
O resultado principal foi negativo: a autocorreção baseada em incerteza degradou a métrica Pass@1 (acerto na primeira tentativa) em 5 das 6 configurações testadas, com perdas de 3 a 10 pontos percentuais. A decodificação adaptativa também piorou o desempenho em 4 de 6 cenários. Apenas a verificação baseada em execução (executar e testar o código) melhorou a precisão, com ganhos de 6 a 26 pontos percentuais no HumanEval e de 8 a 20 no BigCodeBench.
Contexto
LLMs para código frequentemente geram soluções incorretas sem indicar claramente que estão com problemas. Uma ideia lógica seria usar métodos de estimação de incerteza (desenvolvidos para linguagem natural) para que a modelo possa 'perceber' quando pode estar errado e tentar corrigir-se.
O estudo investiga se esses métodos baratos e rápidos de estimar incerteza funcionam para código, uma tarefa com verificação objetiva (o código compila e passa em testes?). A pesquisa visa preencher essa lacuna entre a geração de código e a capacidade da própria IA de avaliar sua saída.
Por que importa
Para desenvolvedores e empresas que integram LLMs em ferramentas de programação, o estudo traz um alerta prático: não basta usar métodos simples de detecção de 'insegurança' da IA para melhorar a qualidade do código.
A descobora indica que investir em pipelines de verificação (que executam o código gerado) é muito mais eficaz do que tentar usar sinais probabilísticos como substituto barato. Isso tem implicações diretas para o custo e a arquitetura de sistemas de IA para desenvolvimento de software.
Impacto
No curto prazo, empresas podem revisar estratégias de integração de LLMs para código, focando menos em autoavaliação da modelo e mais em validação externa. A pesquisa também desestima a viabilidade de soluções 'baratas' para o problema da incorreção em geração de código.
No médio prazo, isso pode acelerar o desenvolvimento de sistemas de verificação mais robustos e integrados, que usam execução real como árbitro final, em vez da 'opinião' probabilística da própria LLM.
O que muda
O estudo sugere que o valor prático dos estimadores de incerteza baratos está em servir como um 'gatekeeper' para acionar correções mais custosas, não como uma solução completa. Uma abordagem eficaz seria: usar a incerteza para decidir *quando* verificar o código (executar e testar), e não *como* corrigi-lo.
Isso pode redesenhar o fluxo de trabalho em ferramentas de copiloto, onde a verificação por execução seria acionada seletivamente, otimizando o uso de recursos computacionais.
O que vem agora
Próximos passos lógicos incluem a investigação de modelos maiores para verificar se o fenômeno persiste, e o desenvolvimento de métodos de verificação baseada em execução mais eficientes. A pesquisa também abre espaço para estudos sobre como combinar melhor os sinais de incerteza com algoritmos de verificação.